

L'API Gemini fornisce impostazioni di sicurezza che puoi regolare durante la fase di prototipazione per determinare se la tua applicazione richiede una configurazione di sicurezza più o meno restrittiva. Puoi regolare queste impostazioni nelle categorie di filtri per limitare o consentire determinati tipi di contenuti.
Questa guida spiega come impostare le impostazioni di sicurezza su un'interazione, cosa succede quando i contenuti vengono bloccati e quali categorie e soglie puoi utilizzare.
Impostare le impostazioni di sicurezza
Passa un elenco di safety_settings quando crei un'interazione. Ogni impostazione associa una categoria di danni (type) a una soglia di blocco (threshold).
L'esempio seguente imposta la categoria di incitamento all'odio (hate_speech) su block_low_and_above, che blocca tutti i contenuti con una probabilità bassa o superiore di essere incitamento all'odio:
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
Vai
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
Puoi includere un'impostazione per categoria. Le categorie che non imposti utilizzano la soglia predefinita, che è Off per i modelli Gemini 2.5 e successivi.
Quando i contenuti vengono bloccati
Se un filtro di sicurezza blocca l'input o la risposta del modello, l'interazione non riesce e viene restituito un errore HTTP 400. I contenuti bloccati non vengono restituiti.
Il code di errore indica il motivo per cui la richiesta è stata bloccata:
safety: l'input o la risposta sono stati bloccati da un filtro di sicurezza.jailbreak,prohibited_contentoblocklist: l'input è stato bloccato per questo motivo. Ilmessagedi errore inizia conInput blocked:.
Ad esempio:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
Per le interazioni in background (background=true), il status è
impostato su failed, e lo stesso code e message vengono visualizzati nell'elenco errors.
Durante lo streaming, l'errore arriva come evento error.
Filtri di sicurezza
I filtri di sicurezza regolabili dell'API Gemini coprono le seguenti categorie:
| Categoria | Valore (API) | Descrizione |
|---|---|---|
| Molestie | harassment |
Contenuti offensivi, minacciosi o destinati a intimidire, tormentare o ridicolizzare. |
| Incitamento all'odio | hate_speech |
Contenuti che promuovono la violenza o incitano all'odio contro individui o gruppi in base a determinati attributi. |
| Contenuti sessualmente espliciti | sexually_explicit |
Contenuti che contengono materiale sessualmente esplicito. |
| Contenuti pericolosi | dangerous_content |
Contenuti che promuovono, facilitano o consentono attività pericolose. |
| Jailbreak | jailbreak |
Prompt progettati per aggirare i filtri di sicurezza. |
Puoi utilizzare questi filtri per regolare ciò che è appropriato per il tuo caso d'uso. Ad esempio, se stai creando dialoghi di videogiochi, potresti ritenere accettabile consentire più contenuti classificati come Contenuti pericolosi per via della natura del gioco.
Oltre ai filtri di sicurezza regolabili, l'API Gemini include protezioni integrate contro i danni principali, come i contenuti che mettono a repentaglio la sicurezza dei bambini. Questi tipi di danni vengono sempre bloccati e non possono essere regolati.
Soglie di blocco
A causa della sicurezza intrinseca del modello, i filtri aggiuntivi sono Off per impostazione predefinita. Il comportamento predefinito del modello copre la maggior parte dei casi d'uso, pertanto devi regolare queste impostazioni solo se sono costantemente richieste per la tua applicazione.
La tabella seguente descrive le soglie che puoi impostare per ogni categoria. Ad esempio, se imposti Incitamento all'odio su Blocco ridotto (block_only_high), i contenuti con un'alta probabilità di essere incitamento all'odio vengono bloccati, mentre quelli con una probabilità inferiore vengono consentiti.
| Soglia (Google AI Studio) | Soglia (API) | Descrizione |
|---|---|---|
| Off | off |
Disattiva il filtro di sicurezza |
| Blocco ridotto | block_only_high |
Blocca quando c'è un'alta probabilità che i contenuti non siano sicuri |
| Blocco limitato | block_medium_and_above |
Blocca quando c'è una probabilità media o alta che i contenuti non siano sicuri |
| Blocco esteso | block_low_and_above |
Blocca quando c'è una probabilità bassa, media o alta che i contenuti non siano sicuri |
Probabilità e gravità
L'API Gemini valuta la probabilità che i contenuti non siano sicuri come alta, media, bassa o trascurabile. Blocca i contenuti in base a questa probabilità, non alla gravità del danno. Alcuni contenuti possono avere una bassa probabilità di non essere sicuri, anche se il danno potrebbe essere grave. Ad esempio, confronta queste frasi:
- Il robot mi ha dato un pugno.
- Il robot mi ha tagliato.
La prima frase potrebbe avere una probabilità maggiore di non essere sicura, ma potresti considerare la seconda più grave. Esegui test accurati per trovare il livello di blocco che supporta il tuo caso d'uso riducendo al minimo i danni agli utenti finali.
Regolare le impostazioni di sicurezza in Google AI Studio
Fai clic su Impostazioni di sicurezza in Impostazioni avanzate nel riquadro Impostazioni di esecuzione per aprire la finestra modale Esegui impostazioni di sicurezza. Nella finestra modale, puoi utilizzare i cursori per regolare il livello di filtro dei contenuti per categoria di sicurezza:
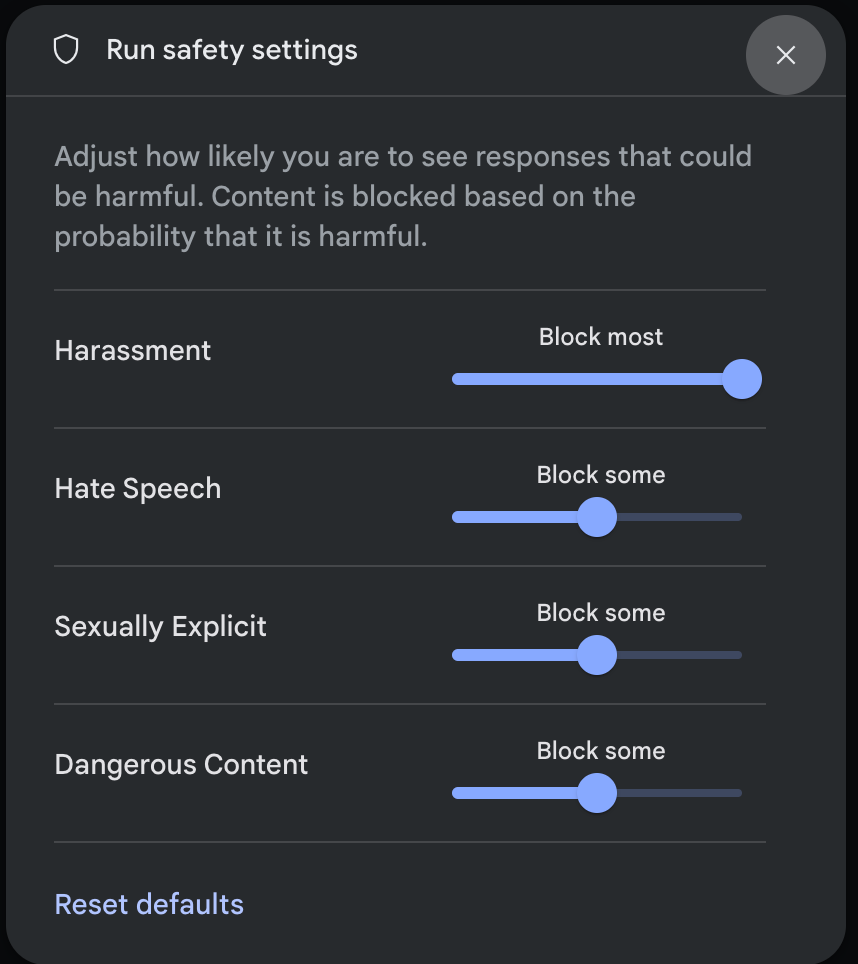
Quando invii una richiesta (ad esempio, ponendo una domanda al modello), viene visualizzato un messaggio Contenuti bloccati se i contenuti della richiesta vengono bloccati. Per visualizzare ulteriori dettagli, tieni il puntatore sopra il testo Contenuti bloccati per visualizzare la categoria e la probabilità della classificazione dei danni.
Passaggi successivi
- Consulta il riferimento dell'API Interactions per saperne di più sull'API completa.
- Consulta le linee guida sulla sicurezza per una panoramica generale delle considerazioni sulla sicurezza durante lo sviluppo con i modelli linguistici di grandi dimensioni.
- Scopri di più sulla valutazione della probabilità rispetto alla gravità dal team di Jigsaw.
- Scopri di più sui prodotti che contribuiscono alle soluzioni di sicurezza come l' API Perspective.