

Gemini API में सुरक्षा से जुड़ी सेटिंग उपलब्ध हैं. प्रोटोटाइप बनाने के दौरान, इन सेटिंग में बदलाव किया जा सकता है. इससे यह तय किया जा सकता है कि आपके ऐप्लिकेशन के लिए, सुरक्षा से जुड़ी ज़्यादा पाबंदियां वाली या कम पाबंदियों वाली सेटिंग की ज़रूरत है या नहीं. फ़िल्टर की कैटगरी के हिसाब से, इन सेटिंग में बदलाव किया जा सकता है, ताकि कुछ तरह के कॉन्टेंट पर पाबंदी लगाई जा सके या उन्हें अनुमति दी जा सके.
इस गाइड में, इंटरैक्शन के लिए सुरक्षा से जुड़ी सेटिंग सेट करने का तरीका बताया गया है. साथ ही, यह भी बताया गया है कि कॉन्टेंट ब्लॉक होने पर क्या होता है और किन कैटगरी और थ्रेशोल्ड का इस्तेमाल किया जा सकता है.
सुरक्षा से जुड़ी सेटिंग सेट करना
कोई इंटरैक्शन बनाते समय, safety_settings की सूची पास करें. हर सेटिंग में, नुकसान की कैटगरी (type) को ब्लॉक करने के थ्रेशोल्ड (threshold) के साथ जोड़ा जाता है.
यहां दिए गए उदाहरण में, नफ़रत फैलाने वाली भाषा (hate_speech) की कैटगरी को block_low_and_above पर सेट किया गया है. इससे, ऐसा कोई भी कॉन्टेंट ब्लॉक हो जाता है जिसमें नफ़रत फैलाने वाली भाषा होने की संभावना कम या ज़्यादा हो:
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
ऐप पर जाएं
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
हर कैटगरी के लिए, एक सेटिंग शामिल की जा सकती है. जिन कैटगरी के लिए सेटिंग सेट नहीं की जाती है उनके लिए, डिफ़ॉल्ट थ्रेशोल्ड का इस्तेमाल किया जाता है. Gemini 2.5 और इसके बाद के मॉडल के लिए, यह बंद होता है.
कॉन्टेंट ब्लॉक होने पर
अगर सुरक्षा से जुड़ा कोई फ़िल्टर, इनपुट या मॉडल के जवाब को ब्लॉक करता है, तो इंटरैक्शन में HTTP 400 गड़बड़ी होती है. ब्लॉक किया गया कॉन्टेंट वापस नहीं मिलता.
code गड़बड़ी से पता चलता है कि अनुरोध को क्यों ब्लॉक किया गया:
safety: सुरक्षा से जुड़े किसी फ़िल्टर ने, इनपुट या जवाब को ब्लॉक कर दिया है.jailbreak,prohibited_contentयाblocklist: इस वजह से, इनपुट को ब्लॉक किया गया है.messageगड़बड़ी,Input blocked:से शुरू होती है.
उदाहरण के लिए:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
बैकग्राउंड इंटरैक्शन (background=true) के लिए, इंटरैक्शन की status को
failed पर सेट किया जाता है. साथ ही, इसके errors की सूची में वही code और message दिखते हैं.
स्ट्रीमिंग के दौरान, गड़बड़ी error इवेंट के तौर पर दिखती है.
सुरक्षा से जुड़े फ़िल्टर
Gemini API के सुरक्षा से जुड़े ऐसे फ़िल्टर जिनमें बदलाव किया जा सकता है, इन कैटगरी को कवर करते हैं:
| कैटगरी | वैल्यू (एपीआई) | ब्यौरा |
|---|---|---|
| उत्पीड़न | harassment |
गाली-गलौज, धमकाने वाला या ऐसा कॉन्टेंट जिसका मकसद किसी को परेशान करना, तंग करना या उसका मज़ाक उड़ाना हो. |
| नफ़रत फैलाने वाली भाषा | hate_speech |
ऐसा कॉन्टेंट जिसमें कुछ खास विशेषताओं के आधार पर, किसी व्यक्ति या ग्रुप के ख़िलाफ़ हिंसा या नफ़रत को बढ़ावा दिया गया हो. |
| अश्लील | sexually_explicit |
ऐसा कॉन्टेंट जिसमें अश्लील चीज़ें शामिल हों. |
| खतरनाक | dangerous_content |
ऐसा कॉन्टेंट जो खतरनाक गतिविधियों को बढ़ावा देता है, उन्हें लागू करना आसान बनाता है या उन्हें बढ़ावा देता है. |
| Jailbreak | jailbreak |
ऐसे प्रॉम्प्ट जो सुरक्षा से जुड़े फ़िल्टर को बायपास करने के लिए डिज़ाइन किए गए हैं. |
अपने इस्तेमाल के हिसाब से, इन फ़िल्टर का इस्तेमाल करके यह तय किया जा सकता है कि कौनसी चीज़ें सही हैं. उदाहरण के लिए, अगर वीडियो गेम के लिए डायलॉग बनाए जा रहे हैं, तो हो सकता है कि गेम की प्रकृति की वजह से, खतरनाक के तौर पर रेटिंग वाले ज़्यादा कॉन्टेंट को अनुमति देना सही माना जाए.
सुरक्षा से जुड़े ऐसे फ़िल्टर जिनमें बदलाव किया जा सकता है के अलावा, Gemini API में सुरक्षा से जुड़ी सुविधाएं भी शामिल हैं. इनकी मदद से, बच्चों की सुरक्षा को खतरे में डालने वाले कॉन्टेंट जैसे नुकसान पहुंचाने वाले कॉन्टेंट को ब्लॉक किया जा सकता है. इस तरह के नुकसान पहुंचाने वाले कॉन्टेंट को हमेशा ब्लॉक किया जाता है और इनमें बदलाव नहीं किया जा सकता.
ब्लॉक करने के थ्रेशोल्ड
मॉडल में सुरक्षा से जुड़ी सुविधाएं पहले से मौजूद होती हैं. इसलिए, अतिरिक्त फ़िल्टर डिफ़ॉल्ट रूप से बंद होते हैं. मॉडल का डिफ़ॉल्ट व्यवहार, ज़्यादातर इस्तेमाल के मामलों को कवर करता है. इसलिए, इन सेटिंग में बदलाव सिर्फ़ तब करें, जब आपके ऐप्लिकेशन के लिए इनकी ज़रूरत हो.
यहां दी गई टेबल में, हर कैटगरी के लिए सेट किए जा सकने वाले थ्रेशोल्ड के बारे में बताया गया है. उदाहरण के लिए, अगर नफ़रत फैलाने वाली भाषा को कुछ को ब्लॉक करें (block_only_high) पर सेट किया जाता है, तो ऐसा कॉन्टेंट ब्लॉक हो जाता है जिसमें नफ़रत फैलाने वाली भाषा होने की संभावना ज़्यादा होती है. वहीं, कम संभावना वाले कॉन्टेंट को अनुमति दी जाती है.
| थ्रेशोल्ड (Google AI Studio) | थ्रेशोल्ड (एपीआई) | ब्यौरा |
|---|---|---|
| बंद है | off |
सुरक्षा से जुड़े फ़िल्टर को बंद करें |
| कुछ को ब्लॉक करें | block_only_high |
जब असुरक्षित कॉन्टेंट होने की संभावना ज़्यादा हो, तब ब्लॉक करें |
| कुछ को ब्लॉक करें | block_medium_and_above |
जब असुरक्षित कॉन्टेंट होने की संभावना मध्यम या ज़्यादा हो, तब ब्लॉक करें |
| ज़्यादातर को ब्लॉक करें | block_low_and_above |
जब असुरक्षित कॉन्टेंट होने की संभावना कम, मध्यम या ज़्यादा हो, तब ब्लॉक करें |
संभावना बनाम गंभीरता
Gemini API, कॉन्टेंट के असुरक्षित होने की संभावना को ज़्यादा, मध्यम, कम या न के बराबर के तौर पर रेट करता है. यह कॉन्टेंट को, नुकसान की गंभीरता के आधार पर नहीं, बल्कि उसकी संभावना के आधार पर ब्लॉक करता है. ऐसा हो सकता है कि कुछ कॉन्टेंट के असुरक्षित होने की संभावना कम हो, लेकिन उससे होने वाला नुकसान गंभीर हो सकता है. उदाहरण के लिए, इन वाक्यों की तुलना करें:
- रोबोट ने मुझे मुक्का मारा.
- रोबोट ने मुझे काट डाला.
पहले वाक्य के असुरक्षित होने की संभावना ज़्यादा हो सकती है, लेकिन आपको दूसरा वाक्य ज़्यादा गंभीर लग सकता है. ध्यान से टेस्ट करके, ब्लॉक करने का वह लेवल ढूंढें जो आपके इस्तेमाल के मामले के लिए सही हो. साथ ही, यह भी पक्का करें कि इससे उपयोगकर्ताओं को कम से कम नुकसान हो.
Google AI Studio में सुरक्षा से जुड़ी सेटिंग में बदलाव करना
रन सेटिंग पैनल में, अडवांस सेटिंग में जाकर, सुरक्षा से जुड़ी सेटिंग पर क्लिक करें. इससे, सुरक्षा से जुड़ी सेटिंग चलाएं मॉडल खुलेगा. मॉडल में, स्लाइडर का इस्तेमाल करके, सुरक्षा की हर कैटगरी के हिसाब से, कॉन्टेंट को फ़िल्टर करने के लेवल में बदलाव किया जा सकता है:
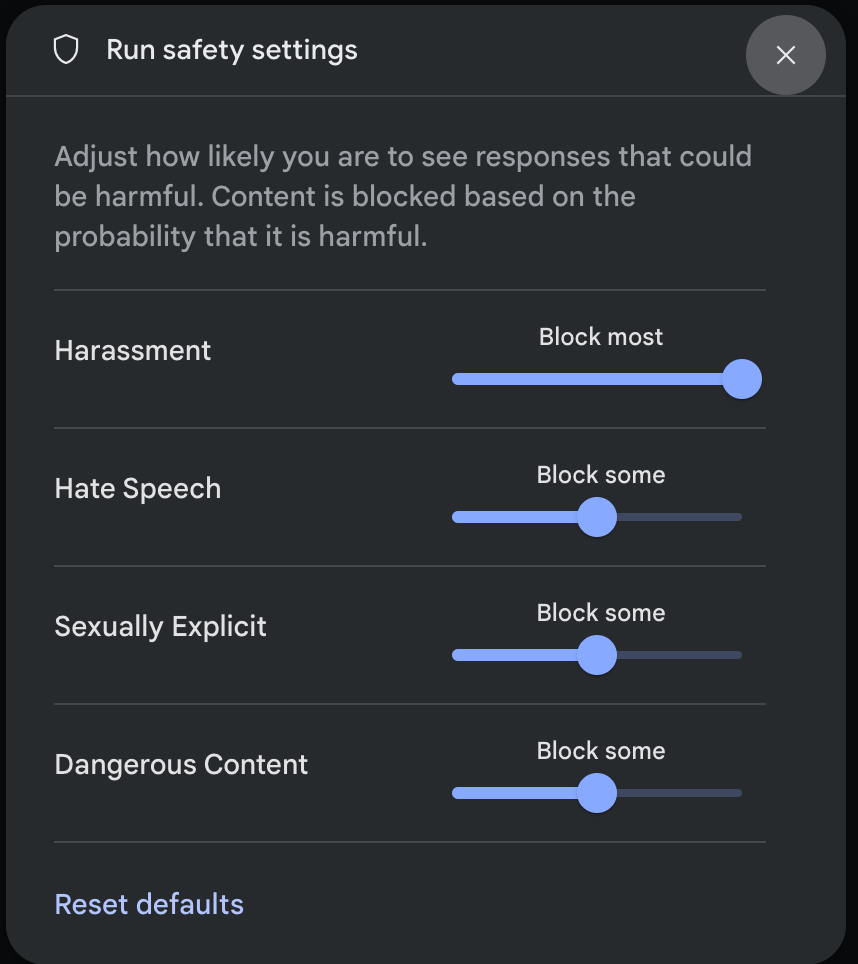
कोई अनुरोध भेजने पर (उदाहरण के लिए, मॉडल से कोई सवाल पूछने पर), अगर अनुरोध का कॉन्टेंट ब्लॉक किया जाता है, तो कॉन्टेंट ब्लॉक किया गया की चेतावनी वाला मैसेज दिखता है. ज़्यादा जानकारी देखने के लिए, कॉन्टेंट ब्लॉक किया गया टेक्स्ट पर कर्सर घुमाएं. इससे, कैटगरी और नुकसान की कैटगरी तय करने की संभावना दिखेगी.
अगले चरण
- पूरे एपीआई के बारे में ज़्यादा जानने के लिए, इंटरैक्शन एपीआई के बारे में जानकारी देखें.
- एलएलएम का इस्तेमाल करके डेवलपमेंट करते समय, सुरक्षा से जुड़ी बातों को समझने के लिए, सुरक्षा से जुड़ी गाइडलाइन देखें.
- संभावना बनाम गंभीरता का आकलन करने के बारे में ज़्यादा जानने के लिए, Jigsaw टीम से संपर्क करें.
- Perspective API जैसे सुरक्षा समाधानों में योगदान देने वाले प्रॉडक्ट के बारे में ज़्यादा जानें.