

В Gemini API есть настройки безопасности, которые можно менять на этапе прототипирования, чтобы определить, нужны ли вашему приложению более или менее строгие ограничения. Вы можете настроить категории фильтров, чтобы разрешить или запретить определенные типы контента.
В этом руководстве рассказывается, как задать настройки безопасности для взаимодействия, что происходит, когда контент блокируется, а также какие категории и пороговые значения можно использовать.
Настройте параметры безопасности
При создании взаимодействия передайте список safety_settings. Каждая настройка сопоставляет категорию вреда (type) с порогом блокировки (threshold).
В следующем примере для категории "Дискриминационные высказывания" (hate_speech) задано значение block_low_and_above, которое блокирует любой контент, с низкой или более высокой вероятностью содержащий дискриминационные высказывания:
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
Проложить маршрут
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
В каждой категории можно указать одну настройку. Для категорий, которые вы не задали, используется пороговое значение по умолчанию, которое для Gemini 2.5 и более поздних моделей имеет значение Отключено.
Когда контент блокируется
Если фильтр безопасности блокирует входные данные или ответ модели, взаимодействие завершается ошибкой HTTP 400. Заблокированный контент не возвращается.
Ошибка code указывает на причину блокировки запроса:
safety: запрос или ответ заблокирован фильтром безопасности.jailbreak,prohibited_contentилиblocklist– ввод был заблокирован по указанной причине. Ошибкаmessageначинается сInput blocked:.
Пример:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
Для фоновых взаимодействий (background=true) значение status устанавливается равным failed, а в списке errors появляются те же code и message.
При потоковой передаче ошибка возникает как событие error.
Фильтры безопасности
Настраиваемые фильтры безопасности Gemini API охватывают следующие категории:
| Категория | Значение (API) | Описание |
|---|---|---|
| Домогательства | harassment |
Оскорбительный контент, угрозы, издевательства, травля или высмеивание. |
| Дискриминационные высказывания | hate_speech |
Контент, содержащий призывы к насилию или враждебности по отношению к отдельным лицам или группам людей на основе определенных признаков. |
| В видео есть материалы сексуального характера. | sexually_explicit |
Контент, содержащий материалы сексуального характера. |
| Опасный контент | dangerous_content |
Контент, который пропагандирует опасные действия, призывает к ним или упрощает их совершение. |
| Побег из тюрьмы | jailbreak |
Запросы, предназначенные для обхода фильтров безопасности. |
Вы можете настроить эти фильтры в соответствии со своими потребностями. Например, если вы создаете диалоги для видеоигры, то можете разрешить больше контента, который оценивается как опасный, из-за характера игры.
Помимо настраиваемых фильтров безопасности, в Gemini API встроены средства защиты от основных видов вреда, например от контента, который может быть опасен для детей. Эти типы вреда всегда блокируются и не могут быть изменены.
Пороговые значения для блокировки
Поскольку модель сама по себе безопасна, дополнительные фильтры по умолчанию отключены. Поведение модели по умолчанию подходит для большинства случаев, поэтому изменять эти настройки следует только в том случае, если это постоянно требуется для вашего приложения.
В таблице ниже описаны пороговые значения, которые можно задать для каждой категории. Например, если для параметра Дискриминационные высказывания задано значение Блокировать некоторые (block_only_high), то контент с высокой вероятностью будет заблокирован, а с низкой – нет.
| Пороговое значение (Google AI Studio) | Пороговое значение (API) | Описание |
|---|---|---|
| Отключено | off |
Как отключить фильтр безопасности |
| Заблокировать несколько | block_only_high |
Блокировать при высокой вероятности небезопасного контента |
| Заблокировать некоторые | block_medium_and_above |
Блокировать при средней или высокой вероятности небезопасного контента |
| Блокировать большинство | block_low_and_above |
Блокировать при низкой, средней или высокой вероятности небезопасного контента |
Вероятность и серьезность
Gemini API оценивает вероятность того, что контент небезопасен, как высокую, среднюю, низкую или незначительную. Блокировка контента выполняется на основе вероятности, а не серьезности нарушения. Некоторый контент может иметь низкую вероятность того, что он небезопасен, даже если вред может быть серьезным. Например, сравните эти предложения:
- Робот ударил меня.
- Робот меня порезал.
Первое предложение может иметь более высокую вероятность быть небезопасным, но вы можете посчитать второе более серьезным. Проведите тщательное тестирование, чтобы определить уровень блокировки, который подходит для вашего варианта использования и при этом не причиняет вреда конечным пользователям.
Как настроить безопасность в Google AI Studio
Нажмите Настройки безопасности в разделе Расширенные настройки на панели Настройки запуска, чтобы открыть модальное окно Настройки безопасности. В открывшемся окне можно настроить уровень фильтрации контента для каждой категории безопасности с помощью ползунков:
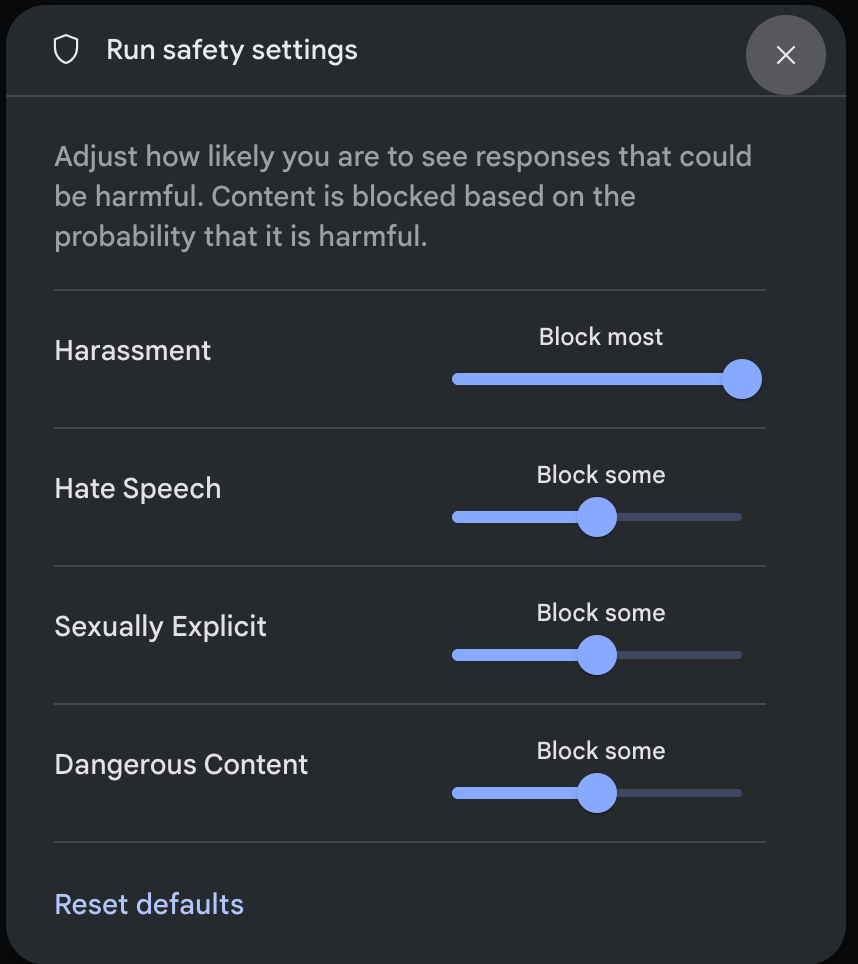
Если вы отправите запрос (например, зададите модели вопрос), контент которого заблокирован, появится сообщение Контент заблокирован. Чтобы посмотреть подробную информацию, наведите указатель на текст Контент заблокирован. Вы увидите категорию и вероятность классификации вреда.
Дальнейшие действия
- Чтобы узнать больше об API, ознакомьтесь с документацией по Interactions API.
- Ознакомьтесь с руководством по безопасности, чтобы узнать, как обеспечить безопасность при разработке с использованием LLM.
- Подробнее о том, как оценивать вероятность и серьезность, можно узнать у команды Jigsaw.
- Узнайте больше о продуктах, которые помогают обеспечивать безопасность, например о Perspective API.