

โมเดล Gemini Robotics ER (การให้เหตุผลแบบฝังตัว) เป็นโมเดลวิทัศน์ภาษา (VLM) ที่ช่วยให้หุ่นยนต์รับรู้และโต้ตอบกับโลกทางกายภาพได้ โดยจะตีความข้อมูลภาพ ใช้การให้เหตุผลเชิงพื้นที่และเชิงเวลา วางแผนงานที่มีหลายขั้นตอน และควบคุม หุ่นยนต์และเครื่องมือ
โมเดล
โมเดล Gemini Robotics ER 2 เป็นโมเดลล่าสุดใน Gemini Robotics โมเดลการให้เหตุผลที่อัปเดตแล้วของเราช่วยให้หุ่นยนต์เข้าใจสภาพแวดล้อมได้อย่างแม่นยำ โดยมีความเชี่ยวชาญด้านความสามารถในการให้เหตุผลแบบฝังตัว เช่น การจัดการเป็นกลุ่ม Agent กับหุ่นยนต์ (เช่น การใช้ VLA), ความเข้าใจวิดีโอของหุ่นยนต์ รวมถึงความเข้าใจความคืบหน้าและการตรวจหาความสำเร็จ การอ่านเครื่องมือ การชี้ และการให้เหตุผลเชิงพื้นที่
โมเดล Gemini Robotics ER 2 มีการเปิดตัวปลายทางโมเดล 2 รายการ ได้แก่
gemini-robotics-er-2-preview: โมเดล ER 2 มาตรฐาน ต่อยอดจาก Gemini 3.5 Flash ด้วยการให้เหตุผลเชิงพื้นที่ การค้นหาช่วงเวลาในวิดีโอ การจัดประเภทความคืบหน้าของวิดีโอ การประสานงานหุ่นยนต์หลายตัว และการใช้เครื่องมือแบบหลายขั้นตอนที่ดียิ่งขึ้นgemini-robotics-er-2-streaming-preview: เหมาะสำหรับการสตรีมแบบเรียลไทม์ โดยใช้ Live API ใช้ โมเดลนี้สำหรับเอเจนต์หุ่นยนต์ที่มีเวลาในการตอบสนองต่ำซึ่งประมวลผลเสียงและ วิดีโออินพุตอย่างต่อเนื่อง
Gemini Robotics ER 1.6 เลิกใช้งานแล้วเมื่อวันที่ 31 สิงหาคม 2026
หากยังคงใช้ Gemini Robotics ER 1.6 ให้อัปเกรดเป็น Gemini Robotics ER 2
โดยแทนที่ model="gemini-robotics-er-1.6-preview" ด้วย
model="gemini-robotics-er-2-preview" หรือ
model="gemini-robotics-er-2-streaming-preview" ในการเรียก API
ลองใช้ Gemini Robotics ER 2 ใน Google AI Studio
ความสามารถด้านหุ่นยนต์
Gemini Robotics ER รองรับความสามารถในการให้เหตุผลที่หลากหลาย เลือกความสามารถเพื่อดูข้อมูลเพิ่มเติม
| ความสามารถ | คำอธิบาย | คู่มือ |
|---|---|---|
| การให้เหตุผลเชิงพื้นที่ | ชี้ไปยังวัตถุ ติดตามวัตถุในวิดีโอ ตรวจจับด้วยกรอบล้อมรอบ วางแผนวิถี | การใช้เหตุผลเชิงพื้นที่ |
| วิสัยทัศน์ของ Agent | ใช้การเรียกใช้โค้ดเพื่อเพิ่มประสิทธิภาพความสามารถอื่นๆ โดยใช้ประโยชน์จากเครื่องมือการปรับแต่งรูปภาพ | Agentic Vision |
| การจัดระเบียบงาน | รวมการใช้เหตุผลเชิงพื้นที่เข้ากับ API ของหุ่นยนต์ที่กำหนดเองเพื่อทำงานระยะยาวให้เสร็จสมบูรณ์ | การจัดระเบียบงาน |
| การสตรีม (เฉพาะปลายทางการสตรีม Gemini Robotics ER 2) | การสตรีมแบบ 2 ทางสำหรับเอเจนต์หุ่นยนต์แบบเรียลไทม์ที่มีเวลาในการตอบสนองต่ำ การเรียกใช้ฟังก์ชัน | การสตรีมสำหรับหุ่นยนต์ |
| ความคืบหน้าของวิดีโอ (Gemini Robotics ER 2 เท่านั้น) | การค้นหาช่วงเวลาและการจัดประเภทความคืบหน้าจากฟีดวิดีโอต่อเนื่อง | การทำความเข้าใจวิดีโอ |
ก่อนเริ่มต้น
โมเดล Gemini Robotics ER พร้อมให้บริการผ่าน Gemini Developer API หากต้องการเริ่มต้นใช้งาน ให้สร้างคีย์ API ของ Gemini จาก Google AI Studio หรือ คอนโซล Google Cloud แล้ว ตั้งค่าสภาพแวดล้อม
ดูรายละเอียดเกี่ยวกับประเภทคีย์ ความปลอดภัย และวิธีกำหนดค่าคีย์ใน Python, JavaScript และภาษาอื่นๆ ได้ที่ การใช้คีย์ Gemini API
เริ่มต้นใช้งาน
ตัวอย่างต่อไปนี้จะค้นหาออบเจ็กต์ในรูปภาพและแสดงผลพิกัด 2 มิติที่ปรับให้เป็นมาตรฐาน และป้ายกำกับ คุณสามารถส่งเอาต์พุตนี้ไปยัง Robotics API หรือโมเดล VLA โดยตรงเพื่อสร้างการทำงานของหุ่นยนต์
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
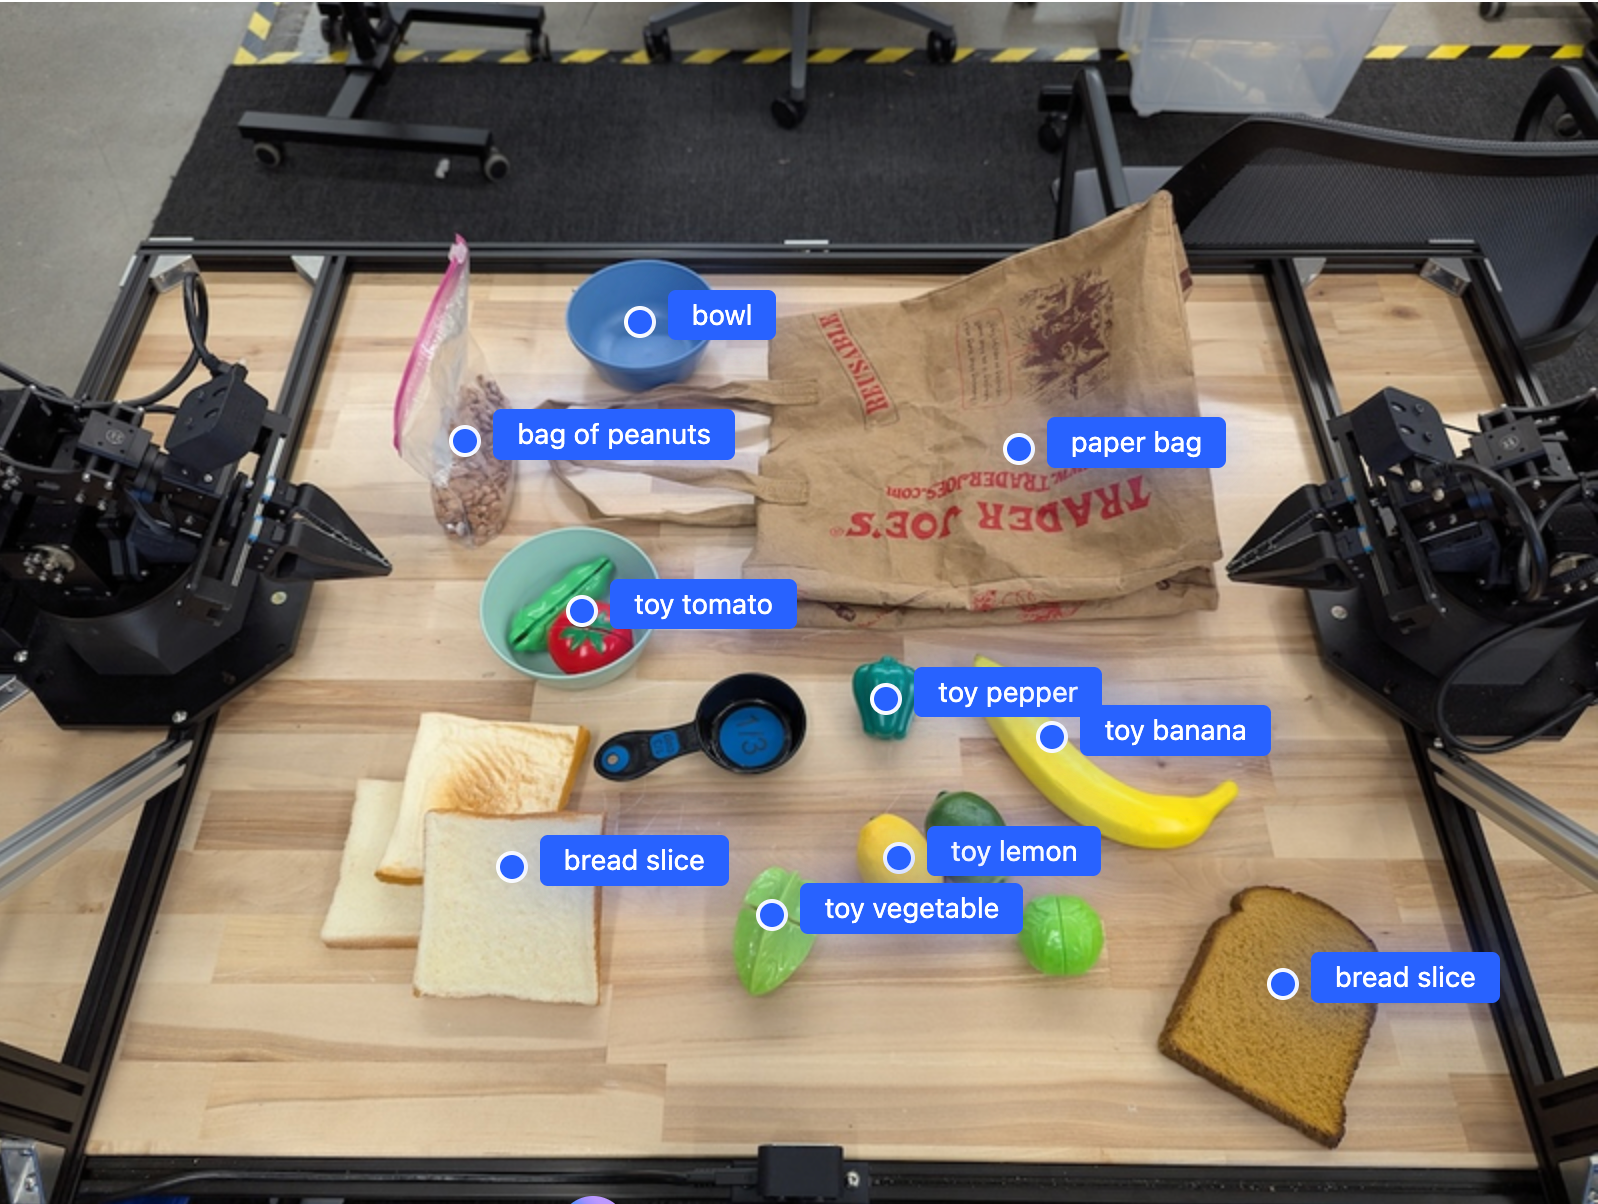
เอาต์พุตจะเป็นอาร์เรย์ JSON ที่มีออบเจ็กต์ โดยแต่ละออบเจ็กต์จะมี point
(พิกัด [y, x] ที่ปรับให้เป็นมาตรฐาน) และ label ที่ระบุออบเจ็กต์
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
รูปภาพต่อไปนี้เป็นตัวอย่างวิธีแสดงคะแนนเหล่านี้
วิธีการทำงาน
Gemini Robotics ER รับอินพุตรูปภาพ วิดีโอ หรือเสียงพร้อมพรอมต์ภาษาธรรมชาติ โดยจะระบุออบเจ็กต์ เหตุผลเกี่ยวกับบริบทของฉากและความสัมพันธ์เชิงพื้นที่ และแสดงผลลัพธ์ที่มีโครงสร้าง เช่น พิกัดหรือกรอบล้อม
Gemini Robotics ER ยังเป็นแบบ Agent ด้วย โดยจะแบ่งงานที่ซับซ้อนออกเป็นงานย่อยๆ และ ดำเนินการโดยการเรียกฟังก์ชันของหุ่นยนต์หรือเรียกใช้โค้ดที่สร้างขึ้น เช่น "วางแอปเปิ้ลในชาม" จะกลายเป็นลำดับขั้นตอนการค้นหา การจับ และการวาง
ดูการเรียกใช้ฟังก์ชันเพื่อดูรายละเอียดเกี่ยวกับวิธีที่ Gemini ดำเนินการเรียกใช้เครื่องมือ
ความปลอดภัย
แม้ว่า Gemini Robotics ER จะสร้างขึ้นโดยคำนึงถึงความปลอดภัย แต่คุณก็มี หน้าที่รับผิดชอบในการรักษาสภาพแวดล้อมที่ปลอดภัยรอบๆ หุ่นยนต์ โมเดล Generative AI อาจทำงานผิดพลาดได้ และหุ่นยนต์ที่จับต้องได้อาจทำให้เกิดความเสียหาย ดูข้อมูลเพิ่มเติมได้ที่ หน้าความปลอดภัยของ Gemini Robotics
แนวทางปฏิบัติแนะนำ
ใช้ภาษาธรรมดาที่เป็นธรรมชาติ อธิบายสิ่งที่ต้องการให้หุ่นยนต์ทำเหมือนที่คุณ อธิบายให้คนฟัง หากคำหนึ่งๆ ไม่ได้ผล ให้ลองใช้คำพ้องความหมายที่ใช้กันทั่วไป
เพิ่มประสิทธิภาพอินพุตภาพ ครอบตัดหรือซูมเข้าวัตถุขนาดเล็กหรือไม่ชัดเจนก่อน ส่งรูปภาพ แสงและคอนทราสต์ของสีต่ำอาจส่งผลต่อการตรวจจับ
แบ่งงานที่ซับซ้อนออกเป็นขั้นตอน ส่งแต่ละขั้นตอนเป็นพรอมต์แยกกันเพื่อ ให้โมเดลโฟกัสและปรับปรุงความแม่นยำ
ส่งคำค้นหาหลายครั้งและหาค่าเฉลี่ยของผลลัพธ์สำหรับงานที่มีความแม่นยำสูง แนวทางฉันทามตินี้ช่วยลดความแปรปรวนของเอาต์พุตเชิงพื้นที่
ข้อจำกัด
โปรดคำนึงถึงข้อจำกัดต่อไปนี้เมื่อพัฒนาด้วย Gemini Robotics ER
- ข้อจํากัดของคีย์ API: Gemini API ไม่ยอมรับคําขอจากคีย์ API ที่ไม่มีข้อจํากัดและจะแสดงข้อผิดพลาด
403 Forbiddenรักษาความปลอดภัยของคีย์ API โดยการเพิ่มข้อจำกัดใน AI Studio ดูรายละเอียดได้ที่รักษาความปลอดภัยคีย์ API ที่ไม่มีการจำกัด - เวลาในการตอบสนองเทียบกับประสิทธิภาพ: คำค้นหาที่ซับซ้อน อินพุตความละเอียดสูง หรือระดับการคิดขั้นสูงอาจทำให้เวลาในการประมวลผลเพิ่มขึ้น สำหรับการคิดระดับ ให้ใช้ปานกลางเพื่อความสมดุลที่ดีระหว่างเวลาในการตอบสนองและประสิทธิภาพ
- อาการหลอน: เช่นเดียวกับโมเดลภาษาขนาดใหญ่ทั้งหมด โมเดล Gemini Robotics ER อาจ "หลอน" หรือให้ข้อมูลที่ไม่ถูกต้องในบางครั้ง โดยเฉพาะอย่างยิ่งสำหรับพรอมต์ที่ไม่ชัดเจนหรืออินพุตที่อยู่นอกการกระจาย
- ขึ้นอยู่กับคุณภาพของพรอมต์: คุณภาพของเอาต์พุตขึ้นอยู่กับความชัดเจน ของพรอมต์อินพุต ใช้พรอมต์ที่เฉพาะเจาะจงและมีโครงสร้างที่ดี
- ค่าใช้จ่ายในการคำนวณ: การเรียกใช้โมเดล โดยเฉพาะอย่างยิ่งเมื่อมีอินพุตวิดีโอหรือ
thinking_budgetสูง จะใช้ทรัพยากรการคำนวณและทำให้เกิดค่าใช้จ่าย ดูรายละเอียดเพิ่มเติมได้ที่หน้าการคิด - ประเภทอินพุต: ดูรายละเอียดเกี่ยวกับข้อจำกัดของแต่ละโหมดได้ในหัวข้อต่อไปนี้
ประกาศเกี่ยวกับนโยบายความเป็นส่วนตัว
คุณรับทราบว่าโมเดลที่อ้างอิงในเอกสารนี้ ("โมเดลหุ่นยนต์") ใช้ประโยชน์จากข้อมูลวิดีโอและเสียงเพื่อดำเนินการและเคลื่อนย้ายฮาร์ดแวร์ตามคำสั่งของคุณ ดังนั้น คุณอาจใช้งานโมเดลหุ่นยนต์ในลักษณะที่โมเดลหุ่นยนต์จะเก็บรวบรวมข้อมูลจากบุคคลที่ระบุตัวตนได้ เช่น เสียง รูปภาพ และข้อมูลความเหมือน ("ข้อมูลส่วนบุคคล") หากเลือกที่จะใช้งานโมเดลหุ่นยนต์ในลักษณะที่เก็บรวบรวม ข้อมูลส่วนตัว คุณยอมรับว่าจะไม่อนุญาตให้บุคคลที่ระบุตัวตนได้ โต้ตอบหรืออยู่ในพื้นที่รอบๆ โมเดลหุ่นยนต์ เว้นแต่และจนกว่าบุคคลที่ระบุตัวตนได้ดังกล่าวจะได้รับการแจ้งเตือนอย่างเพียงพอ และยินยอมให้ Google อาจให้และใช้ข้อมูลส่วนตัวของบุคคลดังกล่าว ตามที่ระบุไว้ในข้อกำหนดในการให้บริการเพิ่มเติมของ Gemini API ที่https://ai.google.dev/gemini-api/terms ("ข้อกำหนด") รวมถึงตามส่วนที่ชื่อว่า "วิธีที่ Google ใช้ข้อมูลของคุณ" คุณจะตรวจสอบว่าประกาศดังกล่าวอนุญาตให้เก็บรวบรวมและใช้ข้อมูลส่วนบุคคลตามที่ระบุไว้ในข้อกำหนด และคุณจะใช้ความพยายามที่สมเหตุสมผลในเชิงพาณิชย์เพื่อลดการเก็บรวบรวมและการเผยแพร่ข้อมูลส่วนบุคคลโดยใช้เทคนิคต่างๆ เช่น การเบลอใบหน้า และการใช้งานโมเดลหุ่นยนต์ในพื้นที่ที่ไม่มีบุคคลที่ระบุตัวตนได้ เท่าที่สามารถทำได้
ราคา
ดูข้อมูลโดยละเอียดเกี่ยวกับการกำหนดราคาและภูมิภาคที่พร้อมให้บริการได้ที่หน้าการกำหนดราคา
ปลายทางของโมเดล
Gemini Robotics ER 2 (เวอร์ชันตัวอย่าง)
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสโมเดล | gemini-robotics-er-2-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดของโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| การอัปเดตล่าสุด | กรกฎาคม 2569 |
| การ์ดโมเดล | การ์ดโมเดล |
Gemini Robotics ER 2 Streaming Preview
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสโมเดล | gemini-robotics-er-2-streaming-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดของโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| การอัปเดตล่าสุด | กรกฎาคม 2569 |
| การ์ดโมเดล | การ์ดโมเดล |
ตัวอย่าง Gemini Robotics ER 1.6
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสโมเดล | gemini-robotics-er-1.6-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดของโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| การอัปเดตล่าสุด | ธันวาคม 2025 |
| การตัดข้อมูล | มกราคม 2025 |
ขั้นตอนถัดไป
- การใช้เหตุผลเชิงพื้นที่ - การชี้ การติดตาม กรอบพื้นที่ วิถี
- ความสามารถด้าน Agentic AI - การเรียกใช้โค้ด การอ่านเครื่องมือ การอธิบายประกอบรูปภาพ
- การจัดระเบียบงาน - งานระยะยาวที่มี API ของหุ่นยนต์ที่กำหนดเอง
- หุ่นยนต์ที่มีการสตรีม - การสตรีมแบบ 2 ทางแบบเรียลไทม์ (Gemini Robotics ER 2 เท่านั้น)
- การทำความเข้าใจวิดีโอ - การค้นหาช่วงเวลาและการจัดประเภทความคืบหน้า (Gemini Robotics ER 2 เท่านั้น)
- ความปลอดภัยของ Gemini Robotics - การวิจัยด้านความปลอดภัยที่อยู่เบื้องหลังตระกูลโมเดล