

«میانای برنامهسازی کاربردی Gemini» تنظیمات ایمنیای ارائه میدهد که میتوانید در مرحله نمونهسازی اولیه آنها را تنظیم کنید تا مشخص شود آیا برنامه شما به پیکربندی ایمنی محدودکنندهتر یا کمتر محدودکنندهای نیاز دارد یا نه. میتوانید این تنظیمات را در دستههای فیلتر تغییر دهید تا انواع خاصی از محتوا را محدود یا مجاز کنید.
این راهنما نحوه تنظیم تنظیمات ایمنی در یک تعامل، آنچه هنگام مسدود شدن محتوا اتفاق میافتد، و دستهها و آستانههایی که میتوانید استفاده کنید را پوشش میدهد.
تنظیم کردن تنظیمات ایمنی
هنگام ایجاد تعامل، فهرستی از safety_settings را ارسال کنید. هر تنظیم
یک دسته آسیب (type) را با یک آستانه مسدودسازی (threshold) جفت میکند.
مثال زیر دسته سخنان مشوق عداوت و تنفر (hate_speech) را روی
block_low_and_above تنظیم میکند، که هر محتوایی را که احتمال پایین یا بالاتر
سخنان مشوق عداوت و تنفر بودن داشته باشد مسدود میکند:
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
جاوا
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
رفتن
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
میتوانید برای هر دسته یک تنظیم اضافه کنید. دستههایی که تنظیم نمیکنید از آستانه پیشفرض استفاده میکنند که برای Gemini 2.5 و مدلهای جدیدتر خاموش است.
وقتی محتوا مسدود میشود
اگر فیلتر ایمنی ورودی یا پاسخ مدل را مسدود کند، تعامل با خطای HTTP 400 ناموفق میشود. محتوای مسدودشده برگردانده نمیشود.
خطای code دلیل مسدود شدن درخواست را به شما میگوید:
-
safety: ورودی یا پاسخ توسط فیلتر ایمنی مسدود شد. -
jailbreak،prohibited_content، یاblocklist: ورودی بههمین دلیل مسدود شد. خطایmessageباInput blocked:شروع میشود.
برای مثال:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
برای تعاملهای پسزمینهای (background=true)، status تعامل روی failed تنظیم میشود و همان code و message در فهرست errors آن نشان داده میشود.
هنگام جاریسازی، خطا بهصورت رویداد error میرسد.
فیلترهای ایمنی
فیلترهای ایمنی قابلتنظیم «میانای برنامهسازی کاربردی Gemini» دستههای زیر را پوشش میدهد:
| دسته | مقدار (میانای برنامهسازی کاربردی) | شرح |
|---|---|---|
| آزار | harassment |
محتوای توهینآمیز، تهدیدآمیز، یا محتوایی که هدف آن زورگویی، آزار، یا تمسخر باشد. |
| نفرتپراکنی | hate_speech |
محتوایی که خشونت را ترویج میکند یا نفرت را علیه افراد یا گروهها براساس ویژگیهای خاص تحریک میکند. |
| محتوای جنسی بیپرده | sexually_explicit |
محتوایی که حاوی مطالب صریح جنسی باشد. |
| خطرناک | dangerous_content |
محتوایی که فعالیتهای خطرناک را ترویج، تسهیل، یا ممکن میکند. |
| قفلشکنی | jailbreak |
پیاموارههایی که برای دور زدن فیلترهای ایمنی طراحی شدهاند. |
میتوانید از این فیلترها برای تنظیم آنچه برای مورد استفاده شما مناسب است استفاده کنید. برای مثال، اگر درحال ساختن گفتگوی بازی ویدیویی هستید، ممکن است بهدلیل ماهیت بازی، مجاز دانستن محتوای بیشتری که بهعنوان خطرناک ردهبندی شده است را قابلقبول بدانید.
علاوهبر فیلترهای ایمنی قابلتنظیم، Gemini API دارای محافظتهای داخلی دربرابر آسیبهای اصلی است، مانند محتوایی که ایمنی کودکان را بهخطر میاندازد. این نوع آسیبها همیشه مسدود میشوند و قابل تنظیم نیستند.
آستانههای مسدود کردن
بهدلیل ایمنی ذاتی مدل، فیلترهای اضافی بهطور پیشفرض خاموش هستند. عملکرد مدل پیشفرض بیشتر موارد استفاده را پوشش میدهد، بنابراین فقط درصورتی باید این تنظیمات را تغییر دهید که بهطور مداوم برای برنامهتان لازم باشد.
جدول زیر آستانههایی را که میتوانید برای هر دسته تنظیم کنید شرح میدهد. برای مثال، اگر سخنان مشوق عداوت و تنفر را روی مسدود کردن تعداد کم (block_only_high) تنظیم کنید،
محتوایی که احتمال بالایی دارد سخنان مشوق عداوت و تنفر باشد مسدود میشود و هر چیزی که احتمال پایینتری داشته باشد مجاز است.
| آستانه (Google AI Studio) | آستانه (میانای برنامهسازی کاربردی) | شرح |
|---|---|---|
| خاموش | off |
خاموش کردن فیلتر ایمنی |
| مسدود کردن چند مورد | block_only_high |
مسدود کردن درصورت احتمال بالای وجود محتوای ناایمن |
| مسدود کردن تعدادی | block_medium_and_above |
مسدود کردن درصورت احتمال متوسط یا بالای محتوای ناامن |
| مسدود کردن بیشتر آنها | block_low_and_above |
مسدود کردن درصورت وجود احتمال کم، متوسط، یا زیاد برای محتوای ناامن |
احتمال دربرابر شدت
Gemini API احتمال ناامن بودن محتوا را بهصورت زیاد، متوسط، کم، یا ناچیز رتبهبندی میکند. این سیستم محتوا را براساس آن احتمال مسدود میکند، نه براساس شدت آسیب. برخیاز محتواها ممکن است احتمال پایینی برای ناامن بودن داشته باشند، حتی اگر آسیب آنها شدید باشد. برای مثال، این جملهها را مقایسه کنید:
- ربات به من مشت زد.
- ربات من را تکهتکه کرد.
جمله اول ممکن است احتمال بیشتری داشته باشد که ناامن باشد، اما شما ممکن است جمله دوم را شدیدتر بدانید. با دقت آزمایش کنید تا سطح مسدودسازی را که از مورد استفاده شما پشتیبانی میکند و درعینحال آسیب به کاربران نهایی را به حداقل میرساند پیدا کنید.
تنظیم کردن تنظیمات ایمنی در Google AI Studio
روی تنظیمات ایمنی در بخش تنظیمات پیشرفته در پانل تنظیمات اجرا کلیک کنید تا پنجره تنظیمات ایمنی اجرا باز شود. در این چارگوش، میتوانید از لغزندهها برای تنظیم سطح فیلتر محتوا در هر دسته ایمنی استفاده کنید:
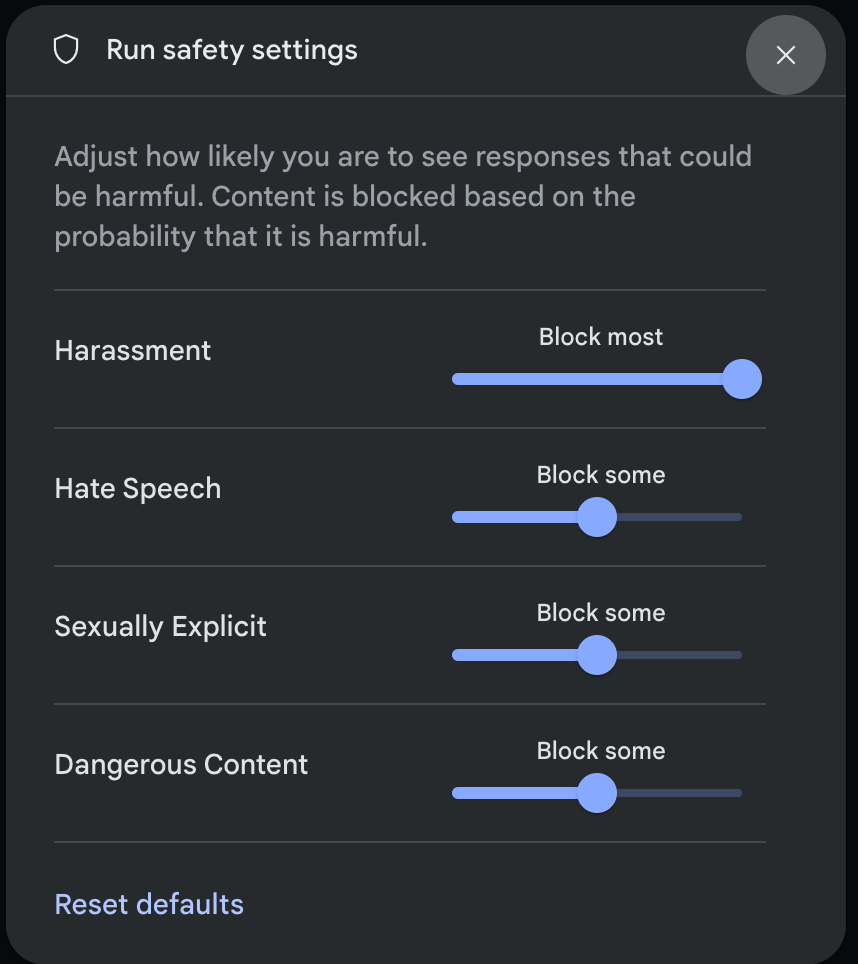
وقتی درخواستی ارسال میکنید (برای مثال، با پرسیدن سؤالی از مدل)، اگر محتوای درخواست مسدود باشد، پیام محتوا مسدود شد نمایش داده میشود. برای دیدن جزئیات بیشتر، نشانگر را روی نوشتار محتوا مسدود شد نگه دارید تا دسته و احتمال طبقهبندی آسیب را ببینید.
مراحل بعدی
- برای کسب اطلاعات بیشتر درباره کل میانای برنامهسازی کاربردی، مرجع Interactions API را ببینید.
- برای نگاهی کلی به ملاحظات ایمنی هنگام توسعه با مدلهای زبانی بزرگ، راهنمای ایمنی را مرور کنید.
- درباره ارزیابی احتمال دربرابر شدت از تیم Jigsaw بیشتر بدانید.
- درباره محصولاتی که به راهکارهای ایمنی کمک میکنند، مثل Perspective API، بیشتر بدانید.