

Gemini API নিরাপত্তা সেটিংস প্রদান করে যা আপনি প্রোটোটাইপিং স্টেজে অ্যাডজাস্ট করতে পারেন। এর মাধ্যমে আপনি নির্ধারণ করতে পারবেন যে আপনার অ্যাপ্লিকেশনের জন্য আরও বেশি বা কম বিধিনিষেধযুক্ত নিরাপত্তা কনফিগারেশন প্রয়োজন কিনা। নির্দিষ্ট ধরনের কন্টেন্ট সীমিত করতে বা অনুমতি দিতে আপনি চারটি ফিল্টার বিভাগ জুড়ে এই সেটিংস অ্যাডজাস্ট করতে পারেন।
এই গাইড থেকে আপনি জানতে পারবেন, Gemini API কীভাবে নিরাপত্তা সেটিংস ও ফিল্টারিং ম্যানেজ করে এবং আপনার অ্যাপ্লিকেশনের জন্য কীভাবে নিরাপত্তা সেটিংস পরিবর্তন করতে পারবেন।
নিরাপত্তা ফিল্টার
Gemini API-এর অ্যাডজাস্ট করা যায় এমন নিরাপত্তা ফিল্টার নিম্নলিখিত বিভাগগুলি কভার করে:
| বিভাগ | বিবরণ |
|---|---|
| হয়রানি | পরিচয় এবং/অথবা সুরক্ষিত বৈশিষ্ট্যকে টার্গেট করে নেতিবাচক বা ক্ষতিকর কমেন্ট। |
| ঘৃণাত্মক বক্তব্য | কন্টেন্ট যা অভদ্র, অসম্মানজনক বা অশ্লীল। |
| যৌনতাপূর্ণ | যৌন কার্যকলাপ বা অন্যান্য অশ্লীল কন্টেন্টের উল্লেখ রয়েছে। |
| বিপজ্জনক | ক্ষতিকর কাজকর্ম প্রচার, তাতে সাহায্য করে অথবা উৎসাহ দেয়। |
এইসব বিভাগ HarmCategory-এ সংজ্ঞায়িত করা আছে। আপনার
ব্যবহারের ক্ষেত্রে কী উপযুক্ত তা অ্যাডজাস্ট করতে আপনি এইসব ফিল্টার ব্যবহার করতে পারবেন। যেমন, আপনি যদি ভিডিও গেমের সংলাপ তৈরি করেন, তাহলে গেমের প্রকৃতির কারণে বিপজ্জনক হিসেবে রেট করা আরও কন্টেন্ট
অনুমতি দেওয়া আপনার কাছে গ্রহণযোগ্য বলে মনে হতে পারে।
অ্যাডজাস্ট করা যায় এমন সুরক্ষা ফিল্টার ছাড়াও, Gemini API-তে মূল ক্ষতি, যেমন বাচ্চাদের নিরাপত্তা বিপন্ন করে এমন কন্টেন্টের বিরুদ্ধে বিল্ট-ইন সুরক্ষা আছে। এই ধরনের ক্ষতি সবসময় ব্লক করা হয় এবং তা অ্যাডজাস্ট করা যায় না।
কন্টেন্ট নিরাপত্তা ফিল্টারিং লেভেল
Gemini API, কন্টেন্ট কতটা নিরাপদ নয় তার সম্ভাবনার লেভেলকে
HIGH, MEDIUM, LOW বা NEGLIGIBLE হিসেবে শ্রেণীবদ্ধ করে।
Gemini API কন্টেন্ট কতটা গুরুতর তার উপর ভিত্তি করে নয়, বরং কন্টেন্ট কতটা অসুরক্ষিত হতে পারে তার উপর ভিত্তি করে ব্লক করে। এটি বিবেচনা করা গুরুত্বপূর্ণ কারণ কিছু কন্টেন্ট অসুরক্ষিত হওয়ার সম্ভাবনা কম থাকলেও, ক্ষতির তীব্রতা এখনও বেশি হতে পারে। যেমন, বাক্যগুলির তুলনা করা:
- রোবট আমাকে ঘুষি মেরেছে।
- রোবটটা আমাকে কেটে টুকরো টুকরো করে দিয়েছে।
প্রথম বাক্যটি হয়ত বেশি মাত্রায় অসুরক্ষিত হওয়ার সম্ভাবনা তৈরি করে, কিন্তু আপনি হিংসার দিক থেকে দ্বিতীয় বাক্যটিকে বেশি গুরুতর বলে বিবেচনা করতে পারেন। এই কারণে, আপনার মূল ব্যবহারের ক্ষেত্রে সহায়তা করার জন্য কোন লেভেলের ব্লকিং উপযুক্ত তা পরীক্ষা করে দেখা এবং বিবেচনা করা গুরুত্বপূর্ণ, যাতে ব্যবহারকারীর উপর ক্ষতিকর প্রভাব কমানো যায়।
প্রতিটি অনুরোধের জন্য নিরাপত্তা ফিল্টারিং
API-তে করা প্রতিটি অনুরোধের জন্য আপনি নিরাপত্তা সেটিংস অ্যাডজাস্ট করতে পারবেন। আপনি
অনুরোধ করলে, কন্টেন্ট বিশ্লেষণ করা হয় এবং একটি নিরাপত্তা রেটিং অ্যাসাইন করা হয়। নিরাপত্তা
রেটিংয়ের মধ্যে ক্ষতির শ্রেণীবিন্যাসের বিভাগ ও সম্ভাবনা
অন্তর্ভুক্ত থাকে। যেমন, হয়রানি ক্যাটেগরির সম্ভাবনা বেশি থাকার কারণে কন্টেন্ট ব্লক করা হলে, নিরাপত্তা রেটিংয়ে ক্যাটেগরি HARASSMENT এবং ক্ষতির সম্ভাবনা HIGH হিসেবে দেখানো হবে।
মডেলের সহজাত নিরাপত্তার কারণে, অতিরিক্ত ফিল্টার ডিফল্ট হিসেবে বন্ধ থাকে। আপনি যদি সেগুলি চালু করার সিদ্ধান্ত নেন, তাহলে কন্টেন্ট অসুরক্ষিত হওয়ার সম্ভাবনার উপর ভিত্তি করে সিস্টেমকে কন্টেন্ট ব্লক করার জন্য কনফিগার করতে পারেন। ডিফল্ট মডেলের আচরণে বেশিরভাগ ব্যবহারের ক্ষেত্র অন্তর্ভুক্ত থাকে, তাই আপনার অ্যাপ্লিকেশনের জন্য যদি ধারাবাহিকভাবে প্রয়োজন হয়, তবেই এইসব সেটিংস অ্যাডজাস্ট করা উচিত।
নিম্নলিখিত সারণীতে প্রতিটি বিভাগের জন্য আপনি যে ব্লক সেটিংস অ্যাডজাস্ট করতে পারবেন তার বিবরণ দেওয়া আছে। যেমন, আপনি যদি ঘৃণাত্মক বক্তব্য বিভাগের জন্য ব্লক করার সেটিং কিছু ব্লক করুন হিসেবে সেট করেন, তাহলে ঘৃণাত্মক বক্তব্য হওয়ার সম্ভাবনা বেশি থাকা সব কন্টেন্ট ব্লক করা হবে। তবে, কম সম্ভাবনার যেকোনও কিছু অনুমোদিত।
| থ্রেশহোল্ড (Google AI Studio) | থ্রেশহোল্ড (API) | বিবরণ |
|---|---|---|
| বন্ধ আছে | OFF |
নিরাপত্তা ফিল্টার বন্ধ করুন |
| কোনওটিই ব্লক করবেন না | BLOCK_NONE |
অসুরক্ষিত কন্টেন্টের সম্ভাবনা যাই হোক না কেন, সবসময় দেখানো হবে |
| কয়েকটি ব্লক করুন | BLOCK_ONLY_HIGH |
নিরাপদ নয় এমন কন্টেন্ট থাকার সম্ভাবনা বেশি হলে ব্লক করুন |
| কিছু ব্লক করুন | BLOCK_MEDIUM_AND_ABOVE |
অসুরক্ষিত কন্টেন্ট হওয়ার সম্ভাবনা মাঝারি বা বেশি হলে ব্লক করুন |
| বেশিরভাগ ব্লক করুন | BLOCK_LOW_AND_ABOVE |
নিরাপদ নয় এমন কন্টেন্টের সম্ভাবনা কম, মাঝারি বা বেশি হলে ব্লক করা |
| প্রযোজ্য নয় | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
থ্রেশহোল্ড উল্লেখ করা নেই, ডিফল্ট থ্রেশহোল্ড ব্যবহার করে ব্লক করুন |
থ্রেশহোল্ড সেট করা না থাকলে, Gemini 2.5 ও তার পরের মডেলের জন্য ডিফল্ট ব্লক থ্রেশহোল্ড বন্ধ থাকে।
আপনি জেনারেটিভ পরিষেবায় করা প্রতিটি অনুরোধের জন্য এইসব সেটিংস সেট করতে পারবেন।
আরও বিবরণের জন্য HarmBlockThreshold API
রেফারেন্স দেখুন।
নিরাপত্তা সংক্রান্ত মতামত
generateContent
একটি
GenerateContentResponse রিটার্ন করে যার
মধ্যে নিরাপত্তা সংক্রান্ত মতামত অন্তর্ভুক্ত থাকে।
প্রম্পট ফিডব্যাক
promptFeedback-এ অন্তর্ভুক্ত করা হয়েছে। promptFeedback.blockReason
সেট করা থাকলে, প্রম্পটের কন্টেন্ট ব্লক করা হয়েছে।
প্রতিক্রিয়া প্রার্থী সংক্রান্ত মতামত
Candidate.finishReason এবং
Candidate.safetyRatings-এ অন্তর্ভুক্ত করা হয়েছে। উত্তর
কন্টেন্ট ব্লক করা হয়ে থাকলে এবং finishReason SAFETY হলে, আপনি আরও বিবরণের জন্য
safetyRatings চেক করতে পারেন। যে কন্টেন্ট ব্লক করা হয়েছে সেটি ফিরিয়ে দেওয়া হয় না।
নিরাপত্তা সেটিংস অ্যাডজাস্ট করা
Google AI Studio এবং আপনার কোড, এই দুটিতেই কীভাবে নিরাপত্তা সেটিংস অ্যাডজাস্ট করবেন তা এই বিভাগে কভার করা হয়েছে।
Google AI Studio
আপনি Google AI Studio-তে নিরাপত্তা সেটিংস অ্যাডজাস্ট করতে পারবেন।
রান সেটিংস প্যানেলে উন্নত সেটিংস-এর মধ্যে নিরাপত্তা সেটিংস বিকল্পে ক্লিক করে রান নিরাপত্তা সেটিংস মোডাল খুলুন। মোডালে, আপনি স্লাইডার ব্যবহার করে প্রতিটি নিরাপত্তা বিভাগের জন্য কন্টেন্ট ফিল্টারিং লেভেল অ্যাডজাস্ট করতে পারবেন:
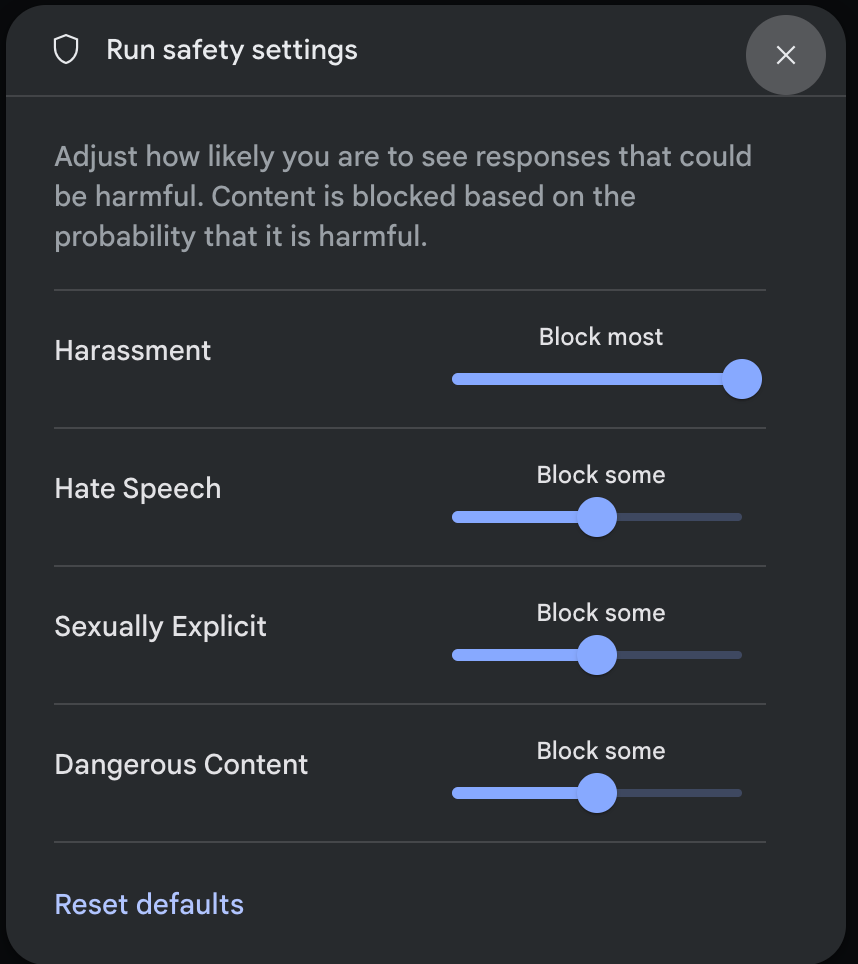
আপনি কোনও অনুরোধ পাঠালে (যেমন, মডেলকে কোনও প্রশ্ন জিজ্ঞাসা করে), অনুরোধের কন্টেন্ট ব্লক করা থাকলে, একটি কন্টেন্ট ব্লক করা হয়েছে মেসেজ দেখানো হয়। আরও বিবরণ দেখতে, পয়েন্টারটি কন্টেন্ট ব্লক করা হয়েছে টেক্সটের উপরে নিয়ে গিয়ে বিভাগ ও ক্ষতির সম্ভাবনা শ্রেণীবিভাগ দেখুন।
কোডের উদাহরণ
নিচে দেওয়া কোড স্নিপেট থেকে আপনার
GenerateContent কলে কীভাবে নিরাপত্তা সেটিংস সেট করতে হয় তা জানতে পারবেন। এটি ঘৃণাত্মক বক্তব্য (HARM_CATEGORY_HATE_SPEECH) বিভাগের জন্য থ্রেশহোল্ড সেট করে। এই ক্যাটাগরিকে
BLOCK_LOW_AND_ABOVE সেট করলে, ঘৃণাত্মক বক্তব্য হওয়ার
কম বা বেশি সম্ভাবনা থাকা কন্টেন্ট ব্লক করা হয়। থ্রেশহোল্ড সেটিংস সম্পর্কে বুঝতে, প্রতি অনুরোধে
নিরাপত্তা ফিল্টারিং দেখুন।
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
খুলুন
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
জাভাস্ক্রিপ্ট
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
বিশ্রাম
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
পরবর্তী ধাপ
- সম্পূর্ণ API সম্পর্কে আরও জানতে API রেফারেন্স দেখুন।
- LLM-এর সাহায্যে ডেভেলপ করার সময় নিরাপত্তা সংক্রান্ত বিষয়গুলি সাধারণভাবে পর্যালোচনা করতে নিরাপত্তা সংক্রান্ত নির্দেশিকা দেখুন।
- Jigsaw টিম-এর থেকে সম্ভাবনা বনাম তীব্রতা মূল্যায়ন করা সম্পর্কে আরও জানুন
- Perspective API-এর মতো নিরাপত্তা সংক্রান্ত সমাধানে অবদান রাখে এমন প্রোডাক্ট সম্পর্কে আরও জানুন। * আপনি এইসব নিরাপত্তা সেটিংস ব্যবহার করে বিষাক্ততা শ্রেণীবদ্ধকারী তৈরি করতে পারবেন। শুরু করতে শ্রেণীবিভাগের উদাহরণ দেখুন।