

«میانای برنامهسازی کاربردی Gemini» تنظیمات ایمنیای ارائه میدهد که میتوانید در مرحله نمونهسازی اولیه آنها را تنظیم کنید تا مشخص شود آیا برنامه شما به پیکربندی ایمنی محدودکنندهتر یا کمتر محدودکنندهای نیاز دارد یا نه. میتوانید این تنظیمات را در چهار دسته فیلتر تنظیم کنید تا انواع خاصی از محتوا را محدود یا مجاز کنید.
این راهنما نحوه مدیریت تنظیمات ایمنی و فیلتر کردن توسط Gemini API و نحوه تغییر تنظیمات ایمنی برای برنامه را پوشش میدهد.
فیلترهای ایمنی
فیلترهای ایمنی قابلتنظیم Gemini API دستههای زیر را پوشش میدهد:
| دسته | شرح |
|---|---|
| آزار | نظرات منفی یا مضر که هویت و/یا ویژگیهای محافظتشده را هدف قرار میدهند. |
| نفرتپراکنی | محتوایی که گستاخانه، غیرمحترمانه، یا ناسزاگویی باشد. |
| محتوای جنسی بیپرده | حاوی ارجاع به اعمال جنسی یا سایر محتوای شهوانی است. |
| خطرناک | کنشهای آسیبزننده را تبلیغ، تسهیل، یا تشویق میکند. |
این دستهها در HarmCategory تعریف شدهاند. میتوانید از این فیلترها برای تنظیم آنچه برای مورد استفاده شما مناسب است استفاده کنید. برای مثال، اگر درحال ساختن گفتگوی بازی ویدیویی هستید، ممکن است بهدلیل ماهیت بازی، مجاز دانستن محتوای بیشتری که بهعنوان خطرناک ردهبندی شده است را قابلقبول بدانید.
علاوهبر فیلترهای ایمنی قابلتنظیم، Gemini API دارای محافظتهای داخلی دربرابر آسیبهای اصلی است، مانند محتوایی که ایمنی کودکان را بهخطر میاندازد. این نوع آسیبها همیشه مسدود میشوند و قابل تنظیم نیستند.
سطح فیلتر کردن ایمنی محتوا
Gemini API سطح احتمال ناامن بودن محتوا را بهصورت
HIGH، MEDIUM، LOW، یا NEGLIGIBLE دستهبندی میکند.
Gemini API محتوا را براساس احتمال ناامن بودن محتوا مسدود میکند و نه شدت آن. این نکته مهمی است که باید درنظر گرفته شود زیرا برخیاز محتواها ممکن است احتمال پایینی برای ناامن بودن داشته باشند، حتی اگر شدت آسیب همچنان بالا باشد. برای مثال، مقایسه جملههای:
- ربات به من مشت زد.
- ربات من را تکهتکه کرد.
جمله اول ممکن است احتمال بیشتری برای ناامن بودن داشته باشد، اما ممکن است جمله دوم را ازنظر شدت خشونت جدیتر بدانید. با توجه به این موضوع، مهم است که با دقت آزمایش کنید و درنظر بگیرید که چه سطحی از مسدود کردن برای پشتیبانی از موارد استفاده کلیدی شما لازم است، درحالیکه آسیب به کاربران نهایی را به حداقل برسانید.
فیلتر کردن ایمنی براساس درخواست
میتوانید تنظیمات ایمنی را برای هر درخواستی که به «میانای برنامهسازی کاربردی» ارسال میکنید تنظیم کنید. وقتی
درخواستی میکنید، محتوا تجزیهوتحلیل میشود و ردهبندی ایمنی به آن اختصاص داده میشود. ردهبندی ایمنی شامل دسته و احتمال طبقهبندی آسیب است. برای مثال، اگر محتوا بهدلیل احتمال بالای دسته آزار مسدود شده باشد، ردهبندی ایمنی برگشتی دارای دسته برابر با HARASSMENT و احتمال آسیب تنظیمشده روی HIGH خواهد بود.
بهدلیل ایمنی ذاتی مدل، فیلترهای اضافی بهطور پیشفرض خاموش هستند. اگر تصمیم بگیرید آنها را فعال کنید، میتوانید سیستم را پیکربندی کنید تا محتوا را براساس احتمال ناامن بودن آن مسدود کند. رفتار پیشفرض مدل بیشتر موارد استفاده را پوشش میدهد، بنابراین فقط درصورتی باید این تنظیمات را تغییر دهید که بهطور مداوم برای برنامهتان لازم باشد.
جدول زیر تنظیمات مسدود کردن را که میتوانید برای هر دسته تنظیم کنید شرح میدهد. برای مثال، اگر تنظیم مسدودسازی را روی مسدود کردن تعداد کمی برای دسته سخنان مشوق عداوت و تنفر تنظیم کنید، هر چیزی که احتمال بالایی داشته باشد محتوای سخنان مشوق عداوت و تنفر باشد مسدود میشود. اما هر چیزی با احتمال کمتر مجاز است.
| آستانه (Google AI Studio) | آستانه (API) | شرح |
|---|---|---|
| خاموش | OFF |
خاموش کردن فیلتر ایمنی |
| هیچکدام مسدود نشود | BLOCK_NONE |
همیشه نشان داده شود، صرفنظر از احتمال وجود محتوای ناایمن |
| مسدود کردن چند مورد | BLOCK_ONLY_HIGH |
مسدود کردن درصورت احتمال بالای وجود محتوای ناایمن |
| مسدود کردن تعدادی | BLOCK_MEDIUM_AND_ABOVE |
مسدود کردن درصورت وجود احتمال متوسط یا زیاد برای محتوای ناامن |
| مسدود کردن بیشتر | BLOCK_LOW_AND_ABOVE |
مسدود کردن درصورت احتمال پایین، متوسط، یا بالای محتوای ناامن |
| موجود نیست | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
آستانه مشخص نشده است، بااستفاده از آستانه پیشفرض مسدود شود |
اگر آستانه تنظیم نشده باشد، آستانه مسدودسازی پیشفرض برای Gemini 2.5 و مدلهای جدیدتر خاموش است.
میتوانید این تنظیمات را برای هر درخواستی که به سرویس زایا ارائه میدهید تنظیم کنید.
برای جزئیات، به مرجع میانای برنامهسازی کاربردی HarmBlockThreshold مراجعه کنید.
بازخورد ایمنی
generateContent
یک
GenerateContentResponse برمیگرداند که
شامل بازخورد ایمنی است.
بازخورد پیامواره در
promptFeedback گنجانده شده است. اگر
promptFeedback.blockReason تنظیم شده باشد، محتوای پیامواره مسدود شده است.
بازخورد پاسخهای نامزد در
Candidate.finishReason و
Candidate.safetyRatings گنجانده شده است. اگر محتوای پاسخ مسدود شده باشد و finishReason SAFETY باشد، میتوانید برای جزئیات بیشتر safetyRatings را بررسی کنید. محتوایی که مسدود شده است برگردانده نمیشود.
تنظیم کردن تنظیمات ایمنی
این بخش نحوه تنظیم تنظیمات ایمنی را هم در Google AI Studio و هم در کد شما پوشش میدهد.
Google AI Studio
میتوانید تنظیمات ایمنی را در «استودیو هوش مصنوعی Google» تغییر دهید.
روی تنظیمات ایمنی در بخش تنظیمات پیشرفته در پانل تنظیمات اجرا کلیک کنید تا پنجره تنظیمات ایمنی اجرا باز شود. در این چارگوش، میتوانید از لغزندهها برای تنظیم سطح فیلتر محتوا در هر دسته ایمنی استفاده کنید:
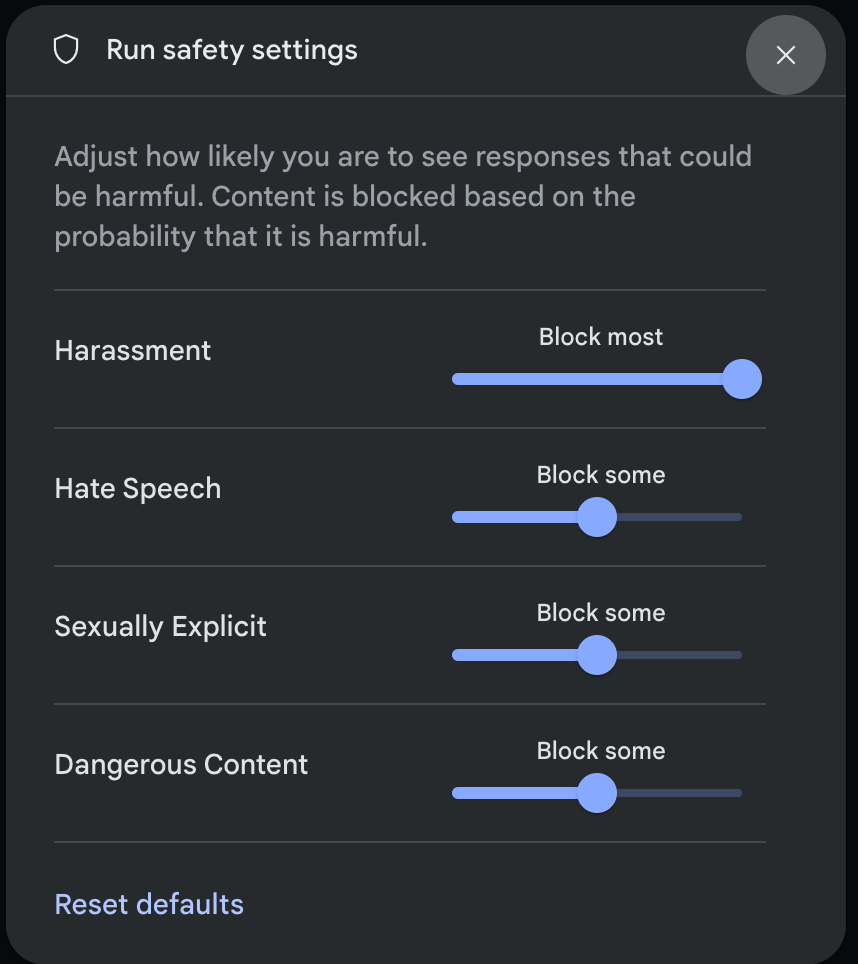
وقتی درخواستی ارسال میکنید (برای مثال، با پرسیدن سؤال از مدل)، اگر محتوای درخواست مسدود شده باشد، پیام محتوا مسدود شد نشان داده میشود. برای دیدن جزئیات بیشتر، نشانگر را روی نوشتار محتوای مسدودشده نگه دارید تا دسته و احتمال طبقهبندی آسیب را ببینید.
نمونههای کد
تکهکد زیر نحوه تنظیم کردن تنظیمات ایمنی را در تماس
GenerateContent نشان میدهد. این مقدار آستانه را برای دسته نفرتپراکنی
(HARM_CATEGORY_HATE_SPEECH) تنظیم میکند. تنظیم این دسته روی
BLOCK_LOW_AND_ABOVE هر محتوایی را که احتمال کم یا زیاد دارد که
سخنان مشوق عداوت و تنفر باشد مسدود میکند. برای درک تنظیمات آستانه، فیلتر کردن ایمنی
بهازای هر درخواست را ببینید.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
رفتن
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
جاوا
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
استراحت
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
مراحل بعدی
- برای کسب اطلاعات بیشتر درباره میانای برنامهسازی کاربردی کامل، مرجع میانای برنامهسازی کاربردی را ببینید.
- برای آشنایی کلی با ملاحظات ایمنی هنگام توسعه با «مدلهای زبانی بزرگ»، راهنمای ایمنی را مرور کنید.
- درباره ارزیابی احتمال دربرابر شدت از تیم Jigsaw بیشتر بدانید
- درباره محصولاتی که به راهکارهای ایمنی کمک میکنند، مثل Perspective API، بیشتر بدانید. * میتوانید از این تنظیمات ایمنی برای ایجاد طبقهبندیکننده سمیت استفاده کنید. برای شروع، نمونه طبقهبندی را ببینید.