

В Gemini API есть настройки безопасности, которые можно менять на этапе прототипирования, чтобы определить, нужны ли вашему приложению более или менее строгие ограничения. Вы можете настроить фильтры по четырем категориям, чтобы разрешить или запретить определенные типы контента.
В этом руководстве рассказывается, как Gemini API обрабатывает настройки безопасности и фильтрацию и как вы можете изменить настройки безопасности для своего приложения.
Фильтры безопасности
Настраиваемые фильтры безопасности Gemini API охватывают следующие категории:
| Категория | Описание |
|---|---|
| Домогательства | Негативные или оскорбительные комментарии, направленные на личность и/или защищенные атрибуты. |
| Дискриминационные высказывания | Грубый, неуважительный или непристойный контент. |
| В видео есть материалы сексуального характера. | Содержит ссылки на половые акты или прочий непристойный контент. |
| Опасный контент | пропагандирует опасные действия, призывает к ним или упрощает их совершение; |
Эти категории определены в HarmCategory. Вы можете использовать эти фильтры, чтобы настроить, что подходит для вашего случая использования. Например, если вы создаете диалоги для видеоигры, то можете разрешить больше контента, который оценивается как опасный, из-за характера игры.
Помимо настраиваемых фильтров безопасности, в Gemini API встроены средства защиты от основных видов вреда, например от контента, который может быть опасен для детей. Эти типы вреда всегда блокируются и не могут быть скорректированы.
Уровень фильтрации контента
Gemini API классифицирует вероятность того, что контент небезопасен, как HIGH, MEDIUM, LOW или NEGLIGIBLE.
API Gemini блокирует контент на основе вероятности того, что он небезопасен, а не степени опасности. Это важно учитывать, поскольку вероятность того, что некоторые материалы небезопасны, может быть низкой, но при этом они могут нанести серьезный вред. Например, сравните следующие предложения:
- Робот ударил меня.
- Робот меня порезал.
Первое предложение может с большей вероятностью быть небезопасным, но второе предложение может считаться более серьезным с точки зрения насилия. Поэтому важно тщательно протестировать и определить, какой уровень блокировки необходим для поддержки ключевых сценариев использования и при этом не причинит вреда конечным пользователям.
Фильтрация по запросу
Вы можете настраивать параметры безопасности для каждого запроса к API. Когда вы отправляете запрос, контент анализируется и ему присваивается оценка безопасности. Оценка безопасности включает категорию и вероятность причинения вреда. Например, если контент был заблокирован из-за высокой вероятности оскорблений, возвращенная оценка безопасности будет иметь категорию, равную HARASSMENT, и вероятность вреда, установленную на HIGH.
Поскольку модель сама по себе безопасна, дополнительные фильтры по умолчанию отключены. Если вы включите их, то сможете настроить систему так, чтобы она блокировала контент в зависимости от вероятности того, что он небезопасен. Поведение модели по умолчанию подходит для большинства случаев, поэтому менять эти настройки следует только в том случае, если для вашего приложения требуется согласованность.
В таблице ниже описаны настройки блокировки, которые можно задать для каждой категории. Например, если вы выберете вариант Блокировать мало для категории Дискриминационные высказывания, то будет заблокирован весь контент, который с высокой вероятностью содержит дискриминационные высказывания. но допускаются и более низкие значения.
| Пороговое значение (Google AI Studio) | Пороговое значение (API) | Описание |
|---|---|---|
| Отключено | OFF |
Как отключить фильтр безопасности |
| Как отключить блокировку | BLOCK_NONE |
Всегда показывать независимо от вероятности небезопасного контента |
| Блокировка нескольких номеров | BLOCK_ONLY_HIGH |
Блокировать при высокой вероятности наличия опасного контента |
| Как заблокировать часть | BLOCK_MEDIUM_AND_ABOVE |
Блокировать при средней или высокой вероятности небезопасного контента |
| Блокировать большинство | BLOCK_LOW_AND_ABOVE |
Блокировать при низкой, средней или высокой вероятности небезопасного контента |
| Н/Д | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
Порог не указан, блокировка по порогу по умолчанию |
Если порог не задан, для Gemini 2.5 и более поздних моделей по умолчанию используется значение Отключено.
Вы можете задавать эти настройки для каждого запроса к генеративному сервису.
Подробную информацию можно найти в документации по API HarmBlockThreshold.
Отзывы о безопасности
generateContent возвращает GenerateContentResponse, который включает отзыв о безопасности.
Отзывы о подсказках включены в promptFeedback. Если задано значение promptFeedback.blockReason, то контент запроса был заблокирован.
Отзывы о вариантах ответов включены в Candidate.finishReason и Candidate.safetyRatings. Если контент ответа был заблокирован, а в поле finishReason указано значение SAFETY, то подробные сведения можно найти в поле safetyRatings. Заблокированный контент не возвращается.
Изменить настройки безопасности
В этом разделе рассказывается, как настроить параметры безопасности в Google AI Studio и в коде.
Google AI Studio
Вы можете изменить настройки безопасности в Google AI Studio.
На панели Настройки запуска в разделе Расширенные настройки нажмите Настройки безопасности, чтобы открыть модальное окно Настройки безопасности запуска. В модальном окне вы можете использовать ползунки, чтобы настроить уровень фильтрации контента для каждой категории безопасности:
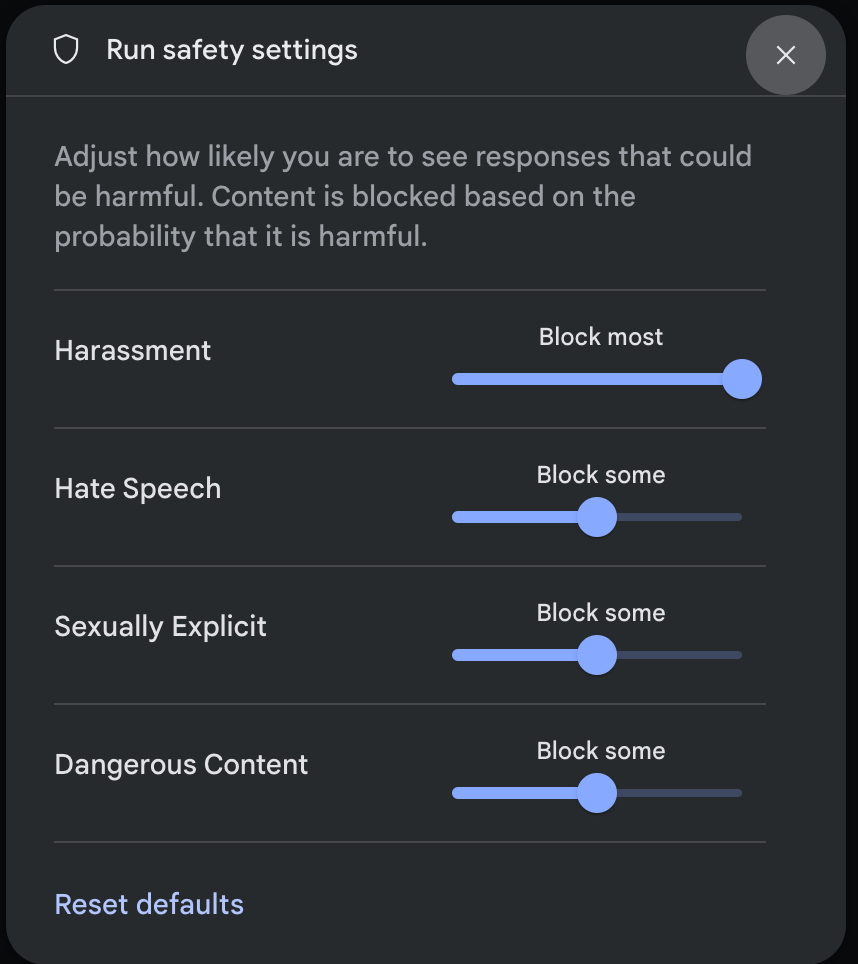
Если вы отправите запрос, например зададите вопрос модели, и его контент будет заблокирован, появится сообщение Контент заблокирован. Чтобы узнать больше, наведите указатель на текст Контент заблокирован. Вы увидите категорию и вероятность классификации вреда.
Примеры кода
В следующем фрагменте кода показано, как задать настройки безопасности в вызове GenerateContent. Это значение определяет порог для категории "Дискриминационные высказывания" (HARM_CATEGORY_HATE_SPEECH). Если для этой категории задать значение BLOCK_LOW_AND_ABOVE, будет блокироваться любой контент, который с низкой или более высокой вероятностью содержит дискриминационные высказывания. Чтобы узнать больше о настройках пороговых значений, ознакомьтесь с разделом Фильтрация контента для взрослых по запросу.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Проложить маршрут
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
Дальнейшие действия
- Подробную информацию об API можно найти в документации по API.
- Ознакомьтесь с руководством по безопасности, чтобы узнать, как обеспечить безопасность при разработке с использованием LLM.
- Подробнее о том, как оценивать вероятность и серьезность, можно узнать у команды Jigsaw.
- Узнайте больше о продуктах, которые помогают обеспечивать безопасность, например о Perspective API. * Вы можете использовать эти настройки безопасности для создания классификатора токсичности. Чтобы начать работу, ознакомьтесь с примером классификации.