

Gemini API, uygulamanızın daha fazla veya daha az kısıtlayıcı bir güvenlik yapılandırması gerektirip gerektirmediğini belirlemek için prototip oluşturma aşamasında ayarlayabileceğiniz güvenlik ayarları sunar. Belirli içerik türlerini kısıtlamak veya bunlara izin vermek için bu ayarları dört filtre kategorisinde düzenleyebilirsiniz.
Bu kılavuzda, Gemini API'nin güvenlik ayarlarını ve filtrelemeyi nasıl işlediği ve uygulamanızın güvenlik ayarlarını nasıl değiştirebileceğiniz açıklanmaktadır.
Güvenlik filtreleri
Gemini API'nin ayarlanabilir güvenlik filtreleri aşağıdaki kategorileri kapsar:
| Kategori | Açıklama |
|---|---|
| Taciz | Kimliği ve/veya koruma altındaki özellikleri hedef alan olumsuz veya zararlı yorumlar |
| Nefret söylemi | Kaba, saygısız veya küfürlü içerikler |
| Müstehcen | Cinsel eylemlere veya diğer müstehcen içeriklere atıfta bulunulması |
| Tehlikeli | Zararlı eylemleri teşvik eden, kolaylaştıran veya destekleyen içerikler |
Bu kategoriler HarmCategory bölümünde tanımlanmıştır. Kullanım alanınıza göre ayarlamalar yapmak için bu filtreleri kullanabilirsiniz. Örneğin, video oyunu diyaloğu oluşturuyorsanız oyunun doğası gereği Tehlikeli olarak derecelendirilen daha fazla içeriğe izin vermeyi kabul edebilirsiniz.
Ayarlanabilir güvenlik filtrelerine ek olarak Gemini API, çocukların güvenliğini tehlikeye atan içerikler gibi temel zararlara karşı yerleşik koruma özelliklerine sahiptir. Bu tür zararlar her zaman engellenir ve ayarlanamaz.
İçerik güvenliği filtreleme düzeyi
Gemini API, içeriğin güvenli olmama olasılık düzeyini HIGH, MEDIUM, LOW veya NEGLIGIBLE olarak kategorize eder.
Gemini API, içerikleri güvenli olmama olasılığına göre engeller, önem derecesine göre değil. Zararın ciddiyeti yüksek olsa bile bazı içeriklerin güvenli olmama olasılığı düşük olabilir. Bu nedenle, bu olasılığı göz önünde bulundurmak önemlidir. Örneğin, şu cümleleri karşılaştıralım:
- Robot bana yumruk attı.
- Robot beni kesti.
İlk cümle güvenli olmama olasılığı daha yüksek olsa da ikinci cümlenin şiddet açısından daha ciddi olduğunu düşünebilirsiniz. Bu nedenle, son kullanıcılara zarar vermeyi en aza indirirken temel kullanım alanlarınızı desteklemek için gereken uygun engelleme düzeyini dikkatlice test etmeniz ve değerlendirmeniz önemlidir.
İstek başına güvenlik filtreleme
API'ye gönderdiğiniz her istek için güvenlik ayarlarını düzenleyebilirsiniz. İstek gönderdiğinizde içerik analiz edilir ve içeriğe güvenlik derecesi atanır. Güvenlik derecelendirmesi, zarar sınıflandırmasının kategorisini ve olasılığını içerir. Örneğin, içerik taciz kategorisinin yüksek olasılıkla güvenli olmaması nedeniyle engellendiyse döndürülen güvenlik derecelendirmesinde kategori HARASSMENT'ya eşit olur ve zarar olasılığı HIGH olarak ayarlanır.
Modelin doğasında bulunan güvenlik nedeniyle ek filtreler varsayılan olarak Kapalı'dır. Bu filtreleri etkinleştirmeyi seçerseniz sistemi, içeriği güvenli olmama olasılığına göre engelleyecek şekilde yapılandırabilirsiniz. Varsayılan model davranışı çoğu kullanım alanını kapsar. Bu nedenle, bu ayarları yalnızca uygulamanız için sürekli olarak gerekmesi durumunda değiştirmeniz önerilir.
Aşağıdaki tabloda, her kategori için ayarlayabileceğiniz engelleme ayarları açıklanmaktadır. Örneğin, Nefret söylemi kategorisi için engelleme ayarını Az engelle olarak belirlerseniz nefret söylemi içeriği olma olasılığı yüksek olan her şey engellenir. Ancak daha düşük olasılıklı olanlara izin verilir.
| Eşik (Google AI Studio) | Eşik (API) | Açıklama |
|---|---|---|
| Kapalı | OFF |
Güvenlik filtresini kapatma |
| Hiçbirini engelleme | BLOCK_NONE |
Güvenli olmayan içerik olasılığına bakılmaksızın her zaman göster |
| Birkaçını engelle | BLOCK_ONLY_HIGH |
İçeriğin güvenli olmama olasılığı yüksekse engelle |
| Bazılarını engelle | BLOCK_MEDIUM_AND_ABOVE |
İçeriğin güvenli olmama olasılığı orta veya yüksekse engelle |
| Çoğunu engelle | BLOCK_LOW_AND_ABOVE |
Güvenli olmayan içerik olasılığı düşük, orta veya yüksek olduğunda engelle |
| Yok | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
Eşik belirtilmediyse varsayılan eşik kullanılarak engelleme yapılır. |
Eşik ayarlanmazsa Gemini 2.5 ve sonraki modellerde varsayılan engelleme eşiği Kapalı olur.
Bu ayarları, üretken hizmete yaptığınız her istek için belirleyebilirsiniz.
Ayrıntılar için HarmBlockThreshold API referansına
bakın.
Güvenlikle ilgili geri bildirim
generateContent
güvenlik geri bildirimi içeren
GenerateContentResponse döndürür.
İstem geri bildirimi promptFeedback kapsamındadır. promptFeedback.blockReason ayarlanırsa istemin içeriği engellenir.
Yanıta aday geri bildirimi, Candidate.finishReason ve Candidate.safetyRatings'a dahil edilir. Yanıt içeriği engellendiyse ve finishReason SAFETY ise daha fazla ayrıntı için safetyRatings inceleyebilirsiniz. Engellenen içerik gösterilmez.
Güvenlik ayarlarını yapma
Bu bölümde, hem Google AI Studio'da hem de kodunuzda güvenlik ayarlarını nasıl düzenleyeceğiniz açıklanmaktadır.
Google AI Studio
Google AI Studio'da güvenlik ayarlarını düzenleyebilirsiniz.
Çalıştırma ayarları panelindeki Gelişmiş ayarlar bölümünde Güvenlik ayarları'nı tıklayarak Çalıştırma güvenlik ayarları modülünü açın. Modaldaki kaydırma çubuklarını kullanarak her güvenlik kategorisi için içerik filtreleme düzeyini ayarlayabilirsiniz:
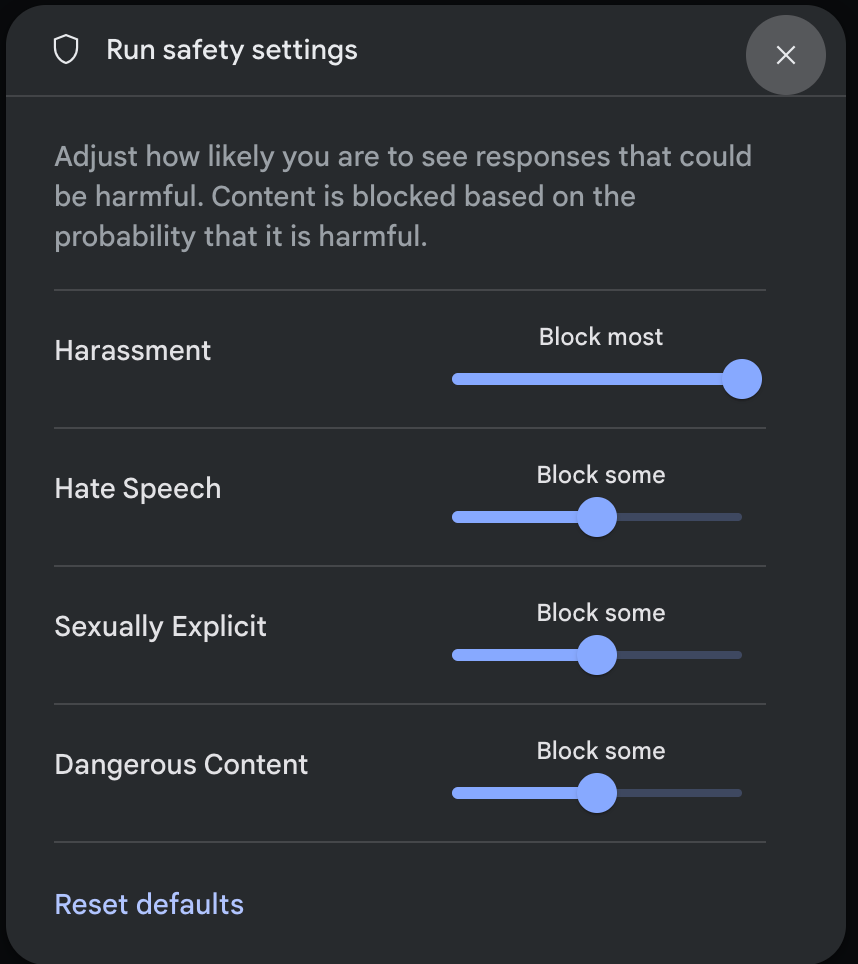
İstek gönderdiğinizde (ör. modele soru sorarak) isteğin içeriği engellenirse İçerik engellendi mesajı gösterilir. Daha fazla ayrıntı görmek için işaretçiyi İçerik engellendi metninin üzerine getirin. Böylece kategori ve zararlı olma olasılığı sınıflandırmasını görebilirsiniz.
Kod örnekleri
Aşağıdaki kod snippet'inde, GenerateContent görüşmenizde güvenlik ayarlarının nasıl yapılacağı gösterilmektedir. Bu işlem, nefret söylemi (HARM_CATEGORY_HATE_SPEECH) kategorisi için eşiği belirler. Bu kategoriyi BLOCK_LOW_AND_ABOVE olarak ayarladığınızda, nefret söylemi olma olasılığı düşük veya yüksek olan tüm içerikler engellenir. Eşik ayarlarını anlamak için İsteğe göre güvenlik filtreleme başlıklı makaleyi inceleyin.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
Sonraki adımlar
- API'nin tamamı hakkında daha fazla bilgi edinmek için API referansına bakın.
- LLM'lerle geliştirme yaparken dikkat edilmesi gereken güvenlik konularına genel bir bakış için güvenlik kılavuzunu inceleyin.
- Jigsaw ekibinden olasılık ve önem derecesini değerlendirme hakkında daha fazla bilgi edinin.
- Perspective API gibi güvenlik çözümlerine katkıda bulunan ürünler hakkında daha fazla bilgi edinin. * Bu güvenlik ayarlarını kullanarak toksisite sınıflandırıcı oluşturabilirsiniz. Başlamak için sınıflandırma örneğine bakın.