

Gemini API में सुरक्षा से जुड़ी सेटिंग उपलब्ध हैं. प्रोटोटाइप बनाने के दौरान, इन सेटिंग में बदलाव किया जा सकता है. इससे यह तय किया जा सकता है कि आपके ऐप्लिकेशन के लिए, सुरक्षा से जुड़ी ज़्यादा पाबंदियां वाली सेटिंग की ज़रूरत है या कम पाबंदियां वाली सेटिंग की. कुछ तरह के कॉन्टेंट पर पाबंदी लगाने या उन्हें अनुमति देने के लिए, इन सेटिंग में चार फ़िल्टर कैटगरी के हिसाब से बदलाव किया जा सकता है.
इस गाइड में, Gemini API में सुरक्षा से जुड़ी सेटिंग और फ़िल्टरिंग को मैनेज करने का तरीका बताया गया है. साथ ही, इसमें यह भी बताया गया है कि अपने ऐप्लिकेशन के लिए, सुरक्षा से जुड़ी सेटिंग कैसे बदली जा सकती हैं.
सुरक्षा फ़िल्टर
Gemini API में सुरक्षा से जुड़े ऐसे फ़िल्टर उपलब्ध हैं जिनमें बदलाव किया जा सकता है. ये फ़िल्टर, इन कैटगरी पर लागू होते हैं:
| कैटगरी | ब्यौरा |
|---|---|
| उत्पीड़न | पहचान और/या सुरक्षित एट्रिब्यूट को टारगेट करने वाली नकारात्मक या नुकसान पहुंचाने वाली टिप्पणियां. |
| नफ़रत फैलाने वाली भाषा | ऐसा कॉन्टेंट जो अशिष्ट, अपमानजनक या अपवित्र हो. |
| अश्लील | इसमें सेक्शुअल ऐक्ट या अन्य अश्लील कॉन्टेंट के रेफ़रंस शामिल होते हैं. |
| खतरनाक | इसमें नुकसान पहुंचाने वाली गतिविधियों को बढ़ावा दिया जाता है, उन्हें आसान बनाया जाता है या उनके लिए प्रोत्साहित किया जाता है. |
इन कैटगरी को HarmCategory में तय किया गया है. इन फ़िल्टर का इस्तेमाल करके, यह तय किया जा सकता है कि आपके इस्तेमाल के उदाहरण के लिए क्या सही है. उदाहरण के लिए, अगर वीडियो गेम के डायलॉग बनाए जा रहे हैं, तो गेम की प्रकृति के हिसाब से, खतरनाक के तौर पर रेट किए गए ज़्यादा कॉन्टेंट को अनुमति देना सही माना जा सकता है.
सुरक्षा से जुड़े ऐसे फ़िल्टर के अलावा जिनमें बदलाव किया जा सकता है, Gemini API में नुकसान पहुंचाने वाले मुख्य कॉन्टेंट के ख़िलाफ़ सुरक्षा की बिल्ट-इन सुविधाएं भी हैं. जैसे, ऐसा कॉन्टेंट जिससे बच्चों की सुरक्षा को खतरा हो. नुकसान पहुंचाने वाले इस तरह के कॉन्टेंट को हमेशा ब्लॉक किया जाता है. साथ ही, इसमें बदलाव नहीं किया जा सकता.
कॉन्टेंट की सुरक्षा के लिए फ़िल्टरिंग का लेवल
Gemini API, कॉन्टेंट के असुरक्षित होने की संभावना के लेवल को HIGH, MEDIUM, LOW या NEGLIGIBLE के तौर पर कैटगरी में बांटता है.
Gemini API, कॉन्टेंट के असुरक्षित होने की संभावना के आधार पर उसे ब्लॉक करता है. यह इस बात पर निर्भर नहीं करता कि कॉन्टेंट कितना नुकसान पहुंचा सकता है. इस बात का ध्यान रखना ज़रूरी है, क्योंकि कुछ कॉन्टेंट के असुरक्षित होने की संभावना कम हो सकती है. हालांकि, उससे होने वाले नुकसान की गंभीरता ज़्यादा हो सकती है. उदाहरण के लिए, इन वाक्यों की तुलना करें:
- रोबोट ने मुझे मुक्का मारा.
- रोबोट ने मुझे काट दिया.
पहले वाक्य के असुरक्षित होने की संभावना ज़्यादा हो सकती है. हालांकि, हिंसा के मामले में दूसरा वाक्य ज़्यादा गंभीर हो सकता है. इसलिए, यह ज़रूरी है कि आप सावधानी से जांच करें और यह तय करें कि आपके मुख्य इस्तेमाल के उदाहरणों के लिए, कॉन्टेंट को ब्लॉक करने का कौनसा लेवल सही है. साथ ही, यह भी देखें कि इससे एंड यूज़र को कम से कम नुकसान हो.
हर अनुरोध के लिए सुरक्षा फ़िल्टरिंग
एपीआई को किए जाने वाले हर अनुरोध के लिए, सुरक्षा से जुड़ी सेटिंग में बदलाव किया जा सकता है. अनुरोध करने पर, कॉन्टेंट का विश्लेषण किया जाता है और उसे सुरक्षा रेटिंग दी जाती है. सुरक्षा रेटिंग में, कैटगरी और नुकसान की कैटगरी तय करने की संभावना शामिल होती है. उदाहरण के लिए, अगर उत्पीड़न की कैटगरी के तहत, कॉन्टेंट के असुरक्षित होने की संभावना ज़्यादा होने की वजह से उसे ब्लॉक किया गया है, तो सुरक्षा रेटिंग में कैटगरी HARASSMENT होगी. साथ ही, नुकसान की संभावना HIGH पर सेट होगी.
मॉडल की सुरक्षा की वजह से, अतिरिक्त फ़िल्टर डिफ़ॉल्ट रूप से बंद होते हैं. अगर इन्हें चालू किया जाता है, तो सिस्टम को कॉन्फ़िगर करके, कॉन्टेंट के असुरक्षित होने की संभावना के आधार पर उसे ब्लॉक किया जा सकता है. डिफ़ॉल्ट मॉडल के व्यवहार में, ज़्यादातर इस्तेमाल के उदाहरण शामिल होते हैं. इसलिए, इन सेटिंग में सिर्फ़ तब बदलाव करें, जब आपके ऐप्लिकेशन के लिए इनकी ज़रूरत हो.
यहां दी गई टेबल में, हर कैटगरी के लिए ब्लॉक करने की उन सेटिंग के बारे में बताया गया है जिनमें बदलाव किया जा सकता है. उदाहरण के लिए, अगर नफ़रत फैलाने वाली भाषा कैटगरी के लिए, ब्लॉक करने की सेटिंग को कुछ कॉन्टेंट ब्लॉक करें पर सेट किया जाता है, तो नफ़रत फैलाने वाली भाषा के तौर पर रेट किए गए ऐसे सभी कॉन्टेंट को ब्लॉक कर दिया जाता है जिसके असुरक्षित होने की संभावना ज़्यादा होती है. हालांकि, कम संभावना वाले कॉन्टेंट को अनुमति दी जाती है.
| थ्रेशोल्ड (Google AI Studio) | थ्रेशोल्ड (एपीआई) | ब्यौरा |
|---|---|---|
| बंद है | OFF |
सुरक्षा फ़िल्टर बंद करें |
| कोई कॉन्टेंट ब्लॉक न करें | BLOCK_NONE |
असुरक्षित कॉन्टेंट की संभावना के बावजूद, हमेशा दिखाएं |
| कुछ कॉन्टेंट ब्लॉक करें | BLOCK_ONLY_HIGH |
असुरक्षित कॉन्टेंट की संभावना ज़्यादा होने पर ब्लॉक करें |
| कुछ कॉन्टेंट ब्लॉक करें | BLOCK_MEDIUM_AND_ABOVE |
असुरक्षित कॉन्टेंट की संभावना मध्यम या ज़्यादा होने पर ब्लॉक करें |
| ज़्यादातर कॉन्टेंट ब्लॉक करें | BLOCK_LOW_AND_ABOVE |
असुरक्षित कॉन्टेंट की संभावना कम, मध्यम या ज़्यादा होने पर ब्लॉक करें |
| लागू नहीं | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
थ्रेशोल्ड तय नहीं किया गया है. डिफ़ॉल्ट थ्रेशोल्ड का इस्तेमाल करके ब्लॉक करें |
अगर थ्रेशोल्ड सेट नहीं किया गया है, तो Gemini 2.5 और 3 मॉडल के लिए, डिफ़ॉल्ट ब्लॉक थ्रेशोल्ड बंद होता है.
जनरेटिव सेवा को किए जाने वाले हर अनुरोध के लिए, ये सेटिंग सेट की जा सकती हैं.
ज़्यादा जानकारी के लिए, HarmBlockThreshold एपीआई
के बारे में जानकारी देखें.
सुरक्षा से जुड़ा सुझाव/शिकायत/राय
generateContent
से
GenerateContentResponse मिलता है. इसमें सुरक्षा से जुड़ा सुझाव/शिकायत/राय शामिल होता है.
प्रॉम्प्ट का सुझाव/शिकायत/राय,
promptFeedback में शामिल होता है. अगर promptFeedback.blockReason सेट है, तो प्रॉम्प्ट के कॉन्टेंट को ब्लॉक कर दिया गया है.
जवाब के कैंडिडेट का सुझाव/शिकायत/राय,
Candidate.finishReason और
Candidate.safetyRatings में शामिल होता है. अगर जवाब के कॉन्टेंट को ब्लॉक कर दिया गया है और finishReason की वैल्यू SAFETY है, तो ज़्यादा जानकारी के लिए, safetyRatings की जांच करें. ब्लॉक किया गया कॉन्टेंट नहीं दिखाया जाता.
सुरक्षा से जुड़ी सेटिंग में बदलाव करना
इस सेक्शन में, Google AI Studio और अपने कोड में, सुरक्षा से जुड़ी सेटिंग में बदलाव करने का तरीका बताया गया है.
Google AI Studio
Google AI Studio में, सुरक्षा से जुड़ी सेटिंग में बदलाव किया जा सकता है.
रन सेटिंग पैनल में, ऐडवांस सेटिंग में जाकर, सुरक्षा से जुड़ी सेटिंग पर क्लिक करें. इससे सुरक्षा से जुड़ी सेटिंग चलाएं मॉडल खुल जाएगा. मॉडल में, स्लाइडर का इस्तेमाल करके, सुरक्षा की हर कैटगरी के लिए, कॉन्टेंट फ़िल्टरिंग के लेवल में बदलाव किया जा सकता है:
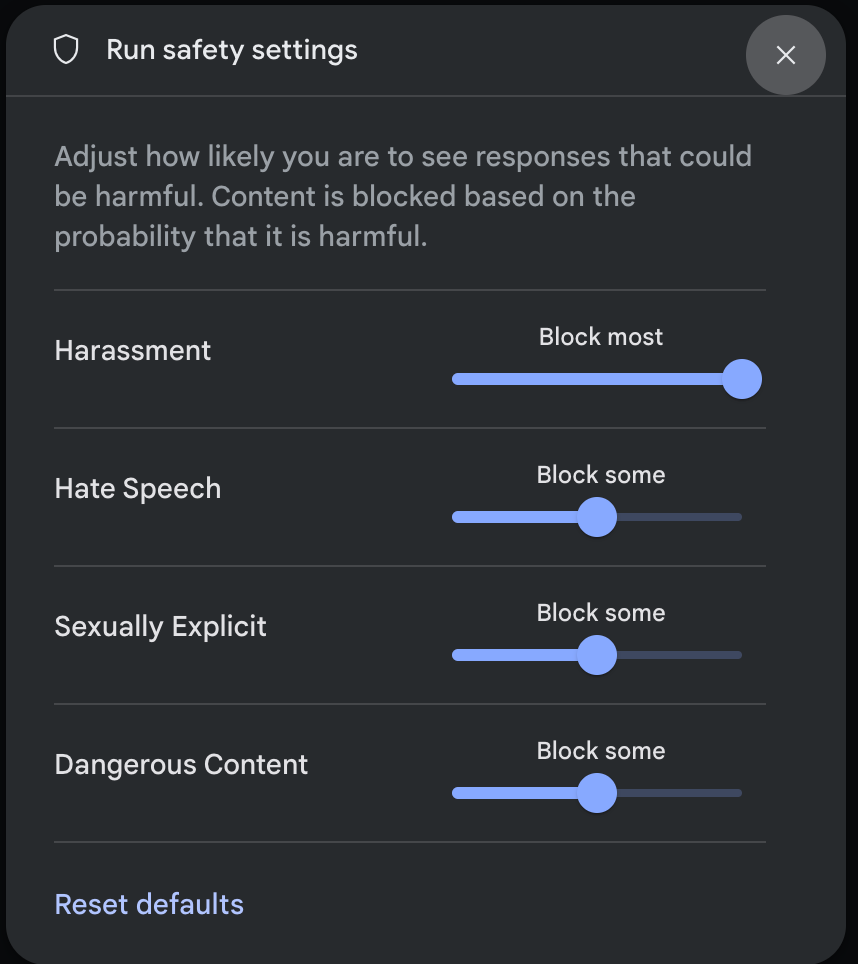
अनुरोध भेजने पर (उदाहरण के लिए, मॉडल से कोई सवाल पूछने पर), अगर अनुरोध के कॉन्टेंट को ब्लॉक किया जाता है, तो कॉन्टेंट ब्लॉक किया गया वाली चेतावनी दिखती है. ज़्यादा जानकारी देखने के लिए, कॉन्टेंट ब्लॉक किया गया टेक्स्ट पर कर्सर घुमाएं. इससे कैटगरी और नुकसान की कैटगरी तय करने की संभावना दिखेगी.
कोड के उदाहरण
यहां दिए गए कोड स्निपेट में, GenerateContent कॉल में सुरक्षा से जुड़ी सेटिंग सेट करने का तरीका दिखाया गया है. इससे, नफ़रत फैलाने वाली भाषा (HARM_CATEGORY_HATE_SPEECH) कैटगरी के लिए थ्रेशोल्ड सेट होता है. इस कैटगरी को BLOCK_LOW_AND_ABOVE पर सेट करने से, ऐसा कोई भी कॉन्टेंट ब्लॉक हो जाता है जिसके नफ़रत फैलाने वाली भाषा होने की संभावना कम या ज़्यादा होती है. थ्रेशोल्ड सेटिंग के बारे में जानने के लिए, सुरक्षा फ़िल्टरिंग
हर अनुरोध के लिए देखें.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
ऐप पर जाएं
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
अगले चरण
- पूरे एपीआई के बारे में ज़्यादा जानने के लिए, एपीआई का संदर्भ देखें.
- एलएलएम के साथ डेवलपमेंट करते समय, सुरक्षा से जुड़ी बातों को समझने के लिए, सुरक्षा के लिए दिशा-निर्देश देखें.
- Jigsaw टीम से, संभावना बनाम गंभीरता का आकलन करने के बारे में ज़्यादा जानें
- Perspective API जैसे सुरक्षा समाधानों में योगदान देने वाले प्रॉडक्ट के बारे में ज़्यादा जानें. * सुरक्षा से जुड़ी इन सेटिंग का इस्तेमाल करके, टॉक्सिसिटी क्लासिफ़ायर बनाया जा सकता है. शुरू करने के लिए, क्लासिफ़िकेशन उदाहरण देखें.