

توفر واجهة برمجة تطبيقات Gemini إعدادات أمان يمكنك تعديلها أثناء مرحلة النمذجة الأولية لتحديد ما إذا كان تطبيقك يتطلب تكوين أمان أكثر أو أقل تقييدًا. يمكنك ضبط هذه الإعدادات عبر أربع فئات تصفية لتقييد أو السماح بأنواع معينة من المحتوى.
يغطي هذا الدليل كيفية تعامل واجهة برمجة تطبيقات Gemini مع إعدادات الأمان والتصفية وكيف يمكنك تغيير إعدادات الأمان لتطبيقك.
فلاتر السلامة
تغطي مرشحات الأمان القابلة للتعديل في واجهة برمجة تطبيقات Gemini الفئات التالية:
| الفئة | الوصف |
|---|---|
| التحرش | التعليقات السلبية أو الضارة التي تستهدف الهوية و/أو السمات المحمية. |
| الكلام الذي يحضّ على الكراهية | المحتوى الذي يتسم بالوقاحة أو عدم الاحترام أو البذاءة. |
| محتوى جنسي فاضح | يحتوي على إشارات إلى أفعال جنسية أو محتوى فاحش آخر. |
| الفئات الخطيرة | يشجع أو يسهل أو يحفز الأفعال الضارة. |
تُعرَّف هذه الفئات فيHarmCategory. يمكنك استخدام هذه المرشحات لضبط ما هو مناسب لحالة استخدامك. على سبيل المثال، إذا كنت تقوم بإنشاء حوار لعبة فيديو، فقد تعتبر أنه من المقبول السماح بمزيد من المحتوى المصنف على أنه خطير نظرًا لطبيعة اللعبة.
بالإضافة إلى فلاتر الأمان القابلة للتعديل، يحتوي Gemini API على وسائل حماية مدمجة ضد الأضرار الأساسية، مثل المحتوى الذي يعرض سلامة الطفل للخطر. يتم دائمًا منع هذه الأنواع من الضرر ولا يمكن تعديلها.
مستوى تصفية أمان المحتوى
يصنف Gemini API مستوى احتمالية كون المحتوى غير آمن على النحو التالي: HIGH، MEDIUM، LOW، أو NEGLIGIBLE.
تقوم واجهة برمجة تطبيقات Gemini بحظر المحتوى بناءً على احتمالية أن يكون المحتوى غير آمن وليس بناءً على مدى خطورته. من المهم مراعاة ذلك لأن بعض المحتويات قد يكون احتمال كونها غير آمنة منخفضًا على الرغم من أن شدة الضرر قد تظل عالية. على سبيل المثال، مقارنة الجمل:
- قام الروبوت بلكمي.
- قام الروبوت بتقطيعي إرباً.
قد تؤدي الجملة الأولى إلى احتمال أكبر لعدم الأمان، ولكن قد تعتبر الجملة الثانية أكثر حدة من حيث العنف. وبناءً على ذلك، من المهم أن تقوم باختبار ودراسة مستوى الحظر المناسب المطلوب لدعم حالات الاستخدام الرئيسية مع تقليل الضرر الذي يلحق بالمستخدمين النهائيين.
تصفية الأمان حسب الطلب
يمكنك ضبط إعدادات الأمان لكل طلب ترسله إلى واجهة برمجة التطبيقات (API). عند تقديم طلب، يتم تحليل المحتوى وتحديد تصنيف أمان له. يشمل تصنيف السلامة الفئة واحتمالية تصنيف الضرر. على سبيل المثال، إذا تم حظر المحتوى بسبب احتمالية عالية لوجود فئة التحرش، فإن تصنيف السلامة الذي تم إرجاعه سيكون له فئة تساوي HARASSMENT واحتمالية الضرر مضبوطة على HIGH.
بسبب الأمان المتأصل في النموذج، تكون المرشحات الإضافية Off افتراضيًا. إذا اخترت تمكينها، يمكنك ضبط النظام لحظر المحتوى بناءً على احتمالية كونه غير آمن. يغطي سلوك النموذج الافتراضي معظم حالات الاستخدام، لذا يجب عليك تعديل هذه الإعدادات فقط إذا كان ذلك مطلوبًا بشكل متسق لتطبيقك.
يصف الجدول التالي إعدادات الحظر التي يمكنك ضبطها لكل فئة. على سبيل المثال، إذا قمت بتعيين إعداد الحظر إلى حظر القليل لفئة خطاب الكراهية، فسيتم حظر كل شيء لديه احتمالية عالية ليكون محتوى خطاب كراهية. لكن يُسمح بأي شيء باحتمالية أقل.
| برنامج Threshold (Google AI Studio) | العتبة (واجهة برمجة التطبيقات) | الوصف |
|---|---|---|
| إيقاف | OFF |
قم بإيقاف تشغيل فلتر الأمان |
| عدم الحظر | BLOCK_NONE |
العرض دائمًا بغض النظر عن احتمال وجود محتوى غير آمن |
| حظر عدد قليل | BLOCK_ONLY_HIGH |
الحظر عند وجود احتمال كبير بأن يكون المحتوى غير آمن |
| حظر بعض الأرقام | BLOCK_MEDIUM_AND_ABOVE |
الحظر عند وجود احتمال متوسط أو كبير بأن يكون المحتوى غير آمن |
| حظر معظم الإشعارات | BLOCK_LOW_AND_ABOVE |
الحظر عند وجود احتمال منخفض أو متوسط أو مرتفع بأن يكون المحتوى غير آمن |
| لا ينطبق | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
لم يتم تحديد الحدّ، يتم الحظر باستخدام الحدّ التلقائي |
إذا لم يتم ضبط الحدّ، يكون الحدّ التلقائي للحظر هو إيقاف لطُرز Gemini 2.5 و3.
يمكنك ضبط هذه الإعدادات لكل طلب ترسله إلى الخدمة التوليدية.
يمكنك الاطّلاع على مرجع
واجهة برمجة التطبيقات HarmBlockThreshold لمعرفة التفاصيل.
ملاحظات حول الأمان
تعرض الدالة generateContent
GenerateContentResponse التي
تتضمّن ملاحظات حول الأمان.
يتم تضمين الملاحظات حول الطلبات في
promptFeedback. إذا تم ضبط قيمة promptFeedback.blockReason، يعني ذلك أنّه تم حظر محتوى الطلب.
يتم تضمين الملاحظات حول المرشحين للردود في
Candidate.finishReason وCandidate.safetyRatings. إذا تم حظر محتوى الردّ وكان finishReason هو SAFETY، يمكنك فحص safetyRatings للحصول على مزيد من التفاصيل. لن تتم إعادة المحتوى الذي تم حظره.
تعديل إعدادات الأمان
يوضّح هذا القسم كيفية تعديل إعدادات الأمان في كلّ من Google AI Studio وفي الرمز البرمجي.
Google AI Studio
يمكنك تعديل إعدادات الأمان في Google AI Studio.
انقر على إعدادات الأمان ضمن الإعدادات المتقدّمة في لوحة إعدادات التنفيذ لفتح النافذة المنبثقة إعدادات الأمان. في النافذة المنبثقة، يمكنك استخدام أشرطة التمرير لضبط مستوى فلترة المحتوى لكل فئة من فئات الأمان:
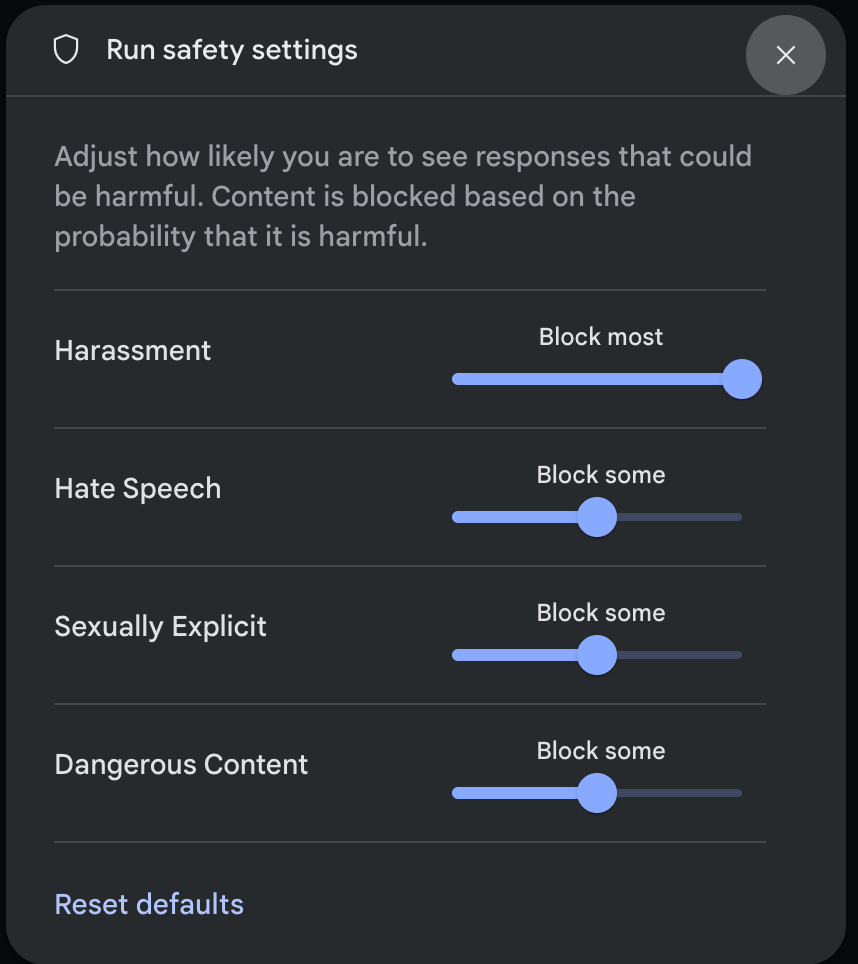
عند إرسال طلب (على سبيل المثال، عن طريق طرح سؤال على النموذج)، تظهر رسالة Content blocked إذا كان محتوى الطلب محظورًا. للاطلاع على المزيد من التفاصيل، مرر المؤشر فوق النص Content blocked لعرض الفئة واحتمالية تصنيف الضرر.
أمثلة على التعليمات البرمجية
يوضح مقتطف الشفرة التالي كيفية ضبط إعدادات الأمان في استدعاء GenerateContent الخاص بك. يحدد هذا الحد الأدنى لفئة خطاب الكراهية (HARM_CATEGORY_HATE_SPEECH). يؤدي تعيين هذه الفئة إلى BLOCK_LOW_AND_ABOVE إلى حظر أي محتوى لديه احتمال منخفض أو مرتفع لكونه خطاب كراهية. لفهم إعدادات العتبة، انظر تصفية الأمان لكل طلب.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
جافا
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
الخطوات التالية
- انظرمرجع واجهة برمجة التطبيقات لمعرفة المزيد حول واجهة برمجة التطبيقات الكاملة.
- راجع إرشادات السلامة لإلقاء نظرة عامة على اعتبارات السلامة عند التطوير باستخدام LLMs.
- تعرّف على المزيد حول تقييم الاحتمالية مقابل الخطورة من فريق Jigsaw
- تعرف على المزيد حول المنتجات التي تساهم في حلول السلامة مثل Perspective API. * يمكنك استخدام إعدادات الأمان هذه لإنشاء مصنف للسمية. انظر إلى مثال التصنيف للبدء.