

Gemini API, prototipleme aşamasında uygulamanızın daha kısıtlayıcı veya daha gevşek bir güvenlik yapılandırmasına ihtiyaç duyup duymadığını belirlemek için ayarlayabileceğiniz güvenlik ayarları sağlar. Bu ayarları dört filtre kategorisi üzerinden düzenleyerek belirli içerik türlerini kısıtlayabilir veya izin verebilirsiniz.
Bu kılavuz, Gemini API'sinin güvenlik ayarlarını ve filtrelemeyi nasıl ele aldığını ve uygulamanız için güvenlik ayarlarını nasıl değiştirebileceğinizi açıklamaktadır.
Güvenlik filtreleri
Gemini API'nin ayarlanabilir emniyet filtreleri aşağıdaki kategorileri kapsar:
| Kategori | Açıklama |
|---|---|
| Taciz | Kimliği ve/veya korunan özellikleri hedef alan olumsuz veya zararlı yorumlar. |
| Nefret söylemi | Kaba, saygısız veya küfür içeren içerik. |
| Müstehcen | Cinsel eylemlere veya diğer müstehcen içeriklere atıfta bulunmaktadır. |
| Tehlikeli | Zararlı eylemleri teşvik eder, kolaylaştırır veya destekler. |
Bu kategoriler şu şekilde tanımlanmıştır:HarmCategory. Bu filtreleri kullanarak kullanım durumunuza uygun olanları ayarlayabilirsiniz. Örneğin, bir video oyunu diyaloğu oluşturuyorsanız, oyunun doğası gereği Tehlikeli olarak derecelendirilen daha fazla içeriğe izin vermeyi kabul edilebilir bulabilirsiniz.
Gemini API, ayarlanabilir güvenlik filtrelerine ek olarak, çocuk güvenliğini tehlikeye atan içerik gibi temel zararlara karşı yerleşik korumalara da sahiptir. Bu tür zararlar her zaman engellenir ve düzeltilemez.
İçerik güvenliği filtreleme düzeyi
Gemini API, içeriğin güvenli olmama olasılık düzeyini HIGH, MEDIUM, LOW veya NEGLIGIBLE olarak sınıflandırır.
Gemini API, içeriğin güvenli olmama olasılığına göre içeriği engeller. İçeriğin ne kadar zararlı olduğu dikkate alınmaz. Zararın ciddiyeti yüksek olsa bile bazı içeriklerin güvenli olmama olasılığı düşük olabilir. Bu nedenle, bu durumu göz önünde bulundurmak önemlidir. Örneğin, şu cümleleri karşılaştıralım:
- Robot bana yumruk attı.
- Robot beni kesti.
Birinci cümle güvensiz olma olasılığını artırabilir, ancak ikinci cümlenin şiddet açısından daha ciddi olduğunu düşünebilirsiniz. Bu nedenle, temel kullanım alanlarınızı desteklerken son kullanıcılara verilen zararı en aza indirmek için uygun engelleme düzeyinin ne olması gerektiğini dikkatlice test etmeniz ve değerlendirmeniz önemlidir.
Talep üzerine güvenlik filtreleme
API'ye yaptığınız her istek için güvenlik ayarlarını düzenleyebilirsiniz. Bir talepte bulunduğunuzda, içerik analiz edilir ve bir güvenlik derecelendirmesi atanır. Güvenlik derecelendirmesi, kategori ve zarar olasılığı sınıflandırmasını içerir. Örneğin, içerik taciz kategorisinin yüksek olasılıkla güvenli olmaması nedeniyle engellendiyse döndürülen güvenlik derecelendirmesinde kategori HARASSMENT'ya eşit olur ve zarar olasılığı HIGH olarak ayarlanır.
Modelin doğasında var olan güvenlik nedeniyle, ek filtreler varsayılan olarak Kapalı durumdadır. Bu ayarları etkinleştirmeyi seçerseniz sistemi, güvenli olmama olasılığına göre içerikleri engelleyecek şekilde yapılandırabilirsiniz. Varsayılan model davranışı çoğu kullanım durumunu kapsar, bu nedenle bu ayarları yalnızca uygulamanız için tutarlılık gerekiyorsa değiştirmelisiniz.
Aşağıdaki tabloda, her kategori için ayarlayabileceğiniz engelleme ayarları açıklanmaktadır. Örneğin, Nefret söylemi kategorisi için engelleme ayarını Birkaçını engelle olarak ayarlarsanız nefret söylemi içeriği olma olasılığı yüksek olan her şey engellenir. Ancak olasılığı daha düşük olan her şeye izin verilir.
| Eşik (Google AI Studio) | Eşik (API) | Açıklama |
|---|---|---|
| Kapalı | OFF |
Güvenlik filtresini kapatın. |
| Hiçbirini engelleme | BLOCK_NONE |
Güvenli olmayan içerik olasılığına bakılmaksızın her zaman göster |
| Birkaçını engelle | BLOCK_ONLY_HIGH |
İçeriğin güvenli olmama olasılığı yüksekse engelle |
| Bazılarını engelleme | BLOCK_MEDIUM_AND_ABOVE |
İçeriğin güvenli olmama olasılığı orta veya yüksekse engelle |
| Çoğunu engelle | BLOCK_LOW_AND_ABOVE |
İçeriğin güvenli olmama olasılığı düşük, orta veya yüksekse içerik engellenir. |
| Yok | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
Eşik belirtilmemişse varsayılan eşik kullanılarak engelleme yapılır. |
Eşik ayarlanmazsa Gemini 2.5 ve 3 modelleri için varsayılan engelleme eşiği Kapalı olur.
Bu ayarları, üretken hizmete yaptığınız her istek için belirleyebilirsiniz.
Ayrıntılar için HarmBlockThreshold API referansına bakın.
Güvenlikle ilgili geri bildirim
generateContent
güvenlik geri bildirimi içeren
GenerateContentResponse döndürür.
İstem geri bildirimi, promptFeedback'e dahil edilir. promptFeedback.blockReason ayarlanmışsa istemin içeriği engellenmiştir.
Yanıta aday geri bildirimi Candidate.finishReason ve Candidate.safetyRatings içinde yer alır. Yanıttaki içerik engellendiyse ve finishReason SAFETY ise daha fazla bilgi için safetyRatings öğesini inceleyebilirsiniz. Engellenen içerik gösterilmez.
Güvenlik ayarlarını yapma
Bu bölümde, hem Google AI Studio'da hem de kodunuzda güvenlik ayarlarının nasıl düzenleneceği açıklanmaktadır.
Google AI Studio
Güvenlik ayarlarını Google AI Studio'da yapabilirsiniz.
Çalıştırma ayarları panelindeki Gelişmiş ayarlar bölümünde Güvenlik ayarları'nı tıklayarak Çalıştırma güvenlik ayarları modalını açın. Modalda, kaydırma çubuklarını kullanarak güvenlik kategorisine göre içerik filtreleme düzeyini ayarlayabilirsiniz:
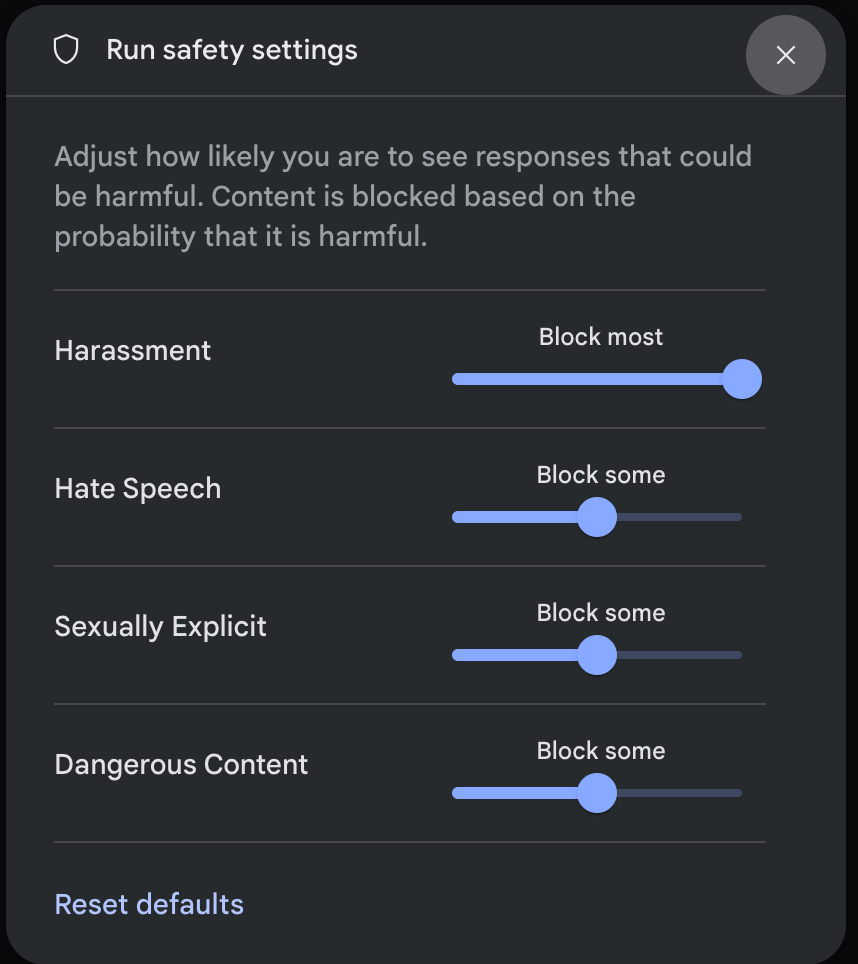
Bir istek gönderdiğinizde (örneğin, modele bir soru sorarak), isteğin içeriği engellenmişse İçerik engellendi mesajı görünür. Daha fazla ayrıntı görmek için, kategoriyi ve zarar sınıflandırmasının olasılığını görmek üzere fare imlecini İçerik engellendi metninin üzerine getirin.
Kod örnekleri
Aşağıdaki kod parçası, GenerateContent çağrınızda güvenlik ayarlarını nasıl yapacağınızı göstermektedir. Bu, nefret söylemi (HARM_CATEGORY_HATE_SPEECH) kategorisi için eşiği belirler. Bu kategoriyi BLOCK_LOW_AND_ABOVE olarak ayarlamak, nefret söylemi olma olasılığı düşük veya yüksek olan tüm içerikleri engeller. Eşik ayarlarını anlamak için İstek başına güvenlik filtrelemesi bölümüne bakın.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
Sonraki adımlar
- API'nin tamamı hakkında daha fazla bilgi edinmek için API referansına bakın.
- LLM'lerle geliştirme yaparken güvenlik hususlarına genel bir bakış için güvenlik kılavuzunu inceleyin.
- Olasılık ve ciddiyet arasındaki ilişkiyi değerlendirme hakkında daha fazla bilgi edinmek için Jigsaw ekibine ulaşın.
- Perspective API gibi güvenlik çözümlerine katkıda bulunan ürünler hakkında daha fazla bilgi edinin. * Bu güvenlik ayarlarını kullanarak bir toksisite sınıflandırıcısı oluşturabilirsiniz. Başlamak için sınıflandırma örneğine bakın.