

Gemini API cung cấp các chế độ cài đặt an toàn mà bạn có thể điều chỉnh trong giai đoạn tạo mẫu để xác định xem ứng dụng của bạn có cần cấu hình an toàn hạn chế hơn hay ít hạn chế hơn hay không. Bạn có thể điều chỉnh các chế độ cài đặt này trên 4 danh mục bộ lọc để hạn chế hoặc cho phép một số loại nội dung.
Hướng dẫn này trình bày cách Gemini API xử lý chế độ cài đặt an toàn và tính năng lọc, cũng như cách bạn có thể thay đổi chế độ cài đặt an toàn cho ứng dụng của mình.
Bộ lọc an toàn
Các bộ lọc an toàn có thể điều chỉnh của Gemini API bao gồm những danh mục sau:
| Danh mục | Mô tả |
|---|---|
| Quấy rối | Bình luận tiêu cực hoặc gây hại nhắm đến danh tính và/hoặc các thuộc tính được bảo vệ. |
| Lời nói hận thù | Nội dung thô lỗ, khiếm nhã hoặc tục tĩu. |
| Nội dung khiêu dâm | Chứa nội dung đề cập đến hành vi tình dục hoặc nội dung khiêu dâm khác. |
| Nguy hiểm | Cổ xuý, tạo điều kiện hoặc khuyến khích hành động gây hại. |
Các danh mục này được xác định trong HarmCategory. Bạn có thể sử dụng các bộ lọc này để điều chỉnh những gì phù hợp với trường hợp sử dụng của mình. Ví dụ: nếu đang xây dựng đoạn hội thoại trong trò chơi điện tử, bạn có thể cho phép nhiều nội dung hơn được xếp hạng là Nguy hiểm do tính chất của trò chơi.
Ngoài các bộ lọc an toàn có thể điều chỉnh, Gemini API còn có các biện pháp bảo vệ tích hợp sẵn để ngăn chặn những tác hại cốt lõi, chẳng hạn như nội dung gây nguy hiểm cho sự an toàn của trẻ em. Những loại nội dung gây hại này luôn bị chặn và không thể điều chỉnh.
Mức độ lọc an toàn nội dung
API của Gemini phân loại mức độ xác suất nội dung không an toàn là HIGH, MEDIUM, LOW hoặc NEGLIGIBLE.
API của Gemini chặn nội dung dựa trên xác suất nội dung đó không an toàn chứ không phải mức độ nghiêm trọng. Điều này rất quan trọng cần xem xét vì một số nội dung có thể có xác suất gây hại thấp nhưng mức độ nghiêm trọng của tác hại vẫn có thể cao. Ví dụ, so sánh các câu sau:
- Con robot đã đấm tôi.
- Con robot đã chém tôi tơi tả.
Câu đầu tiên có thể dẫn đến xác suất không an toàn cao hơn, nhưng bạn có thể coi câu thứ hai có mức độ nghiêm trọng cao hơn về mặt bạo lực. Do đó, điều quan trọng là bạn cần kiểm tra kỹ lưỡng và cân nhắc mức độ chặn phù hợp cần thiết để hỗ trợ các trường hợp sử dụng chính của mình đồng thời giảm thiểu thiệt hại cho người dùng cuối.
Lọc an toàn theo yêu cầu
Bạn có thể điều chỉnh cài đặt bảo mật cho mỗi yêu cầu bạn gửi đến API. Khi bạn gửi yêu cầu, nội dung sẽ được phân tích và gán xếp hạng an toàn. Xếp hạng an toàn bao gồm loại hình và phân loại xác suất gây hại. Ví dụ, nếu nội dung bị chặn do thuộc loại quấy rối có xác suất cao, thì xếp hạng an toàn trả về sẽ có loại bằng HARASSMENT và xác suất gây hại được đặt thành HIGH.
Do tính chất an toàn vốn có của mô hình, các bộ lọc bổ sung được trang bị.Tắt Theo mặc định. Nếu bạn chọn bật tính năng này, bạn có thể cấu hình hệ thống để chặn nội dung dựa trên xác suất nội dung đó không an toàn. Hành vi mặc định của mô hình bao gồm hầu hết các trường hợp sử dụng, vì vậy bạn chỉ nên điều chỉnh các cài đặt này nếu nó cần thiết cho ứng dụng của bạn.
Bảng sau đây mô tả các thiết lập khối mà bạn có thể điều chỉnh cho từng danh mục. Ví dụ, nếu bạn đặt cài đặt chặn thành Chặn một số cho danh mục Lời lẽ thù hận, thì mọi nội dung có khả năng cao là lời lẽ thù hận sẽ bị chặn. Nhưng bất cứ điều gì có xác suất thấp hơn đều được cho phép.
| Threshold (Google AI Studio) | Ngưỡng (API) | Mô tả |
|---|---|---|
| Tắt | OFF |
Tắt bộ lọc an toàn |
| Chặn không | BLOCK_NONE |
Luôn hiển thị bất kể xác suất nội dung không an toàn là bao nhiêu. |
| Khối vài | BLOCK_ONLY_HIGH |
Chặn khi có khả năng cao chứa nội dung không an toàn. |
| Chặn một số | BLOCK_MEDIUM_AND_ABOVE |
Chặn khi có khả năng chứa nội dung không an toàn ở mức trung bình hoặc cao. |
| Chặn hầu hết | BLOCK_LOW_AND_ABOVE |
Chặn khi có xác suất thấp, trung bình hoặc cao về nội dung không an toàn. |
| Không áp dụng | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
Ngưỡng không được chỉ định, chặn bằng ngưỡng mặc định. |
Nếu ngưỡng không được đặt, ngưỡng chặn mặc định là Tắt cho các mẫu Gemini 2.5 và 3.
Bạn có thể thiết lập các cài đặt này cho mỗi yêu cầu bạn gửi đến dịch vụ tạo nội dung.
XemHarmBlockThreshold Xem chi tiết trong tài liệu tham khảo API.
Phản hồi về an toàn
generateContenttrả vềGenerateContentResponse bao gồm cả phản hồi về an toàn.
Phản hồi nhanh chóng được bao gồm trongpromptFeedback. Nếu promptFeedback.blockReason được đặt, thì nội dung của lời nhắc đã bị chặn.
Phản hồi của ứng viên được bao gồm trongCandidate.finishReason VàCandidate.safetyRatings. Nếu nội dung phản hồi bị chặn và finishReason là SAFETY, bạn có thể kiểm tra safetyRatings để biết thêm chi tiết. Nội dung bị chặn sẽ không được hiển thị.
Điều chỉnh cài đặt an toàn
Phần này hướng dẫn cách điều chỉnh cài đặt an toàn trong cả Google AI Studio và trong mã nguồn của bạn.
Google AI Studio
Bạn có thể điều chỉnh cài đặt an toàn trong Google AI Studio.
Nhấp vào Cài đặt an toàn bên dưới Cài đặt nâng cao trong bảng Cài đặt chạy để mở cửa sổ bật lên Cài đặt an toàn khi chạy. Trong cửa sổ bật lên, bạn có thể sử dụng thanh trượt để điều chỉnh mức độ lọc nội dung theo từng danh mục an toàn:
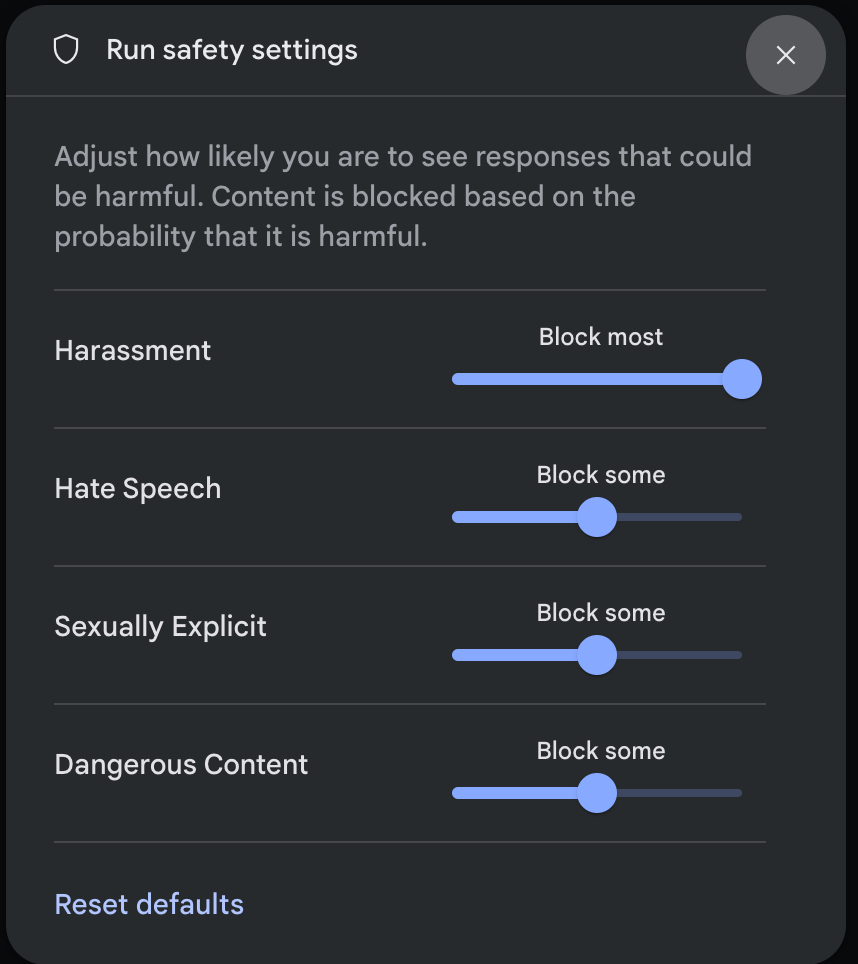
Khi bạn gửi yêu cầu (ví dụ: bằng cách hỏi mô hình một câu hỏi), một thông báo Nội dung bị chặn sẽ xuất hiện nếu nội dung của yêu cầu bị chặn. Để xem thêm chi tiết, hãy di chuột qua văn bản Nội dung bị chặn để xem danh mục và xác suất phân loại mức độ nguy hại.
Ví dụ về mã
Đoạn mã sau đây cho thấy cách thiết lập các cài đặt an toàn trong lệnh gọi GenerateContent của bạn. Điều này đặt ra ngưỡng cho danh mục ngôn từ thù hận (HARM_CATEGORY_HATE_SPEECH). Việc đặt danh mục này thành BLOCK_LOW_AND_ABOVE sẽ chặn mọi nội dung có xác suất thấp hoặc cao hơn là ngôn từ thù hận. Để hiểu rõ các thiết lập ngưỡng, hãy xem Lọc an toàn theo yêu cầu.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
Các bước tiếp theo
- Xem tài liệu tham khảo API để tìm hiểu thêm về API đầy đủ.
- Xem lại hướng dẫn an toàn để có cái nhìn tổng quan về các vấn đề an toàn khi phát triển với LLM.
- Tìm hiểu thêm về cách đánh giá xác suất so với mức độ nghiêm trọng từ nhóm Jigsaw
- Tìm hiểu thêm về các sản phẩm góp phần vào các giải pháp an toàn như Perspective API. * Bạn có thể sử dụng các thiết lập an toàn này để tạo bộ phân loại độc tính. Xem ví dụ phân loại để bắt đầu.