

Gemini API는 프로토타입 제작 단계에서 조정할 수 있는 안전 설정을 제공하여 애플리케이션에 더 제한적인 안전 구성이 필요한지 아니면 덜 제한적인 안전 구성이 필요한지 결정할 수 있습니다. 필터 카테고리에서 이러한 설정을 조정하여 특정 유형의 콘텐츠를 제한하거나 허용할 수 있습니다.
이 가이드에서는 상호작용에 안전 설정을 지정하는 방법, 콘텐츠가 차단될 때 발생하는 상황, 사용할 수 있는 카테고리 및 기준점을 설명합니다.
안전 설정
상호작용을 만들 때 safety_settings 목록을 전달합니다. 각 설정은 유해 카테고리 (type)를 차단 기준점 (threshold)과 페어링합니다.
다음 예에서는 증오심 표현 (hate_speech) 카테고리를 block_low_and_above로 설정합니다. 이렇게 하면 증오심 표현일 가능성이 낮거나 높은 콘텐츠가 차단됩니다.
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
자바
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
카테고리당 하나의 설정을 포함할 수 있습니다. 설정하지 않은 카테고리는 Gemini 2.5 이상 모델의 기본 기준점인 꺼짐 을 사용합니다.
콘텐츠가 차단될 때
안전 필터가 입력 또는 모델의 응답을 차단하면 상호작용이 HTTP 400 오류와 함께 실패합니다. 차단된 콘텐츠는 반환되지 않습니다.
오류 code는 요청이 차단된 이유를 알려줍니다.
safety: 입력 또는 응답이 안전 필터에 의해 차단되었습니다.jailbreak,prohibited_content또는blocklist: 입력이 이러한 이유로 차단되었습니다. 오류message는Input blocked:로 시작합니다.
예를 들면 다음과 같습니다.
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
백그라운드 상호작용 (background=true)의 경우 상호작용의 status가
failed로 설정되고 동일한 code 및 message가 errors 목록에 표시됩니다.
스트리밍 시 오류는 error 이벤트로 도착합니다.
안전 필터
Gemini API의 조정 가능한 안전 필터는 다음 카테고리를 포함합니다.
| 카테고리 | 값 (API) | 설명 |
|---|---|---|
| 괴롭힘 | harassment |
학대, 위협 또는 괴롭힘, 고문, 조롱을 목적으로 하는 콘텐츠 |
| 증오심 표현 | hate_speech |
특정 속성을 기반으로 개인 또는 그룹에 대한 폭력을 조장하거나 증오를 선동하는 콘텐츠 |
| 음란물 | sexually_explicit |
성적으로 노골적인 내용이 포함된 콘텐츠 |
| 위험 | dangerous_content |
위험한 활동을 조장, 촉진 또는 지원하는 콘텐츠 |
| 탈옥 | jailbreak |
안전 필터를 우회하도록 설계된 프롬프트 |
이러한 필터를 사용하면 사용 사례에 적합한 결과를 조정할 수 있습니다. 예를 들어 동영상 게임 대화상자를 빌드하는 경우 게임의 특성상 위험 으로 평가되는 콘텐츠를 더 많이 허용해도 괜찮다고 판단할 수 있습니다.
조정 가능한 안전 필터 외에도 Gemini API에는 아동 안전을 저해하는 콘텐츠와 같은 핵심 유해 요소에 대한 기본 보호 기능이 있습니다. 이러한 유형의 유해 요소는 항상 차단되며 조정할 수 없습니다.
차단 기준점
모델의 고유한 안전성으로 인해 추가 필터는 기본적으로 꺼짐 입니다. 기본 모델 동작은 대부분의 사용 사례를 포함하므로 애플리케이션에 일관되게 필요한 경우에만 이러한 설정을 조정해야 합니다.
다음 표에서는 각 카테고리에 설정할 수 있는 기준점을 설명합니다. 예를 들어 증오심 표현 을 소수 차단 (block_only_high)으로 설정하면 증오심 표현일 가능성이 높은 콘텐츠가 차단되고 가능성이 낮은 콘텐츠는 허용됩니다.
| 기준점 (Google AI Studio) | 기준점 (API) | 설명 |
|---|---|---|
| 꺼짐 | off |
안전 필터 사용 중지 |
| 소수 차단 | block_only_high |
안전하지 않은 콘텐츠일 가능성이 높은 경우 차단 |
| 일부 차단 | block_medium_and_above |
안전하지 않은 콘텐츠일 가능성이 중간 또는 높은 경우 차단 |
| 대부분 차단 | block_low_and_above |
안전하지 않은 콘텐츠일 가능성이 낮음, 중간 또는 높은 경우 차단 |
확률과 심각도
Gemini API는 콘텐츠가 안전하지 않을 가능성을 높음, 중간, 낮음 또는 무시할 수 있는 수준으로 평가합니다. 유해 요소의 심각도가 아닌 가능성에 따라 콘텐츠를 차단합니다. 유해 요소가 심각할 수 있지만 안전하지 않을 가능성이 낮은 콘텐츠도 있습니다. 예를 들어 다음 문장을 비교해 보세요.
- 로봇이 나를 때렸습니다.
- 로봇이 나를 베었습니다.
첫 번째 문장이 안전하지 않을 가능성이 더 높을 수 있지만 두 번째 문장이 더 심각하다고 생각할 수 있습니다. 최종 사용자에게 미치는 해를 최소화하면서 사용 사례를 지원하는 차단 수준을 찾으려면 신중하게 테스트하세요.
Google AI Studio에서 안전 설정 조정
실행 설정 패널의 고급 설정 에서 안전 설정 을 클릭하여 실행 안전 설정 모달을 엽니다. 모달에서 슬라이더를 사용하여 안전 카테고리별로 콘텐츠 필터링 수준을 조정할 수 있습니다.
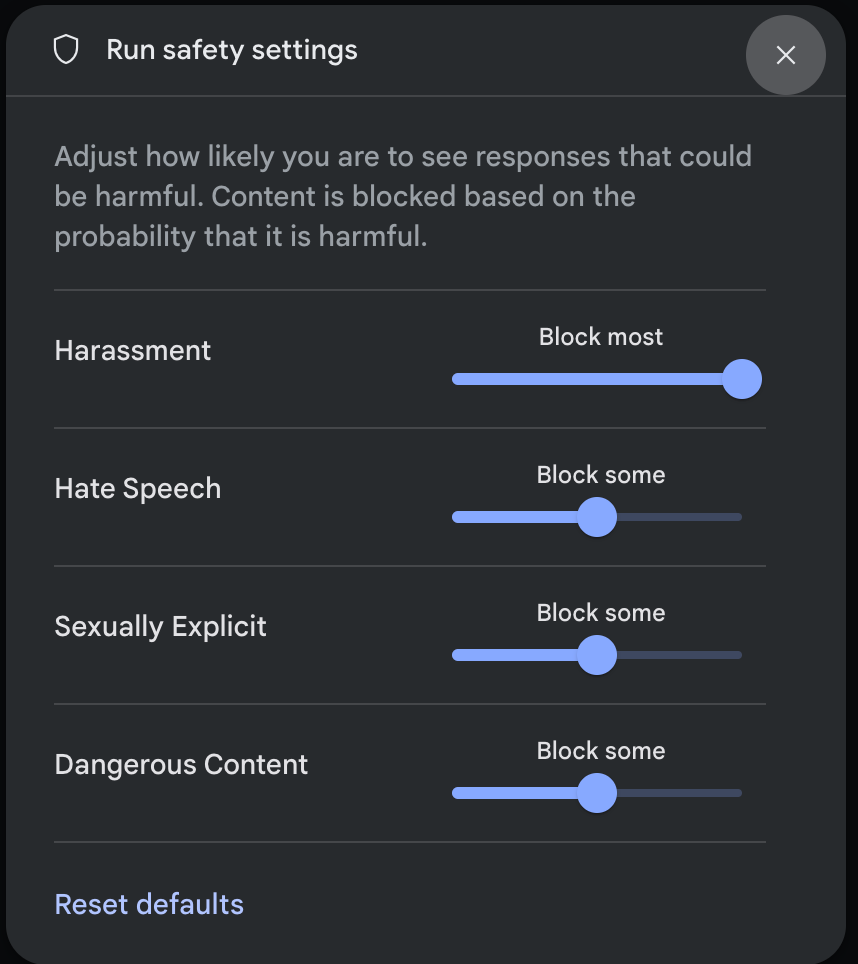
요청의 콘텐츠가 차단되면 요청을 보낼 때 (예: 모델에 질문) 콘텐츠 차단됨 메시지가 표시됩니다. 자세한 내용을 보려면 포인터를 콘텐츠 차단됨 텍스트 위로 가져가 카테고리와 유해 요소 분류 가능성을 확인하세요.
다음 단계
- 전체 API에 대해 자세히 알아보려면 상호작용 API 참조 를 확인하세요.
- LLM으로 개발할 때 안전 고려사항을 전반적으로 살펴보려면 안전 가이드를 검토하세요.
- Jigsaw 팀에서 확률과 심각도를 평가하는 방법을 자세히 알아보세요.
- Perspective API와 같은 안전 솔루션에 기여하는 제품에 대해 자세히 알아보세요.