

Gemini API mundëson gjenerimin e përmirësuar me marrje ("RAG") nëpërmjet veglës së "Kërkimit në skedarë". "Kërkimi në skedar" importon, ndan në pjesë dhe indekson të dhënat e tua për të mundësuar marrjen e shpejtë të informacioneve përkatëse bazuar në një kërkesë të dhënë. Këto informacione të marra më pas përdoren si kontekst për modelin, duke i lejuar atij që të ofrojë përgjigje më të sakta dhe më të përshtatshme. Kërkimi i skedarëve mund të ofrojë gjithashtu aftësi multimodale me integrimet e tekstit të mbështetura nga gemini-embedding-001 dhe integrimet e imazheve/multimodale të mbështetura nga gemini-embedding-2.
Ruajtja e skedarëve dhe gjenerimi i integrimeve në kohën e kërkesës është falas dhe do të paguash vetëm për krijimin e integrimeve kur të indeksosh për herë të parë skedarët e tu dhe koston normale të hyrjes / daljes së kodeve të modelit Gemini. Ky paradigmë e re e faturimit e bën "Veglën e kërkimit të skedarëve" më të lehtë dhe më ekonomike për t'u ndërtuar dhe për t'u shkallëzuar. Shiko seksionin e çmimeve për detaje.
Ngarko drejtpërdrejt te dyqani i "Kërkimit të skedarëve"
Ky shembull tregon se si të ngarkosh drejtpërdrejt një skedar në dyqanin e kërkimit të skedarëve:
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

# File name will be visible in citations
file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'your-fileSearchStore-name',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

operation = client.file_search_stores.upload_to_file_search_store(
  file='sample.txt',
  file_search_store_name=file_search_store.name,
  config={
      'display_name' : 'display-file-name',
  }
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="""Can you tell me about [insert question]""",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

async function run() {
  // File name will be visible in citations
  const fileSearchStore = await ai.fileSearchStores.create({
    config: {
      displayName: 'your-fileSearchStore-name',
      embeddingModel: 'models/gemini-embedding-2'
    }
  });

  let operation = await ai.fileSearchStores.uploadToFileSearchStore({
    file: 'file.txt',
    fileSearchStoreName: fileSearchStore.name,
    config: {
      displayName: 'file-name',
    }
  });

  while (!operation.done) {
    await new Promise(resolve => setTimeout(resolve, 5000));
    operation = await ai.operations.get({ operation });
  }

  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Can you tell me about [insert question]",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [fileSearchStore.name]
          }
        }
      ]
    }
  });

  console.log(response.text);
}

run();
Kontrollo referencën e API-së për uploadToFileSearchStore për më shumë informacione.
Skedarët po importohen
Si alternativë, mund të ngarkosh një skedar ekzistues dhe ta importosh atë në dyqanin tënd të kërkimit të skedarëve:
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

# File name will be visible in citations
sample_file = client.files.upload(file='sample.txt', config={'name': 'display_file_name'})

file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'your-fileSearchStore-name',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

operation = client.file_search_stores.import_file(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="""Can you tell me about [insert question]""",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

async function run() {
  // File name will be visible in citations
  const sampleFile = await ai.files.upload({
    file: 'sample.txt',
    config: { name: 'file-name' }
  });

  const fileSearchStore = await ai.fileSearchStores.create({
    config: {
      displayName: 'your-fileSearchStore-name',
      embeddingModel: 'models/gemini-embedding-2'
    }
  });

  let operation = await ai.fileSearchStores.importFile({
    fileSearchStoreName: fileSearchStore.name,
    fileName: sampleFile.name
  });

  while (!operation.done) {
    await new Promise(resolve => setTimeout(resolve, 5000));
    operation = await ai.operations.get({ operation: operation });
  }

  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Can you tell me about [insert question]",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [fileSearchStore.name]
          }
        }
      ]
    }
  });

  console.log(response.text);
}

run();
Kontrollo referencën e API-së për importFile për më shumë informacione.
Konfigurimi i ndarjes në blloqe
Kur importon një skedar në një dyqan të "Kërkimit të skedarëve", ai ndahet automatikisht në pjesë, integrohet, indeksohet dhe ngarkohet në dyqanin tënd të "Kërkimit të skedarëve". Nëse ke nevojë për më shumë kontroll mbi strategjinë e ndarjes në pjesë, mund të specifikosh një cilësim chunking_config për të caktuar një numër maksimal të kodeve për pjesë dhe numrin maksimal të kodeve të mbivendosura.
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

operation = client.file_search_stores.upload_to_file_search_store(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name,
    config={
        'chunking_config': {
          'white_space_config': {
            'max_tokens_per_chunk': 200,
            'max_overlap_tokens': 20
          }
        }
    }
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

print("Custom chunking complete.")
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

let operation = await ai.fileSearchStores.uploadToFileSearchStore({
  file: 'file.txt',
  fileSearchStoreName: fileSearchStore.name,
  config: {
    displayName: 'file-name',
    chunkingConfig: {
      whiteSpaceConfig: {
        maxTokensPerChunk: 200,
        maxOverlapTokens: 20
      }
    }
  }
});

while (!operation.done) {
  await new Promise(resolve => setTimeout(resolve, 5000));
  operation = await ai.operations.get({ operation });
}
console.log("Custom chunking complete.");
Për të përdorur dyqanin e "Kërkimit në skedar", kaloje atë si një vegël te metoda generateContent, siç tregohet në shembujt e Ngarkimit dhe Importimit.
Si funksionon
"Kërkimi i skedarëve" përdor një teknikë të quajtur kërkim semantik për të gjetur informacione që kanë lidhje me kërkesën e përdoruesit. Ndryshe nga kërkimi standard i bazuar në fjalë kyçe, kërkimi semantik kupton kuptimin dhe kontekstin e kërkesës sate.
Kur importon një skedar, ai konvertohet në përfaqësime numerike të quajtura integritete, të cilat kapin kuptimin semantik të përmbajtjes së ngarkuar. Këto integrime ruhen në një bazë të specializuar të të dhënave të "Kërkimit të skedarëve". Kur bën një kërkesë, ajo konvertohet gjithashtu në një integrim. Më pas sistemi kryen një "Kërkim në skedar" për të gjetur pjesët më të ngjashme dhe më të përshtatshme të dokumentit nga dyqani i "Kërkimit në skedar".
Nuk ka kohë për të jetuar (TTL) për integrimet; ato vazhdojnë derisa të fshihen manualisht ose kur modeli hiqet nga funksionimi. Skedarët, megjithatë, fshihen pas 48 orësh.
Këtu është një analizë e procesit për përdorimin e API-së së "Kërkimit në skedar"
uploadToFileSearchStore:
Krijo një dyqan të "Kërkimit në skedar": Një dyqan i "Kërkimit në skedar" përmban të dhënat e përpunuara nga skedarët e tu. Është kontejneri i vazhdueshëm për integrimet mbi të cilat do të funksionojë kërkimi semantik.
Ngarko një skedar dhe importo në një dyqan të "Kërkimit nëpër skedarë": Ngarko njëkohësisht një skedar dhe importo rezultatet në dyqanin e "Kërkimit nëpër skedarë". Kjo krijon një objekt të përkohshëm
File, i cili është një referencë për dokumentin tënd të papërpunuar. Këto të dhëna ndahen më pas në pjesë, konvertohen në integrime të "Kërkimit në skedarë" dhe indeksohen. ObjektiFilefshihet pas 48 orësh, ndërkohë që të dhënat e importuara në magazinën e "Kërkimit në skedarë" do të ruhen për një kohë të pacaktuar derisa të zgjedhësh t'i fshish ato.Kërko me "Kërkimin e skedarëve": Së fundi, ti përdor veglën
FileSearchnë një telefonatëgenerateContent. Në konfigurimin e veglës, ti specifikon njëFileSearchRetrievalResource, i cili të drejton teFileSearchStoreqë dëshiron të kërkosh. Kjo i tregon modelit që të kryejë një kërkim semantik në atë dyqan specifik të "Kërkimit në skedarë" për të gjetur informacionet përkatëse për të bazuar përgjigjen e tij.
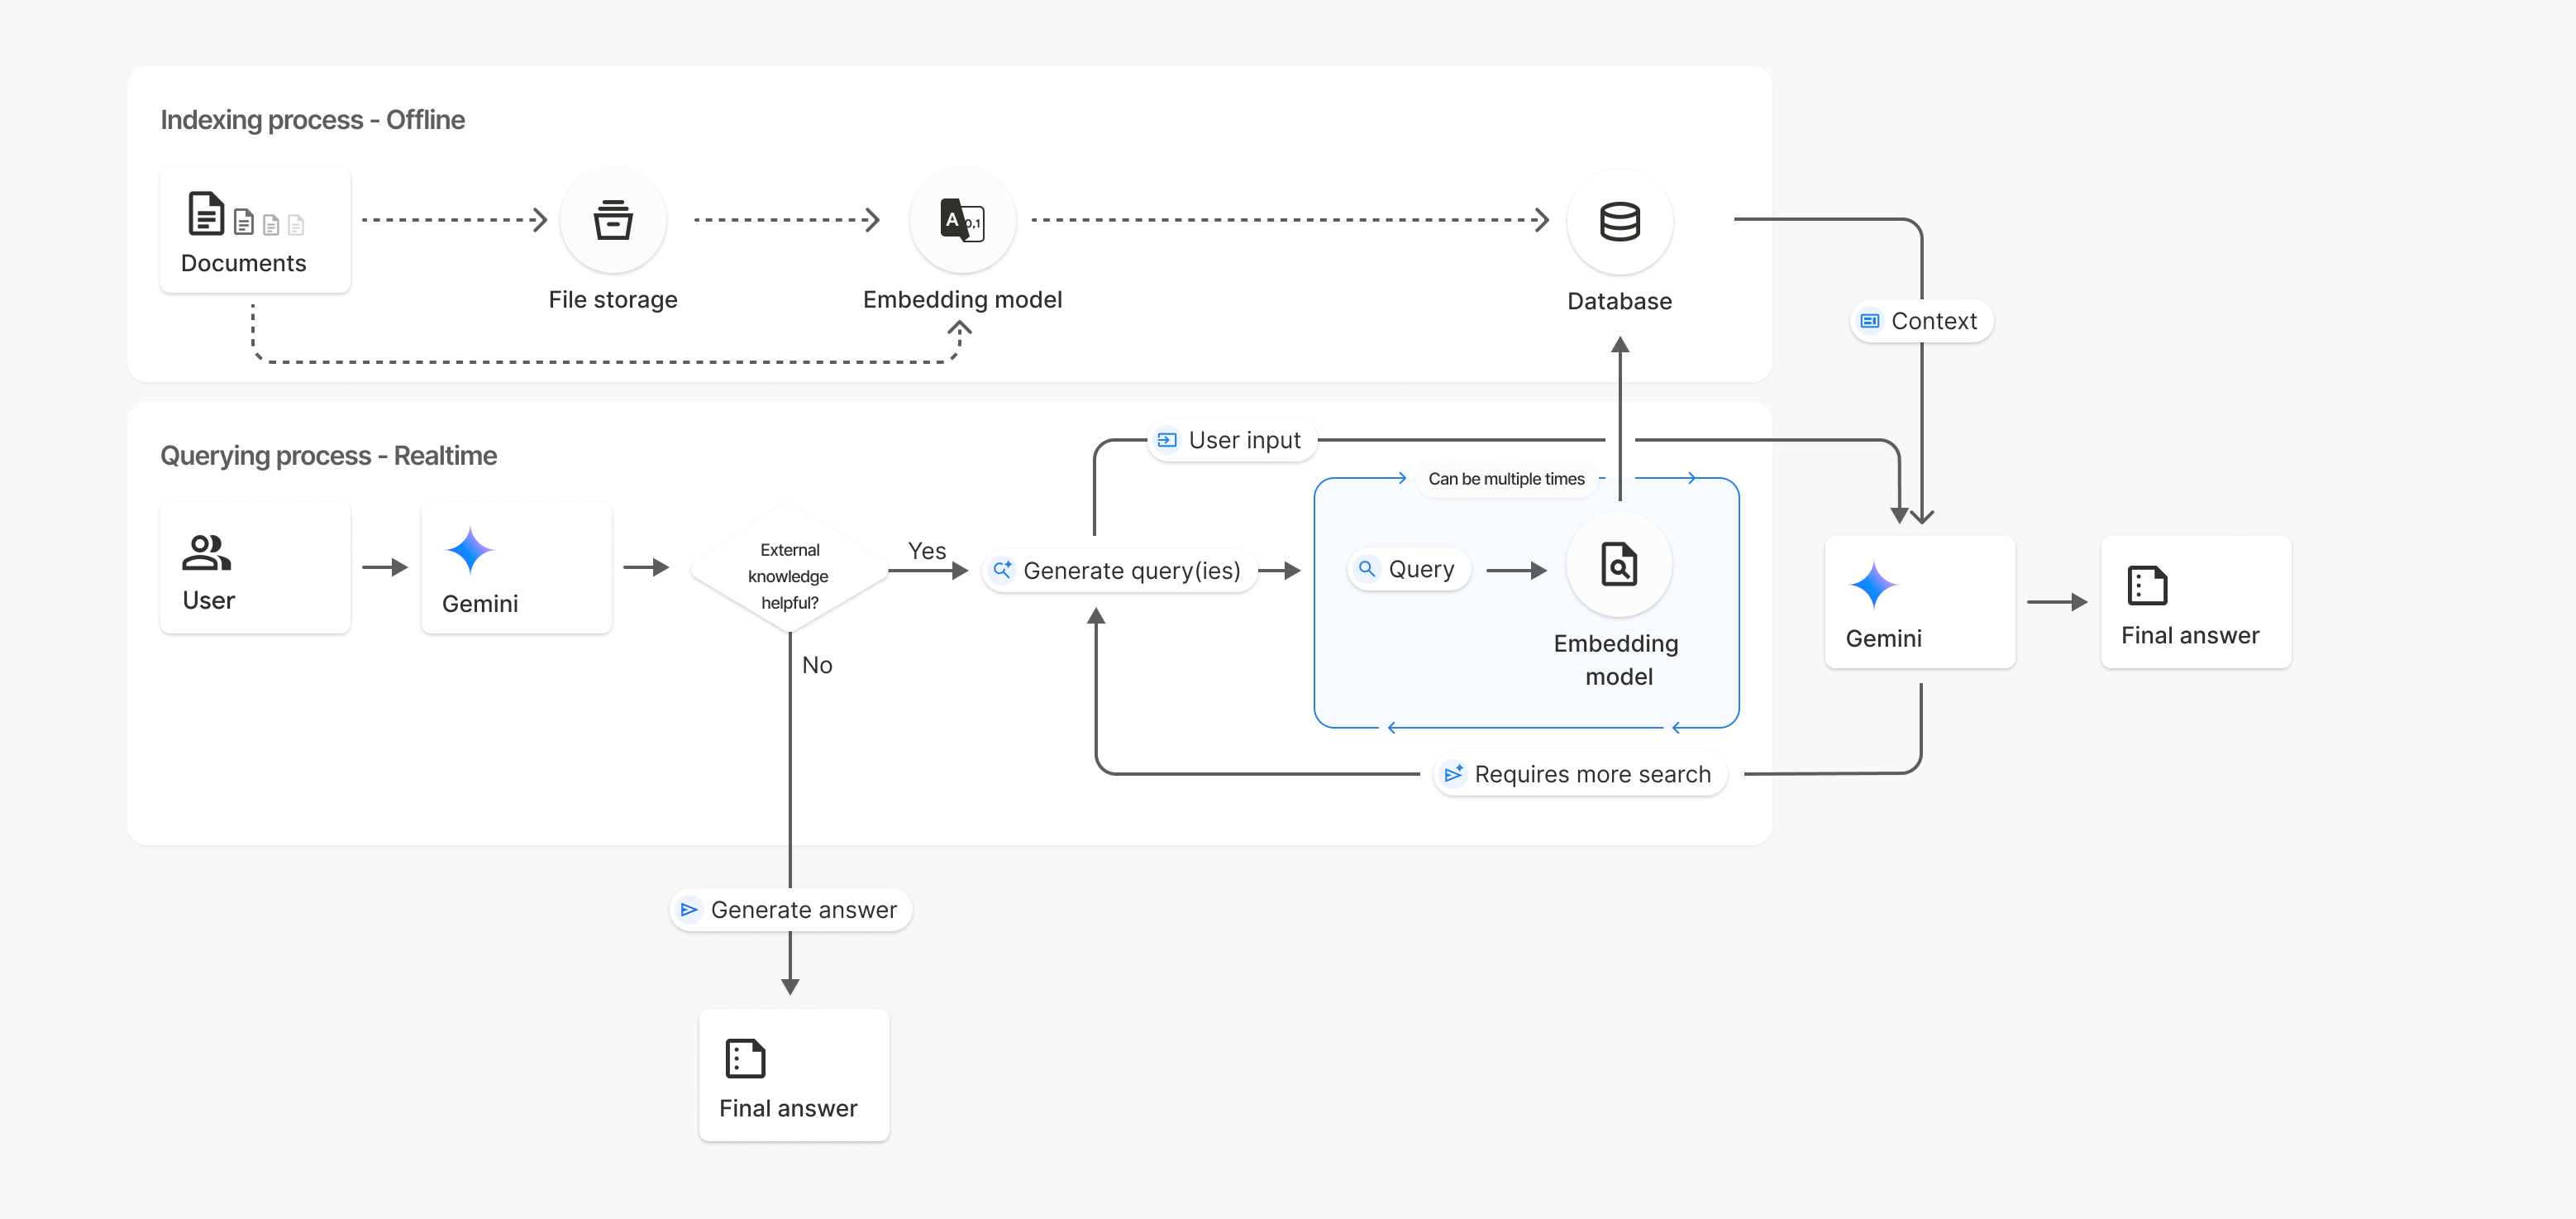
Në këtë diagram, vija me pika nga Dokumentet te Modeli i integrimit
(duke përdorur gemini-embedding-001)
përfaqëson uploadToFileSearchStore API (duke anashkaluar Ruajtjen e skedarëve).
Në rast të kundërt, përdorimi i Files API për të krijuar veçmas dhe më pas për të importuar skedarë e zhvendos procesin e indeksimit nga Dokumentet te
Hapësira ruajtëse e skedarëve dhe më pas te Modeli i integrimit.
Dyqanet e "Kërkimit në skedarë"
Një dyqan i "Kërkimit të skedarëve" është një kontejner për integrimet e dokumenteve të tua. Ndërkohë që skedarët e papërpunuar të ngarkuar nëpërmjet File API fshihen pas 48 orësh, të dhënat e importuara në një dyqan të "Kërkimit të skedarëve" ruhen për një kohë të pacaktuar derisa t'i fshish manualisht. Mund të krijosh disa dyqane të "Kërkimit në skedarë" për të organizuar dokumentet e tua. API-ja e FileSearchStore të lejon të krijosh, listosh, marrësh dhe fshish për të menaxhuar dyqanet e kërkimit të skedarëve. Emrat e dyqaneve të "Kërkimit të skedarëve" kanë fushë veprimi global.
Këtu janë disa shembuj se si të menaxhosh dyqanet e tua të "Kërkimit në skedarë":
Python
file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'my-file_search-store-123',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

for file_search_store in client.file_search_stores.list():
    print(file_search_store)

my_file_search_store = client.file_search_stores.get(name='fileSearchStores/my-file_search-store-123')

client.file_search_stores.delete(name='fileSearchStores/my-file_search-store-123', config={'force': True})
JavaScript
const fileSearchStore = await ai.fileSearchStores.create({
  config: {
    displayName: 'my-file_search-store-123',
    embeddingModel: 'models/gemini-embedding-2'
  }
});

const fileSearchStores = await ai.fileSearchStores.list();
for await (const store of fileSearchStores) {
  console.log(store);
}

const myFileSearchStore = await ai.fileSearchStores.get({
  name: 'fileSearchStores/my-file_search-store-123'
});

await ai.fileSearchStores.delete({
  name: 'fileSearchStores/my-file_search-store-123',
  config: { force: true }
});
QETËSI
curl -X POST "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=${GEMINI_API_KEY}" \
    -H "Content-Type: application/json" \
    -d '{ "displayName": "My Store", "embedding_model": "models/gemini-embedding-2" }'

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=${GEMINI_API_KEY}" \

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123?key=${GEMINI_API_KEY}"

curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123?key=${GEMINI_API_KEY}"
Dokumentet e "Kërkimit në skedarë"
Mund të menaxhosh dokumentet individuale në dyqanet e skedarëve me API-në e
Dokumenteve të "Kërkimit në skedarë" për të list çdo dokument
në një dyqan të "Kërkimit në skedarë", get informacionet për një dokument dhe delete një
dokument sipas emrit.
Python
for document_in_store in client.file_search_stores.documents.list(parent='fileSearchStores/my-file_search-store-123'):
  print(document_in_store)

file_search_document = client.file_search_stores.documents.get(name='fileSearchStores/my-file_search-store-123/documents/my_doc')
print(file_search_document)

client.file_search_stores.documents.delete(name='fileSearchStores/my-file_search-store-123/documents/my_doc')
JavaScript
const documents = await ai.fileSearchStores.documents.list({
  parent: 'fileSearchStores/my-file_search-store-123'
});
for await (const doc of documents) {
  console.log(doc);
}

const fileSearchDocument = await ai.fileSearchStores.documents.get({
  name: 'fileSearchStores/my-file_search-store-123/documents/my_doc',
});

await ai.fileSearchStores.documents.delete({
  name: 'fileSearchStores/my-file_search-store-123/documents/my_doc'
});
QETËSI
curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents?key=${GEMINI_API_KEY}"

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents/my_doc?key=${GEMINI_API_KEY}"

curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents/my_doc?key=${GEMINI_API_KEY}"
Metadatat e skedarit
Mund të shtosh metadata të personalizuara në skedarët e tu për t'i ndihmuar të filtrosh ata ose për të ofruar kontekst shtesë. Metadatat janë një grup çiftesh çelës-vlerë.
Python
op = client.file_search_stores.import_file(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name,
    custom_metadata=[
        {"key": "author", "string_value": "Robert Graves"},
        {"key": "year", "numeric_value": 1934}
    ]
)
JavaScript
let operation = await ai.fileSearchStores.importFile({
  fileSearchStoreName: fileSearchStore.name,
  fileName: sampleFile.name,
  config: {
    customMetadata: [
      { key: "author", stringValue: "Robert Graves" },
      { key: "year", numericValue: 1934 }
    ]
  }
});
Kjo është e dobishme kur ke disa dokumente në një dyqan të "Kërkimit të skedarëve" dhe dëshiron të kërkosh vetëm në një nëngrup të tyre.
Python
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Tell me about the book 'I, Claudius'",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name],
                    metadata_filter="author=Robert Graves",
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const response = await ai.models.generateContent({
  model: "gemini-3.8-flash",
  contents: "Tell me about the book 'I, Claudius'",
  config: {
    tools: [
      {
        fileSearch: {
          fileSearchStoreNames: [fileSearchStore.name],
          metadataFilter: 'author="Robert Graves"',
        }
      }
    ]
  }
});

console.log(response.text);
QETËSI
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent?key=${GEMINI_API_KEY}" \
    -H 'Content-Type: application/json' \
    -X POST \
    -d '{
            "contents": [{
                "parts":[{"text": "Tell me about the book I, Claudius"}]
            }],
            "tools": [{
                "file_search": {
                    "file_search_store_names":["'$STORE_NAME'"],
                    "metadata_filter": "author = \"Robert Graves\""
                }
            }]
        }' 2> /dev/null > response.json

cat response.json
Udhëzimet për zbatimin e sintaksës së filtrit të listës për metadata_filter mund të gjenden
në google.aip.dev/160
Kërkimi multimodal në Files
"Kërkimi multimodal i skedarëve" të lejon të integosh dhe të kërkosh në mënyrë të natyrshme nëpër imazhe, duke mundësuar aplikacione të pasura dhe multimodale të RAG.
Konfiguro modelin e integrimit
Kur krijon një FileSearchStore, duhet të zëvendësosh modelin e parazgjedhur të integrimit vetëm me tekst
për të përdorur një model multimodal. Përdor models/gemini-embedding-2 për të
përpunuar tekstin dhe imazhet.
Python
store = client.file_search_stores.create(
    config={
        "display_name": "Multimodal Catalog",
        "embedding_model": "models/gemini-embedding-2",
    }
)
JavaScript
const fileSearchStore = await ai.fileSearchStores.create({
  config: {
    displayName: "Multimodal Catalog",
    embeddingModel: "models/gemini-embedding-2",
  },
});
QETËSI
curl -X POST "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=$GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "display_name": "Multimodal Catalog",
      "embedding_model": "models/gemini-embedding-2"
    }'
Ngarko imazhe
Pasi të krijosh dyqanin me një model të integruar multimodal, mund të ngarkosh skedarë imazhesh drejtpërdrejt duke përdorur të njëjtat API-të e ngarkimit të përshkruara te Ngarko drejtpërdrejt te dyqani i "Kërkimit të skedarëve" ose Importimi i skedarëve.
Kërkesat për skedarin e imazhit:
- Skedarët e imazheve duhet të jenë maksimumi 4K x 4K pikselë në rezolucion.
- Formatet e mbështetura janë PNG, JPEG.
Citime
Kur përdor "Kërkimin në skedarë", përgjigjja e modelit mund të përfshijë citime që specifikojnë se cilat pjesë të dokumenteve të tua të ngarkuara janë përdorur për të gjeneruar përgjigjen. Kjo ndihmon me verifikimin dhe kontrollin e fakteve.
Mund të qasesh te informacionet e citimit nëpërmjet atributit grounding_metadata të përgjigjes.
Python
print(response.candidates[0].grounding_metadata)
JavaScript
console.log(JSON.stringify(response.candidates?.[0]?.groundingMetadata, null, 2));
Për informacione të detajuara mbi strukturën e metadatave themelore, shiko shembujt në File Search cookbook ose seksionin themelor të dokumenteve të Grounding with Google Search docs.
Numrat e faqeve
Kur përdor "Kërkimin në skedarë" me dokumente që kanë faqe (si p.sh. skedarët PDF), përgjigjja e modelit mund të përfshijë numrin e faqes ku është gjetur informacioni.
Mund të qasesh te këto informacione nëpërmjet atributit page_number të
retrieved_context.
Python
# Iterate through citations and check for page numbers
for chunk in response.grounding_metadata.grounding_chunks:
   if chunk.retrieved_context and chunk.retrieved_context.page_number:
       print(f"Cited Page: {chunk.retrieved_context.page_number}")
JavaScript
const groundingMetadata = response.candidates[0].groundingMetadata;
for (const chunk of groundingMetadata.groundingChunks) {
  if (chunk.retrievedContext && chunk.retrievedContext.pageNumber) {
    console.log(`Cited Page: ${chunk.retrievedContext.pageNumber}`);
  }
}
Citimet e medias
Kur modeli referon një pjesë imazhi gjatë gjenerimit, API-ja kthen një citim në metadatat e themelimit që përfshin një media_id. Mund ta përdorësh këtë ID për të shkarkuar pjesën e saktë të imazhit që ka referuar modeli. Ky media_id është
i vazhdueshëm nëpër disa thirrje kërkimi, gjë që të lejon të marrësh në mënyrë të besueshme
të njëjtin imazh ose ta ruash atë në memorien specifike duke përdorur ID-në.
Fragmenti i mëposhtëm është një shembull i përgjigjes REST:
"groundingMetadata": {
  "groundingChunks": [
    {
      "retrievedContext": {
        "title": "product_image",
        "fileSearchStore": "fileSearchStores/my-store-123",
        "media_id": "fileSearchStores/my-store-123/media/BlobId-456"
      }
    }
  ]
}
Fragmentet e mëposhtme të kodit demonstrojnë se si të marrësh media_id dhe të shkarkosh median:
Python
# Iterate through citations and download media if present
for chunk in response.grounding_metadata.grounding_chunks:
   if chunk.retrieved_context and chunk.retrieved_context.media_id:
       print(f"Cited Media ID: {chunk.retrieved_context.media_id}")
       # Download the blob using the SDK
       blob_content = client.file_search_stores.download_media(
           media_id=chunk.retrieved_context.media_id
       )
       # Save blob_content to file...
JavaScript
const groundingMetadata = response.candidates[0].groundingMetadata;
for (const chunk of groundingMetadata.groundingChunks) {
  if (chunk.retrievedContext && chunk.retrievedContext.mediaId) {
    console.log(`Cited Media ID: ${chunk.retrievedContext.mediaId}`);
    const blobContent = await ai.fileSearchStores.downloadMedia(chunk.retrievedContext.mediaId);
    // Save blobContent to file...
  }
}
QETËSI
curl -X GET "https://generativelanguage.googleapis.com/v1/fileSearchStores/my-store-123/media/BlobId-456" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Metadatat e personalizuara në të dhënat bazë
Nëse ke shtuar metadata të personalizuara në skedarët e tu, mund të qasesh te metadata themelore e përgjigjes së modelit. Kjo është e dobishme për të kaluar kontekst shtesë (si p.sh. URL-të, numrat e faqeve ose autorët) nga dokumentet e tua burimore te logjika e aplikacionit. Çdo grounding_chunk në
retrieved_context përmban këto metadata të personalizuara.
Python
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Tell me about [insert question]",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

for chunk in response.candidates[0].grounding_metadata.grounding_chunks:
    if chunk.retrieved_context:
        print(f"Text: {chunk.retrieved_context.text}")
        if chunk.retrieved_context.custom_metadata:
            for metadata in chunk.retrieved_context.custom_metadata:
                print(f"Metadata Key: {metadata.key}")
                print(f"Value: {metadata.string_value or metadata.numeric_value}")
JavaScript
const response = await ai.models.generateContent({
  model: "gemini-3.8-flash",
  contents: "Tell me about [insert question]",
  config: {
    tools: [
      {
        fileSearch: {
          fileSearchStoreNames: [fileSearchStore.name]
        }
      }
    ]
  }
});

const groundingMetadata = response.candidates[0].groundingMetadata;
groundingMetadata.groundingChunks.forEach((chunk) => {
  if (chunk.retrievedContext) {
    console.log(`Text: ${chunk.retrievedContext.text}`);
    if (chunk.retrievedContext.customMetadata) {
      chunk.retrievedContext.customMetadata.forEach((metadata) => {
        console.log(`Metadata Key: ${metadata.key}`);
        console.log(`Value: ${metadata.stringValue || metadata.numericValue}`);
      });
    }
  }
});
QETËSI
{
  "candidates": [
    {
      "content": { ... },
      "grounding_metadata": {
        "grounding_chunks": [
          {
            "retrieved_context": {
              "text": "...",
              "title": "...",
              "uri": "...",
              "custom_metadata": [
                {
                  "key": "author",
                  "string_value": "Robert Graves"
                },
                {
                  "key": "year",
                  "numeric_value": 1934
                }
              ]
            }
          }
        ],
        "grounding_supports": [ ... ]
      }
    }
  ]
}
Dalja e strukturuar
Duke filluar me modelet Gemini 3, mund të kombinosh veglën e kërkimit të skedarëve me daljet e strukturuara.
Python
from pydantic import BaseModel, Field

class Money(BaseModel):
    amount: str = Field(description="The numerical part of the amount.")
    currency: str = Field(description="The currency of amount.")

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="What is the minimum hourly wage in Tokyo right now?",
    config=types.GenerateContentConfig(
                tools=[
                    types.Tool(
                        file_search=types.FileSearch(
                            file_search_store_names=[file_search_store.name]
                        )
                    )
                ],
                response_format={"text": {"mime_type": "application/json", "schema": Money.model_json_schema()}}
      )
)
result = Money.model_validate_json(response.text)
print(result)
JavaScript
import { z } from "zod";

const moneySchema = z.object({
  amount: z.string().describe("The numerical part of the amount."),
  currency: z.string().describe("The currency of amount."),
});

async function run() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "What is the minimum hourly wage in Tokyo right now?",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [file_search_store.name],
          },
        },
      ],
      responseFormat: { text: { mimeType: "application/json", schema: z.toJSONSchema(moneySchema) } },
    },
  });

  const result = moneySchema.parse(JSON.parse(response.text));
  console.log(result);
}

run();
QETËSI
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{
      "parts": [{"text": "What is the minimum hourly wage in Tokyo right now?"}]
    }],
    "tools": [
      {
        "fileSearch": {
          "fileSearchStoreNames": ["$FILE_SEARCH_STORE_NAME"]
        }
      }
    ],
    "generationConfig": {
"responseFormat": {
  "text": {
    "mimeType": "application/json",
    "schema": {
            "type": "object",
            "properties": {
                "amount": {"type": "string", "description": "The numerical part of the amount."},
                "currency": {"type": "string", "description": "The currency of amount."}
  }
}
},
            "required": ["amount", "currency"]
        }
    }
  }'
Modelet e mbështetura
Modelet e mëposhtme mbështesin "Kërkimin në skedarë":
| Modeli | Kërkimi i skedarëve |
|---|---|
| Gemini 3.8 Flash | ✔️ |
| Gemini 3.6 Flash | ✔️ |
| Gemini 3.5 Flash-Lite | ✔️ |
| Versioni paraprak i Gemini 3.1 Pro | ✔️ |
| Gemini 3.1 Flash-Lite | ✔️ |
| Pamja paraprake e Gemini 3 Flash | ✔️ |
| Gemini 2.5 Pro | ✔️ |
| Gemini 2.5 Flash-Lite | ✔️ |
Kombinimet e mbështetura të veglave
Modelet e Gemini 3 mbështesin kombinimin e veglave të integruara (si p.sh. "Kërkimi në skedarë") me vegla të personalizuara (thirrja e funksioneve). Mëso më shumë në faqen e kombinimeve të veglave.
Llojet e mbështetura të skedarëve
"Kërkimi i skedarëve" mbështet një gamë të gjerë formatesh skedarësh, të listuara në seksionet e mëposhtme.
Llojet e skedarëve të aplikacioneve
application/dartapplication/ecmascriptapplication/jsonapplication/ms-javaapplication/mswordapplication/pdfapplication/sqlapplication/typescriptapplication/vnd.curlapplication/vnd.dartapplication/vnd.ibm.secure-containerapplication/vnd.jupyterapplication/vnd.ms-excelapplication/vnd.oasis.opendocument.textapplication/vnd.openxmlformats-officedocument.presentationml.presentationapplication/vnd.openxmlformats-officedocument.spreadsheetml.sheetapplication/vnd.openxmlformats-officedocument.wordprocessingml.documentapplication/vnd.openxmlformats-officedocument.wordprocessingml.templateapplication/x-cshapplication/x-hwpapplication/x-hwp-v5application/x-latexapplication/x-phpapplication/x-powershellapplication/x-shapplication/x-shellscriptapplication/x-texapplication/x-zshapplication/xmlapplication/zip
Llojet e skedarëve të tekstit
text/1d-interleaved-parityfectext/REDtext/SGMLtext/cache-manifesttext/calendartext/cqltext/cql-extensiontext/cql-identifiertext/csstext/csvtext/csv-schematext/dnstext/encaprtptext/enrichedtext/exampletext/fhirpathtext/flexfectext/fwdredtext/gff3text/grammar-ref-listtext/hl7v2text/htmltext/javascripttext/jcr-cndtext/jsxtext/markdowntext/mizartext/n3text/parameterstext/parityfectext/phptext/plaintext/provenance-notationtext/prs.fallenstein.rsttext/prs.lines.tagtext/prs.prop.logictext/raptorfectext/rfc822-headerstext/rtftext/rtp-enc-aescm128text/rtploopbacktext/rtxtext/sgmltext/shaclctext/shextext/spdxtext/stringstext/t140text/tab-separated-valuestext/texmacstext/trofftext/tsvtext/tsxtext/turtletext/ulpfectext/uri-listtext/vcardtext/vnd.DMClientScripttext/vnd.IPTC.NITFtext/vnd.IPTC.NewsMLtext/vnd.atext/vnd.abctext/vnd.ascii-arttext/vnd.curltext/vnd.debian.copyrighttext/vnd.dvb.subtitletext/vnd.esmertec.theme-descriptortext/vnd.exchangeabletext/vnd.familysearch.gedcomtext/vnd.ficlab.flttext/vnd.flytext/vnd.fmi.flexstortext/vnd.gmltext/vnd.graphviztext/vnd.hanstext/vnd.hgltext/vnd.in3d.3dmltext/vnd.in3d.spottext/vnd.latex-ztext/vnd.motorola.reflextext/vnd.ms-mediapackagetext/vnd.net2phone.commcenter.commandtext/vnd.radisys.msml-basic-layouttext/vnd.senx.warpscripttext/vnd.sositext/vnd.sun.j2me.app-descriptortext/vnd.trolltech.linguisttext/vnd.wap.sitext/vnd.wap.sltext/vnd.wap.wmltext/vnd.wap.wmlscripttext/vtttext/wgsltext/x-asmtext/x-bibtextext/x-bootext/x-ctext/x-c++hdrtext/x-c++srctext/x-cassandratext/x-chdrtext/x-coffeescripttext/x-componenttext/x-cshtext/x-csharptext/x-csrctext/x-cudatext/x-dtext/x-difftext/x-dsrctext/x-emacs-lisptext/x-erlangtext/x-gff3text/x-gotext/x-haskelltext/x-javatext/x-java-propertiestext/x-java-sourcetext/x-kotlintext/x-lilypondtext/x-lisptext/x-literate-haskelltext/x-luatext/x-moctext/x-objcsrctext/x-pascaltext/x-pcs-gcdtext/x-perltext/x-perl-scripttext/x-pythontext/x-python-scripttext/x-r-markdowntext/x-rsrctext/x-rsttext/x-ruby-scripttext/x-rusttext/x-sasstext/x-scalatext/x-schemetext/x-script.pythontext/x-scsstext/x-setexttext/x-sfvtext/x-shtext/x-siestatext/x-sostext/x-sqltext/x-swifttext/x-tcltext/x-textext/x-vbasictext/x-vcalendartext/xmltext/xml-dtdtext/xml-external-parsed-entitytext/yaml
Kufizimet
- API-ja e transmetimit të drejtpërdrejtë: Kërkimi i skedarëve nuk mbështetet në API-në e transmetimit të drejtpërdrejtë.
- Mospërputhshmëria e veglave: "Kërkimi në skedarë" nuk mund të kombinohet me vegla të tjera si Bazimi me "Kërko në Google", Konteksti i URL-së etj. në këtë moment.
Kufijtë e normës
File Search API ka kufijtë e mëposhtëm për të zbatuar qëndrueshmërinë e shërbimit:
- Madhësia maksimale e skedarit / kufiri për dokument: 100 MB
- Madhësia totale e hapësirave ruajtëse të "Kërkimit në skedarët e projektit" (bazuar në nivelin e përdoruesit):
- Falas: 1 GB
- Niveli 1: 10 GB
- Niveli 2: 100 GB
- Niveli 3: 1 TB
- Rekomandim: Kufizo madhësinë e çdo dyqani të "Kërkimit të skedarëve" nën 20 GB për të siguruar vonesa optimale të marrjes.
Çmimet
- Ti tarifohesh për integrimet në kohën e indeksimit bazuar në çmimet ekzistuese të integrimeve.
- Hapësira ruajtëse është pa pagesë.
- Inkorporimet e kohës së kërkesës janë pa pagesë.
- Kuponët e dokumenteve të marra tarifohen si kuponë të rregullt konteksti.
Çfarë ka më pas
- Vizito referencën e API-së për File Search Stores dhe File Search Documents.