

Gemini API, dosya arama aracı aracılığıyla veriyle artırılmış üretim ("RAG") sağlar. Dosya Arama, sağlanan bir isteme göre ilgili bilgilerin hızlı bir şekilde alınmasını sağlamak için verilerinizi içe aktarır, parçalara ayırır ve dizine ekler. Alınan bu bilgiler daha sonra model için bağlam olarak kullanılır ve modelin daha doğru ve alakalı yanıtlar vermesini sağlar. Dosya arama, gemini-embedding-001 tarafından desteklenen metin yerleştirmeleri ve gemini-embedding-2 tarafından desteklenen resim/çok formatlı yerleştirmelerle çok formatlı özellikler de sunabilir.
Sorgu sırasında dosya depolama ve yerleştirme oluşturma ücretsizdir. Yalnızca dosyalarınızı ilk kez dizine eklediğinizde yerleştirme oluşturma ve normal Gemini modeli giriş / çıkış jetonları için ödeme yaparsınız. Bu yeni faturalandırma modeli, Dosya Arama Aracı'nı hem daha kolay hem de daha uygun maliyetli hale getirir. Ayrıntılar için fiyatlandırma bölümüne bakın.
Doğrudan Dosya Arama mağazasına yükleme
Bu örnekte, dosya arama deposuna doğrudan dosya yükleme işlemi gösterilmektedir:
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

# File name will be visible in citations
file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'your-fileSearchStore-name',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

operation = client.file_search_stores.upload_to_file_search_store(
  file='sample.txt',
  file_search_store_name=file_search_store.name,
  config={
      'display_name' : 'display-file-name',
  }
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="""Can you tell me about [insert question]""",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

async function run() {
  // File name will be visible in citations
  const fileSearchStore = await ai.fileSearchStores.create({
    config: {
      displayName: 'your-fileSearchStore-name',
      embeddingModel: 'models/gemini-embedding-2'
    }
  });

  let operation = await ai.fileSearchStores.uploadToFileSearchStore({
    file: 'file.txt',
    fileSearchStoreName: fileSearchStore.name,
    config: {
      displayName: 'file-name',
    }
  });

  while (!operation.done) {
    await new Promise(resolve => setTimeout(resolve, 5000));
    operation = await ai.operations.get({ operation });
  }

  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Can you tell me about [insert question]",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [fileSearchStore.name]
          }
        }
      ]
    }
  });

  console.log(response.text);
}

run();
Daha fazla bilgi için uploadToFileSearchStore API referansını inceleyin.
Dosyaları içe aktarma
Alternatif olarak, mevcut bir dosyayı yükleyebilir ve dosya arama deponuza aktarabilirsiniz:
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

# File name will be visible in citations
sample_file = client.files.upload(file='sample.txt', config={'name': 'display_file_name'})

file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'your-fileSearchStore-name',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

operation = client.file_search_stores.import_file(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="""Can you tell me about [insert question]""",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

async function run() {
  // File name will be visible in citations
  const sampleFile = await ai.files.upload({
    file: 'sample.txt',
    config: { name: 'file-name' }
  });

  const fileSearchStore = await ai.fileSearchStores.create({
    config: {
      displayName: 'your-fileSearchStore-name',
      embeddingModel: 'models/gemini-embedding-2'
    }
  });

  let operation = await ai.fileSearchStores.importFile({
    fileSearchStoreName: fileSearchStore.name,
    fileName: sampleFile.name
  });

  while (!operation.done) {
    await new Promise(resolve => setTimeout(resolve, 5000));
    operation = await ai.operations.get({ operation: operation });
  }

  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Can you tell me about [insert question]",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [fileSearchStore.name]
          }
        }
      ]
    }
  });

  console.log(response.text);
}

run();
Daha fazla bilgi için importFile API referansına bakın.
Parçalara ayırma yapılandırması
Bir dosyayı Dosya Arama deposuna aktardığınızda dosya otomatik olarak parçalara ayrılır, yerleştirilir, dizine eklenir ve Dosya Arama deponuza yüklenir. Parçalara ayırma stratejisi üzerinde daha fazla kontrole ihtiyacınız varsa her parçadaki maksimum jeton sayısını ve maksimum çakışan jeton sayısını ayarlamak için chunking_config ayarını belirtebilirsiniz.
Python
from google import genai
from google.genai import types
import time

client = genai.Client()

operation = client.file_search_stores.upload_to_file_search_store(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name,
    config={
        'chunking_config': {
          'white_space_config': {
            'max_tokens_per_chunk': 200,
            'max_overlap_tokens': 20
          }
        }
    }
)

while not operation.done:
    time.sleep(5)
    operation = client.operations.get(operation)

print("Custom chunking complete.")
JavaScript
const { GoogleGenAI } = require('@google/genai');

const ai = new GoogleGenAI({});

let operation = await ai.fileSearchStores.uploadToFileSearchStore({
  file: 'file.txt',
  fileSearchStoreName: fileSearchStore.name,
  config: {
    displayName: 'file-name',
    chunkingConfig: {
      whiteSpaceConfig: {
        maxTokensPerChunk: 200,
        maxOverlapTokens: 20
      }
    }
  }
});

while (!operation.done) {
  await new Promise(resolve => setTimeout(resolve, 5000));
  operation = await ai.operations.get({ operation });
}
console.log("Custom chunking complete.");
Dosya Arama deponuzu kullanmak için Yükleme ve İçe aktarma örneklerinde gösterildiği gibi generateContent yöntemine araç olarak iletin.
İşleyiş şekli
Dosya Arama, kullanıcı istemiyle alakalı bilgileri bulmak için semantik arama adlı bir teknik kullanır. Standart anahtar kelime tabanlı aramanın aksine, semantik arama sorgunuzun anlamını ve bağlamını anlar.
Bir dosyayı içe aktardığınızda dosya, yüklenen içeriğin semantik anlamını yakalayan yerleştirmeler adlı sayısal gösterimlere dönüştürülür. Bu yerleştirmeler, özel bir Dosya Arama veritabanında saklanır. Yaptığınız sorgular da yerleştirmeye dönüştürülür. Ardından sistem, Dosya Arama deposundaki en benzer ve alakalı belge parçalarını bulmak için Dosya Arama işlemi gerçekleştirir.
Yerleştirmeler için geçerlilik süresi (TTL) yoktur. Bu öğeler, manuel olarak silinene veya model kullanımdan kaldırılana kadar kalır. Ancak dosyalar 48 saat sonra silinir.
File Search API'yi kullanma sürecinin dökümünü aşağıda bulabilirsiniz:
uploadToFileSearchStore
Dosya Arama mağazası oluşturma: Dosya Arama mağazası, dosyalarınızdaki işlenmiş verileri içerir. Semantik aramanın üzerinde çalışacağı yerleştirmeler için kalıcı kapsayıcıdır.
Dosya yükleme ve dosya arama mağazasına aktarma: Aynı anda dosya yükleyip sonuçları dosya arama mağazanıza aktarın. Bu işlem, ham dokümanınıza referans veren geçici bir
Filenesne oluşturur. Bu veriler daha sonra parçalara ayrılır, Dosya Arama yerleştirmelerine dönüştürülür ve dizine eklenir.Filenesnesi 48 saat sonra silinir. Dosya Arama deposuna aktarılan veriler ise siz silene kadar süresiz olarak saklanır.Dosya Arama ile sorgu: Son olarak,
FileSearcharacınıgenerateContentçağrısında kullanırsınız. Araç yapılandırmasında, aramak istediğinizFileSearchStoredeğerini işaret eden birFileSearchRetrievalResourcebelirtirsiniz. Bu, modele yanıtını temellendirmek için alakalı bilgileri bulmak üzere söz konusu dosya arama deposunda anlamsal arama yapmasını söyler.
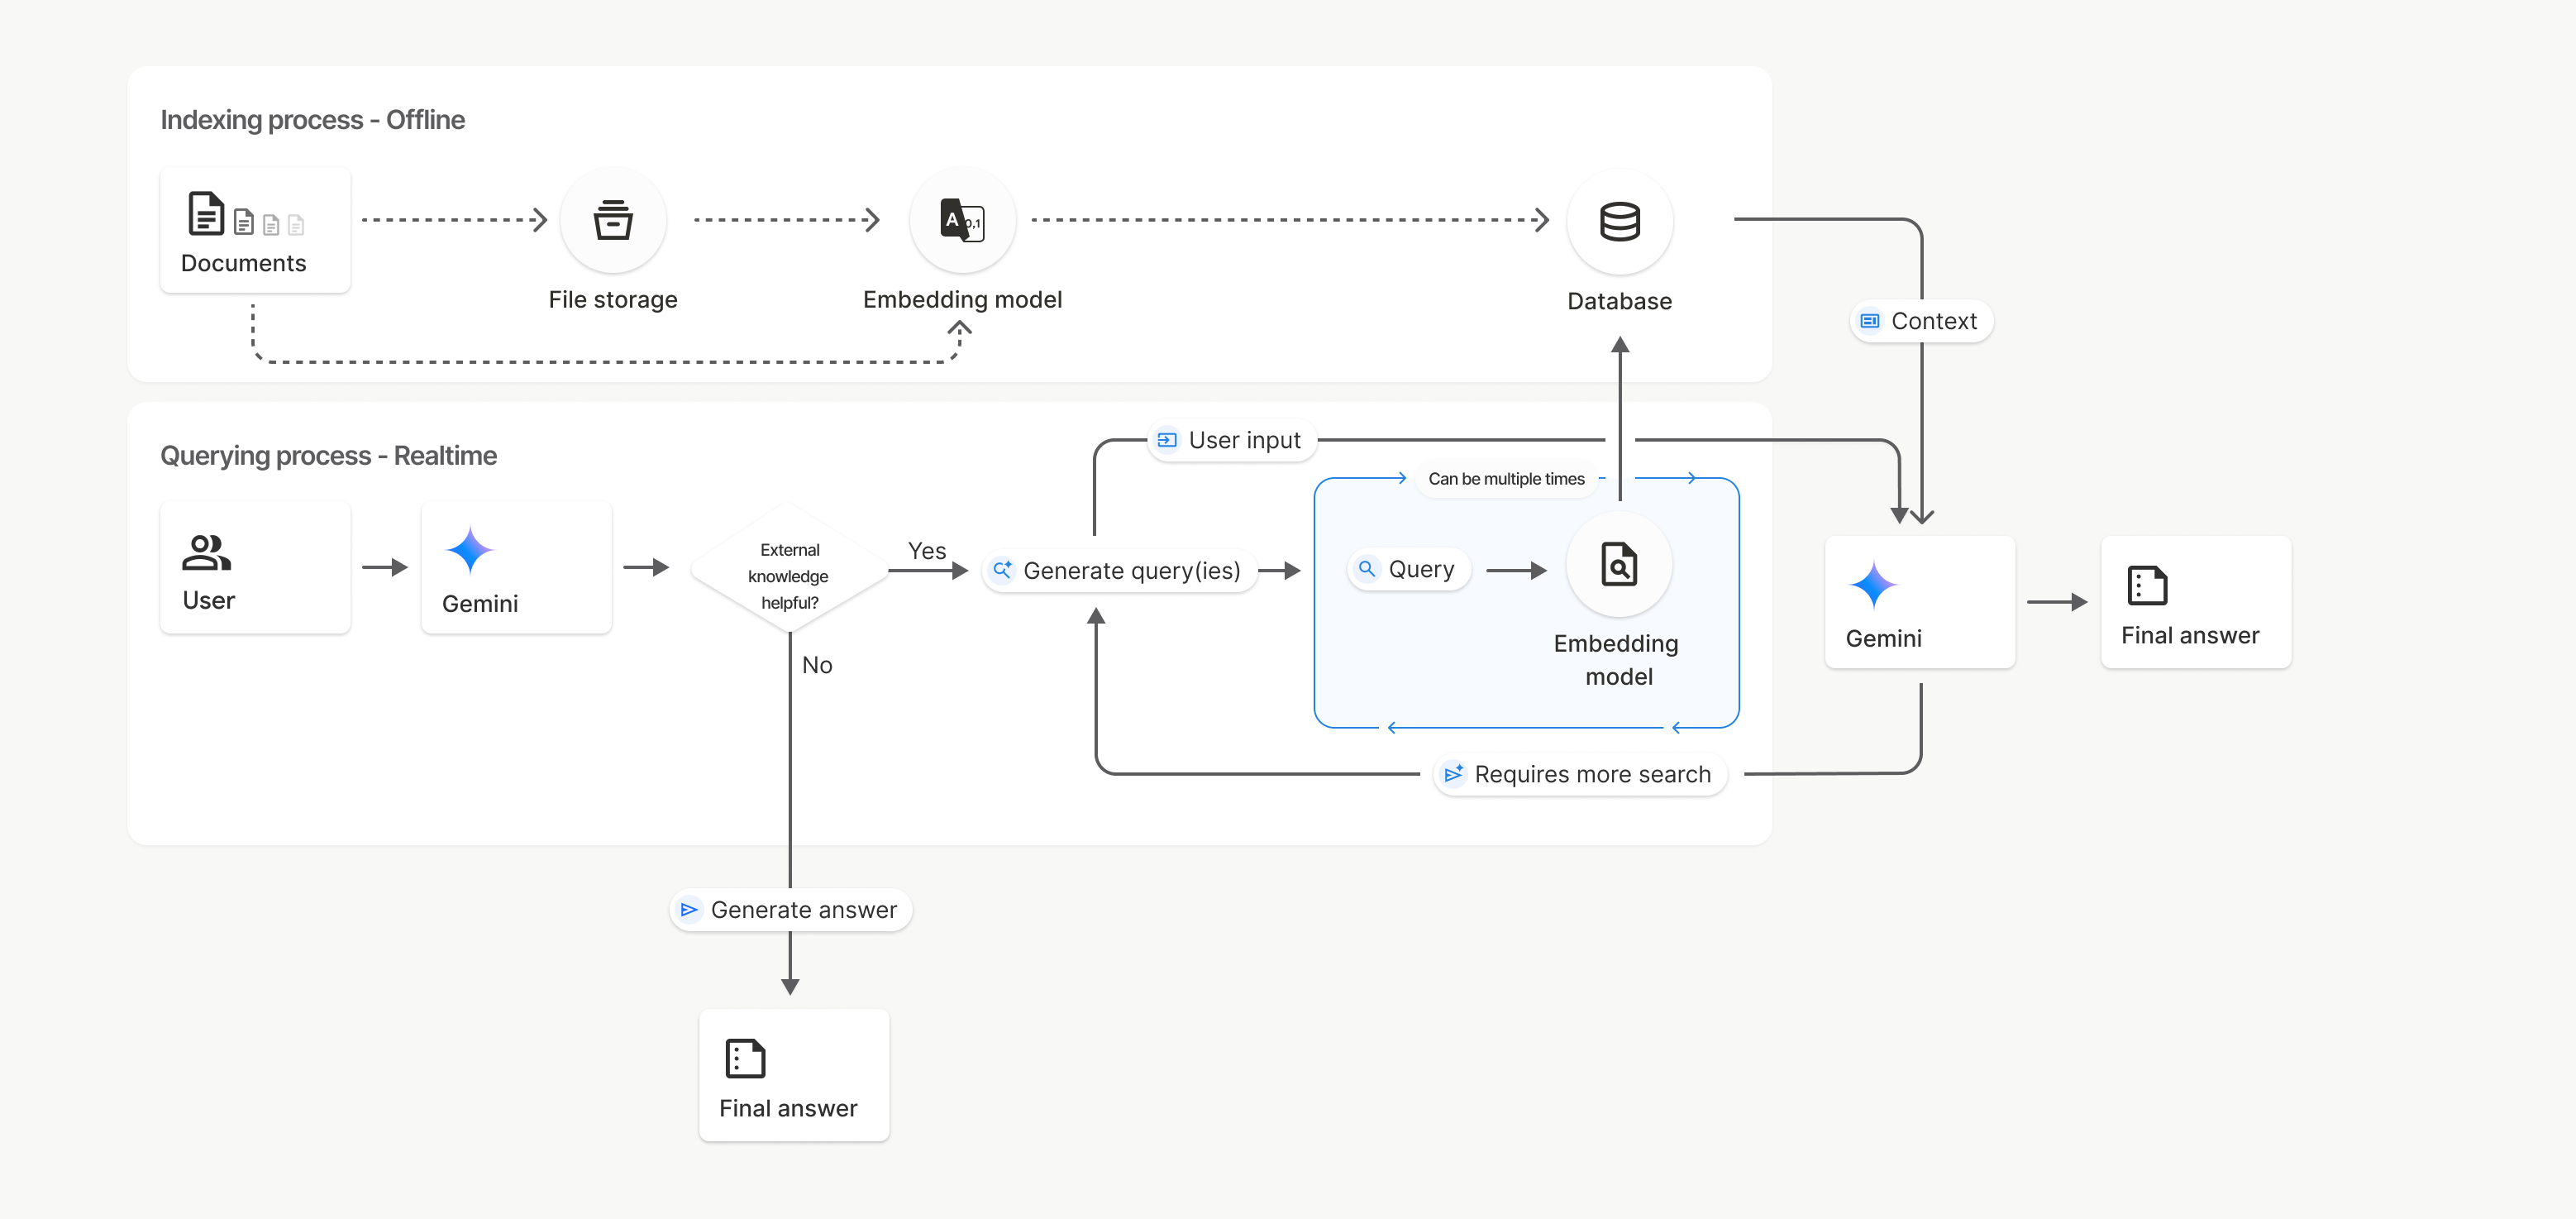
Bu diyagramda, Belgeler'den Yerleştirme modeli'ne giden noktalı çizgi (gemini-embedding-001 kullanılarak) uploadToFileSearchStore API'yi temsil eder (Dosya depolama alanı'nı atlar).
Aksi takdirde, dosyaları ayrı ayrı oluşturmak ve ardından içe aktarmak için Files API'yi kullanmak, dizine ekleme işlemini Documents'tan File storage'a ve ardından Embedding model'a taşır.
Dosya Arama mağazaları
Dosya Arama mağazası, doküman yerleştirmelerinizin bulunduğu bir kapsayıcıdır. Dosya API'si aracılığıyla yüklenen ham dosyalar 48 saat sonra silinirken, Dosya Arama mağazasına aktarılan veriler, siz manuel olarak silene kadar süresiz olarak saklanır. Dokümanlarınızı düzenlemek için birden fazla Dosya Arama deposu oluşturabilirsiniz. FileSearchStore API, dosya arama depolarınızı yönetmek için oluşturma, listeleme, alma ve silme işlemlerini yapmanıza olanak tanır. Dosya arama mağazası adları genel kapsamlıdır.
Dosya arama depolarınızı nasıl yöneteceğinize dair bazı örnekleri aşağıda bulabilirsiniz:
Python
file_search_store = client.file_search_stores.create(
    config={
        'display_name': 'my-file_search-store-123',
        'embedding_model': 'models/gemini-embedding-2'
    }
)

for file_search_store in client.file_search_stores.list():
    print(file_search_store)

my_file_search_store = client.file_search_stores.get(name='fileSearchStores/my-file_search-store-123')

client.file_search_stores.delete(name='fileSearchStores/my-file_search-store-123', config={'force': True})
JavaScript
const fileSearchStore = await ai.fileSearchStores.create({
  config: {
    displayName: 'my-file_search-store-123',
    embeddingModel: 'models/gemini-embedding-2'
  }
});

const fileSearchStores = await ai.fileSearchStores.list();
for await (const store of fileSearchStores) {
  console.log(store);
}

const myFileSearchStore = await ai.fileSearchStores.get({
  name: 'fileSearchStores/my-file_search-store-123'
});

await ai.fileSearchStores.delete({
  name: 'fileSearchStores/my-file_search-store-123',
  config: { force: true }
});
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=${GEMINI_API_KEY}" \
    -H "Content-Type: application/json" \
    -d '{ "displayName": "My Store", "embedding_model": "models/gemini-embedding-2" }'

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=${GEMINI_API_KEY}" \

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123?key=${GEMINI_API_KEY}"

curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123?key=${GEMINI_API_KEY}"
Dosya arama dokümanları
Dosya arama mağazasındaki her bir dokümanı list, bir dokümanla ilgili bilgileri get ve bir dokümanı ada göre delete için dosya mağazalarınızdaki dokümanları File Search Documents API ile ayrı ayrı yönetebilirsiniz.
Python
for document_in_store in client.file_search_stores.documents.list(parent='fileSearchStores/my-file_search-store-123'):
  print(document_in_store)

file_search_document = client.file_search_stores.documents.get(name='fileSearchStores/my-file_search-store-123/documents/my_doc')
print(file_search_document)

client.file_search_stores.documents.delete(name='fileSearchStores/my-file_search-store-123/documents/my_doc')
JavaScript
const documents = await ai.fileSearchStores.documents.list({
  parent: 'fileSearchStores/my-file_search-store-123'
});
for await (const doc of documents) {
  console.log(doc);
}

const fileSearchDocument = await ai.fileSearchStores.documents.get({
  name: 'fileSearchStores/my-file_search-store-123/documents/my_doc',
});

await ai.fileSearchStores.documents.delete({
  name: 'fileSearchStores/my-file_search-store-123/documents/my_doc'
});
REST
curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents?key=${GEMINI_API_KEY}"

curl "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents/my_doc?key=${GEMINI_API_KEY}"

curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/fileSearchStores/my-file_search-store-123/documents/my_doc?key=${GEMINI_API_KEY}"
Dosya meta verileri
Dosyalarınızı filtrelemenize yardımcı olması veya ek bağlam bilgisi sağlaması için dosyalarınıza özel meta veriler ekleyebilirsiniz. Meta veriler, anahtar/değer çiftlerinden oluşur.
Python
op = client.file_search_stores.import_file(
    file_search_store_name=file_search_store.name,
    file_name=sample_file.name,
    custom_metadata=[
        {"key": "author", "string_value": "Robert Graves"},
        {"key": "year", "numeric_value": 1934}
    ]
)
JavaScript
let operation = await ai.fileSearchStores.importFile({
  fileSearchStoreName: fileSearchStore.name,
  fileName: sampleFile.name,
  config: {
    customMetadata: [
      { key: "author", stringValue: "Robert Graves" },
      { key: "year", numericValue: 1934 }
    ]
  }
});
Bu, bir dosya arama deposunda birden fazla dokümanınız olduğunda ve yalnızca bir alt kümede arama yapmak istediğinizde kullanışlıdır.
Python
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Tell me about the book 'I, Claudius'",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name],
                    metadata_filter="author=Robert Graves",
                )
            )
        ]
    )
)

print(response.text)
JavaScript
const response = await ai.models.generateContent({
  model: "gemini-3.8-flash",
  contents: "Tell me about the book 'I, Claudius'",
  config: {
    tools: [
      {
        fileSearch: {
          fileSearchStoreNames: [fileSearchStore.name],
          metadataFilter: 'author="Robert Graves"',
        }
      }
    ]
  }
});

console.log(response.text);
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent?key=${GEMINI_API_KEY}" \
    -H 'Content-Type: application/json' \
    -X POST \
    -d '{
            "contents": [{
                "parts":[{"text": "Tell me about the book I, Claudius"}]
            }],
            "tools": [{
                "file_search": {
                    "file_search_store_names":["'$STORE_NAME'"],
                    "metadata_filter": "author = \"Robert Graves\""
                }
            }]
        }' 2> /dev/null > response.json

cat response.json
metadata_filter için liste filtresi söz dizimini uygulama ile ilgili kılavuzu google.aip.dev/160 adresinde bulabilirsiniz.
Çok formatlı dosya arama
Çok formatlı dosya arama özelliği, resimleri yerel olarak yerleştirmenize ve aramanıza olanak tanıyarak zengin ve çok formatlı RAG uygulamaları oluşturmanızı sağlar.
Yerleştirme modelini yapılandırma
FileSearchStore oluşturduğunuzda, çok formatlı bir model kullanmak için varsayılan yalnızca metin içeren yerleştirme modelini geçersiz kılmanız gerekir. Hem metinleri hem de resimleri işlemek için models/gemini-embedding-2 simgesini kullanın.
Python
store = client.file_search_stores.create(
    config={
        "display_name": "Multimodal Catalog",
        "embedding_model": "models/gemini-embedding-2",
    }
)
JavaScript
const fileSearchStore = await ai.fileSearchStores.create({
  config: {
    displayName: "Multimodal Catalog",
    embeddingModel: "models/gemini-embedding-2",
  },
});
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/fileSearchStores?key=$GEMINI_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{
      "display_name": "Multimodal Catalog",
      "embedding_model": "models/gemini-embedding-2"
    }'
Resim yükle
Mağazayı çok formatlı yerleştirme modeliyle oluşturduktan sonra, Doğrudan Dosya Arama mağazasına yükleme veya Dosyaları içe aktarma bölümünde açıklanan yükleme API'lerini kullanarak resim dosyalarını doğrudan yükleyebilirsiniz.
Resim dosyası koşulları:
- Resim dosyalarının çözünürlüğü en fazla 4K x 4K piksel olmalıdır.
- Desteklenen biçimler: PNG, JPEG.
Alıntılar
Dosya Arama'yı kullandığınızda modelin yanıtı, yüklenen dokümanlarınızın hangi bölümlerinin yanıtı oluşturmak için kullanıldığını belirten alıntılar içerebilir. Bu, doğruluk kontrolü ve doğrulamaya yardımcı olur.
Alıntı bilgilerine yanıtın grounding_metadata özelliği üzerinden erişebilirsiniz.
Python
print(response.candidates[0].grounding_metadata)
JavaScript
console.log(JSON.stringify(response.candidates?.[0]?.groundingMetadata, null, 2));
Temellendirme meta verilerinin yapısı hakkında ayrıntılı bilgi için File Search kılavuzundaki örneklere veya Google Arama ile Temellendirme belgelerinin temellendirme bölümüne bakın.
Sayfa numaraları
Dosya Arama'yı sayfaları olan dokümanlarla (ör. PDF'ler) kullandığınızda modelin yanıtı, bilgilerin bulunduğu sayfa numarasını içerebilir.
Bu bilgilere retrieved_context nesnesinin page_number özelliği aracılığıyla erişebilirsiniz.
Python
# Iterate through citations and check for page numbers
for chunk in response.grounding_metadata.grounding_chunks:
   if chunk.retrieved_context and chunk.retrieved_context.page_number:
       print(f"Cited Page: {chunk.retrieved_context.page_number}")
JavaScript
const groundingMetadata = response.candidates[0].groundingMetadata;
for (const chunk of groundingMetadata.groundingChunks) {
  if (chunk.retrievedContext && chunk.retrievedContext.pageNumber) {
    console.log(`Cited Page: ${chunk.retrievedContext.pageNumber}`);
  }
}
Medya alıntıları
Model, üretim sırasında bir resim parçasına referans verdiğinde API, dayanak meta verilerinde media_id içeren bir alıntı döndürür. Modelin referans verdiği tam görüntü parçasını indirmek için bu<0x0x0A>kimliği kullanabilirsiniz. Bu media_id, birden fazla arama çağrısında kalıcıdır. Bu sayede, aynı resmi güvenilir bir şekilde alabilir veya kimliği kullanarak önbelleğe alabilirsiniz.
Aşağıdaki snippet, örnek bir REST yanıtıdır:
"groundingMetadata": {
  "groundingChunks": [
    {
      "retrievedContext": {
        "title": "product_image",
        "fileSearchStore": "fileSearchStores/my-store-123",
        "media_id": "fileSearchStores/my-store-123/media/BlobId-456"
      }
    }
  ]
}
Aşağıdaki kod snippet'lerinde, media_id öğesinin nasıl alınacağı ve medyanın nasıl indirileceği gösterilmektedir:
Python
# Iterate through citations and download media if present
for chunk in response.grounding_metadata.grounding_chunks:
   if chunk.retrieved_context and chunk.retrieved_context.media_id:
       print(f"Cited Media ID: {chunk.retrieved_context.media_id}")
       # Download the blob using the SDK
       blob_content = client.file_search_stores.download_media(
           media_id=chunk.retrieved_context.media_id
       )
       # Save blob_content to file...
JavaScript
const groundingMetadata = response.candidates[0].groundingMetadata;
for (const chunk of groundingMetadata.groundingChunks) {
  if (chunk.retrievedContext && chunk.retrievedContext.mediaId) {
    console.log(`Cited Media ID: ${chunk.retrievedContext.mediaId}`);
    const blobContent = await ai.fileSearchStores.downloadMedia(chunk.retrievedContext.mediaId);
    // Save blobContent to file...
  }
}
REST
curl -X GET "https://generativelanguage.googleapis.com/v1/fileSearchStores/my-store-123/media/BlobId-456" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Temellendirme verilerindeki özel meta veriler
Dosyalarınıza özel meta veriler eklediyseniz bu verilere modelin yanıtının temel meta verilerinden erişebilirsiniz. Bu, kaynak belgelerinizden uygulama mantığınıza ek bağlam (URL'ler, sayfa numaraları veya yazarlar gibi) aktarmak için kullanışlıdır. retrieved_context içindeki her grounding_chunk bu özel meta verileri içerir.
Python
response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Tell me about [insert question]",
    config=types.GenerateContentConfig(
        tools=[
            types.Tool(
                file_search=types.FileSearch(
                    file_search_store_names=[file_search_store.name]
                )
            )
        ]
    )
)

for chunk in response.candidates[0].grounding_metadata.grounding_chunks:
    if chunk.retrieved_context:
        print(f"Text: {chunk.retrieved_context.text}")
        if chunk.retrieved_context.custom_metadata:
            for metadata in chunk.retrieved_context.custom_metadata:
                print(f"Metadata Key: {metadata.key}")
                print(f"Value: {metadata.string_value or metadata.numeric_value}")
JavaScript
const response = await ai.models.generateContent({
  model: "gemini-3.8-flash",
  contents: "Tell me about [insert question]",
  config: {
    tools: [
      {
        fileSearch: {
          fileSearchStoreNames: [fileSearchStore.name]
        }
      }
    ]
  }
});

const groundingMetadata = response.candidates[0].groundingMetadata;
groundingMetadata.groundingChunks.forEach((chunk) => {
  if (chunk.retrievedContext) {
    console.log(`Text: ${chunk.retrievedContext.text}`);
    if (chunk.retrievedContext.customMetadata) {
      chunk.retrievedContext.customMetadata.forEach((metadata) => {
        console.log(`Metadata Key: ${metadata.key}`);
        console.log(`Value: ${metadata.stringValue || metadata.numericValue}`);
      });
    }
  }
});
REST
{
  "candidates": [
    {
      "content": { ... },
      "grounding_metadata": {
        "grounding_chunks": [
          {
            "retrieved_context": {
              "text": "...",
              "title": "...",
              "uri": "...",
              "custom_metadata": [
                {
                  "key": "author",
                  "string_value": "Robert Graves"
                },
                {
                  "key": "year",
                  "numeric_value": 1934
                }
              ]
            }
          }
        ],
        "grounding_supports": [ ... ]
      }
    }
  ]
}
Yapılandırılmış çıkış
Gemini 3 modellerinden itibaren, dosya arama aracını yapılandırılmış çıkışlarla birlikte kullanabilirsiniz.
Python
from pydantic import BaseModel, Field

class Money(BaseModel):
    amount: str = Field(description="The numerical part of the amount.")
    currency: str = Field(description="The currency of amount.")

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="What is the minimum hourly wage in Tokyo right now?",
    config=types.GenerateContentConfig(
                tools=[
                    types.Tool(
                        file_search=types.FileSearch(
                            file_search_store_names=[file_search_store.name]
                        )
                    )
                ],
                response_format={"text": {"mime_type": "application/json", "schema": Money.model_json_schema()}}
      )
)
result = Money.model_validate_json(response.text)
print(result)
JavaScript
import { z } from "zod";

const moneySchema = z.object({
  amount: z.string().describe("The numerical part of the amount."),
  currency: z.string().describe("The currency of amount."),
});

async function run() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "What is the minimum hourly wage in Tokyo right now?",
    config: {
      tools: [
        {
          fileSearch: {
            fileSearchStoreNames: [file_search_store.name],
          },
        },
      ],
      responseFormat: { text: { mimeType: "application/json", schema: z.toJSONSchema(moneySchema) } },
    },
  });

  const result = moneySchema.parse(JSON.parse(response.text));
  console.log(result);
}

run();
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{
      "parts": [{"text": "What is the minimum hourly wage in Tokyo right now?"}]
    }],
    "tools": [
      {
        "fileSearch": {
          "fileSearchStoreNames": ["$FILE_SEARCH_STORE_NAME"]
        }
      }
    ],
    "generationConfig": {
"responseFormat": {
  "text": {
    "mimeType": "application/json",
    "schema": {
            "type": "object",
            "properties": {
                "amount": {"type": "string", "description": "The numerical part of the amount."},
                "currency": {"type": "string", "description": "The currency of amount."}
  }
}
},
            "required": ["amount", "currency"]
        }
    }
  }'
Desteklenen modeller
Aşağıdaki modeller Dosya Arama'yı destekler:
| Model | Dosya Arama |
|---|---|
| Gemini 4 Argon | ✔️ |
| Gemini 3.8 Flash | ✔️ |
| Gemini 3.6 Flash | ✔️ |
| Gemini 3.5 Flash-Lite | ✔️ |
| Gemini 3.1 Pro Preview | ✔️ |
| Gemini 3.1 Flash-Lite | ✔️ |
| Gemini 3 Flash Preview | ✔️ |
| Gemini 2.5 Pro | ✔️ |
| Gemini 2.5 Flash-Lite | ✔️ |
Desteklenen araç kombinasyonları
Gemini 4 ve Gemini 3 modelleri, yerleşik araçların (ör. Dosya Arama) özel araçlarla (işlev çağrısı) birleştirilmesini destekler. Araç kombinasyonları sayfasından daha fazla bilgi edinebilirsiniz.
Desteklenen dosya türleri
Dosya Arama, aşağıdaki bölümlerde listelenen çok çeşitli dosya biçimlerini destekler.
Uygulama dosyası türleri
application/dartapplication/ecmascriptapplication/jsonapplication/ms-javaapplication/mswordapplication/pdfapplication/sqlapplication/typescriptapplication/vnd.curlapplication/vnd.dartapplication/vnd.ibm.secure-containerapplication/vnd.jupyterapplication/vnd.ms-excelapplication/vnd.oasis.opendocument.textapplication/vnd.openxmlformats-officedocument.presentationml.presentationapplication/vnd.openxmlformats-officedocument.spreadsheetml.sheetapplication/vnd.openxmlformats-officedocument.wordprocessingml.documentapplication/vnd.openxmlformats-officedocument.wordprocessingml.templateapplication/x-cshapplication/x-hwpapplication/x-hwp-v5application/x-latexapplication/x-phpapplication/x-powershellapplication/x-shapplication/x-shellscriptapplication/x-texapplication/x-zshapplication/xmlapplication/zip
Metin dosyası türleri
text/1d-interleaved-parityfectext/REDtext/SGMLtext/cache-manifesttext/calendartext/cqltext/cql-extensiontext/cql-identifiertext/csstext/csvtext/csv-schematext/dnstext/encaprtptext/enrichedtext/exampletext/fhirpathtext/flexfectext/fwdredtext/gff3text/grammar-ref-listtext/hl7v2text/htmltext/javascripttext/jcr-cndtext/jsxtext/markdowntext/mizartext/n3text/parameterstext/parityfectext/phptext/plaintext/provenance-notationtext/prs.fallenstein.rsttext/prs.lines.tagtext/prs.prop.logictext/raptorfectext/rfc822-headerstext/rtftext/rtp-enc-aescm128text/rtploopbacktext/rtxtext/sgmltext/shaclctext/shextext/spdxtext/stringstext/t140text/tab-separated-valuestext/texmacstext/trofftext/tsvtext/tsxtext/turtletext/ulpfectext/uri-listtext/vcardtext/vnd.DMClientScripttext/vnd.IPTC.NITFtext/vnd.IPTC.NewsMLtext/vnd.atext/vnd.abctext/vnd.ascii-arttext/vnd.curltext/vnd.debian.copyrighttext/vnd.dvb.subtitletext/vnd.esmertec.theme-descriptortext/vnd.exchangeabletext/vnd.familysearch.gedcomtext/vnd.ficlab.flttext/vnd.flytext/vnd.fmi.flexstortext/vnd.gmltext/vnd.graphviztext/vnd.hanstext/vnd.hgltext/vnd.in3d.3dmltext/vnd.in3d.spottext/vnd.latex-ztext/vnd.motorola.reflextext/vnd.ms-mediapackagetext/vnd.net2phone.commcenter.commandtext/vnd.radisys.msml-basic-layouttext/vnd.senx.warpscripttext/vnd.sositext/vnd.sun.j2me.app-descriptortext/vnd.trolltech.linguisttext/vnd.wap.sitext/vnd.wap.sltext/vnd.wap.wmltext/vnd.wap.wmlscripttext/vtttext/wgsltext/x-asmtext/x-bibtextext/x-bootext/x-ctext/x-c++hdrtext/x-c++srctext/x-cassandratext/x-chdrtext/x-coffeescripttext/x-componenttext/x-cshtext/x-csharptext/x-csrctext/x-cudatext/x-dtext/x-difftext/x-dsrctext/x-emacs-lisptext/x-erlangtext/x-gff3text/x-gotext/x-haskelltext/x-javatext/x-java-propertiestext/x-java-sourcetext/x-kotlintext/x-lilypondtext/x-lisptext/x-literate-haskelltext/x-luatext/x-moctext/x-objcsrctext/x-pascaltext/x-pcs-gcdtext/x-perltext/x-perl-scripttext/x-pythontext/x-python-scripttext/x-r-markdowntext/x-rsrctext/x-rsttext/x-ruby-scripttext/x-rusttext/x-sasstext/x-scalatext/x-schemetext/x-script.pythontext/x-scsstext/x-setexttext/x-sfvtext/x-shtext/x-siestatext/x-sostext/x-sqltext/x-swifttext/x-tcltext/x-textext/x-vbasictext/x-vcalendartext/xmltext/xml-dtdtext/xml-external-parsed-entitytext/yaml
Sınırlamalar
- Live API: Dosya Arama, Live API'de desteklenmez.
- Araç uyumsuzluğu: Dosya Arama şu anda Google Arama ile Temellendirme, URL Bağlamı gibi diğer araçlarla birlikte kullanılamaz.
Hız sınırları
File Search API, hizmet kararlılığını sağlamak için aşağıdaki sınırlara sahiptir:
- Maksimum dosya boyutu / belge başına sınır: 100 MB
- Proje dosya arama depolarının toplam boyutu (kullanıcı katmanına göre):
- Ücretsiz: 1 GB
- 1. Katman: 10 GB
- 2. katman: 100 GB
- 3. katman: 1 TB
- Öneri: Optimal alma gecikmeleri sağlamak için her Dosya Arama deposunun boyutunu 20 GB'ın altında tutun.
Fiyatlandırma
- Dizin oluşturma sırasında yerleştirmeler için mevcut yerleştirme fiyatlandırmasına göre ücretlendirilirsiniz.
- Depolama alanı ücretsizdir.
- Sorgu zamanı yerleştirmeleri ücretsizdir.
- Alınan belge parçaları, normal bağlam parçaları olarak ücretlendirilir.
Sırada ne var?
- File Search Stores ve File Search Documents için API referansını ziyaret edin.