

Modelet ER (arsyetimi i mishëruar) të Gemini Robotics janë modele të gjuhës së vizionit (VLM) që i lejojnë robotët të perceptojnë dhe të bashkëveprojnë me botën fizike. Ata interpretojnë të dhënat vizuale, kryejnë arsyetim hapësinor dhe kohor, planifikojnë detyra me shumë hapa dhe orkestrojnë robotë dhe mjete.
Modele
Modeli Gemini Robotics ER 2 është modeli më i fundit në Gemini Robotics. Është modeli ynë i përditësuar i arsyetimit që u mundëson robotëve të kuptojnë me saktësi mjedisin e tyre. Ai specializohet në aftësitë e arsyetimit të mishëruar, siç është orkestrimi agjentik i robotëve (p.sh. duke përdorur VLA), kuptimi i videos së robotit duke përfshirë kuptimin e progresit dhe zbulimin e suksesit, leximin e instrumenteve, drejtimin dhe arsyetimin hapësinor.
Modeli Gemini Robotics ER 2 prezanton dy pika fundore të modelit:
-
gemini-robotics-er-2-preview: Modeli standard ER 2. Ndërtohet mbi Gemini 3.5 Flash me arsyetim hapësinor të përmirësuar, gjetje të momenteve video, klasifikim të progresit të videos, orkestrim me shumë robotë dhe përdorim mjetesh me shumë hapa. -
gemini-robotics-er-2-streaming-preview: Optimizuar për transmetim në kohë reale nëpërmjet Live API . Përdorni këtë model për agjentë robotikë me vonesë të ulët që përpunojnë të dhëna të vazhdueshme audio dhe video.
Nëse po përdorni Gemini Robotics ER 1.6, përditësojeni në Gemini Robotics ER 2 duke zëvendësuar model="gemini-robotics-er-1.6-preview" me model="gemini-robotics-er-2-preview" ose model="gemini-robotics-er-2-streaming-preview" në thirrjet tuaja API. Vini re se modeli Gemini Robotics ER 1.6 do të mbyllet në fund të gushtit .
Provoni Gemini Robotics ER 2 në Google AI Studio
Aftësitë e robotikës
Gemini Robotics ER mbështet një gamë të gjerë aftësish arsyetimi të mishëruara. Zgjidhni një aftësi për të mësuar më shumë:
| Aftësia | Përshkrimi | Udhëzues |
|---|---|---|
| Arsyetimi hapësinor | Trego objekte, gjurmoji ato në video, zbuloji me anë të kutive kufizuese, planifiko trajektore. | Arsyetimi hapësinor |
| Vizioni agjentik | Përdorni ekzekutimin e kodit për të përmirësuar aftësi të tjera duke shfrytëzuar mjetet e manipulimit të imazheve. | Vizioni agjentik |
| Orkestrimi i detyrave | Kombinoni arsyetimin hapësinor me API-të e robotëve të personalizuar për të përfunduar detyra me horizont të gjatë. | Orkestrimi i detyrave |
| Transmetim (vetëm pika fundore e transmetimit Gemini Robotics ER 2) | Transmetim bidirektiv për agjentë robotë në kohë reale me thirrje të funksioneve me latencë të ulët. | Transmetim për robotikë |
| Progresi i videos (vetëm Gemini Robotics ER 2) | Gjetja e momenteve dhe klasifikimi i progresit nga transmetimet e vazhdueshme të videos. | Kuptimi i videos |
Fillimi
Shembulli i mëposhtëm gjen objektet në një imazh dhe kthen koordinatat dhe etiketat e tyre të normalizuara 2D. Mund ta kaloni këtë rezultat direkt në një API robotike ose një model VLA për të gjeneruar veprime të robotit.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
PUSHTIM
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
Rezultati do të jetë një varg JSON që përmban objekte, secila me një point (koordinatat e normalizuara [y, x] ) dhe një label që identifikon objektin.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
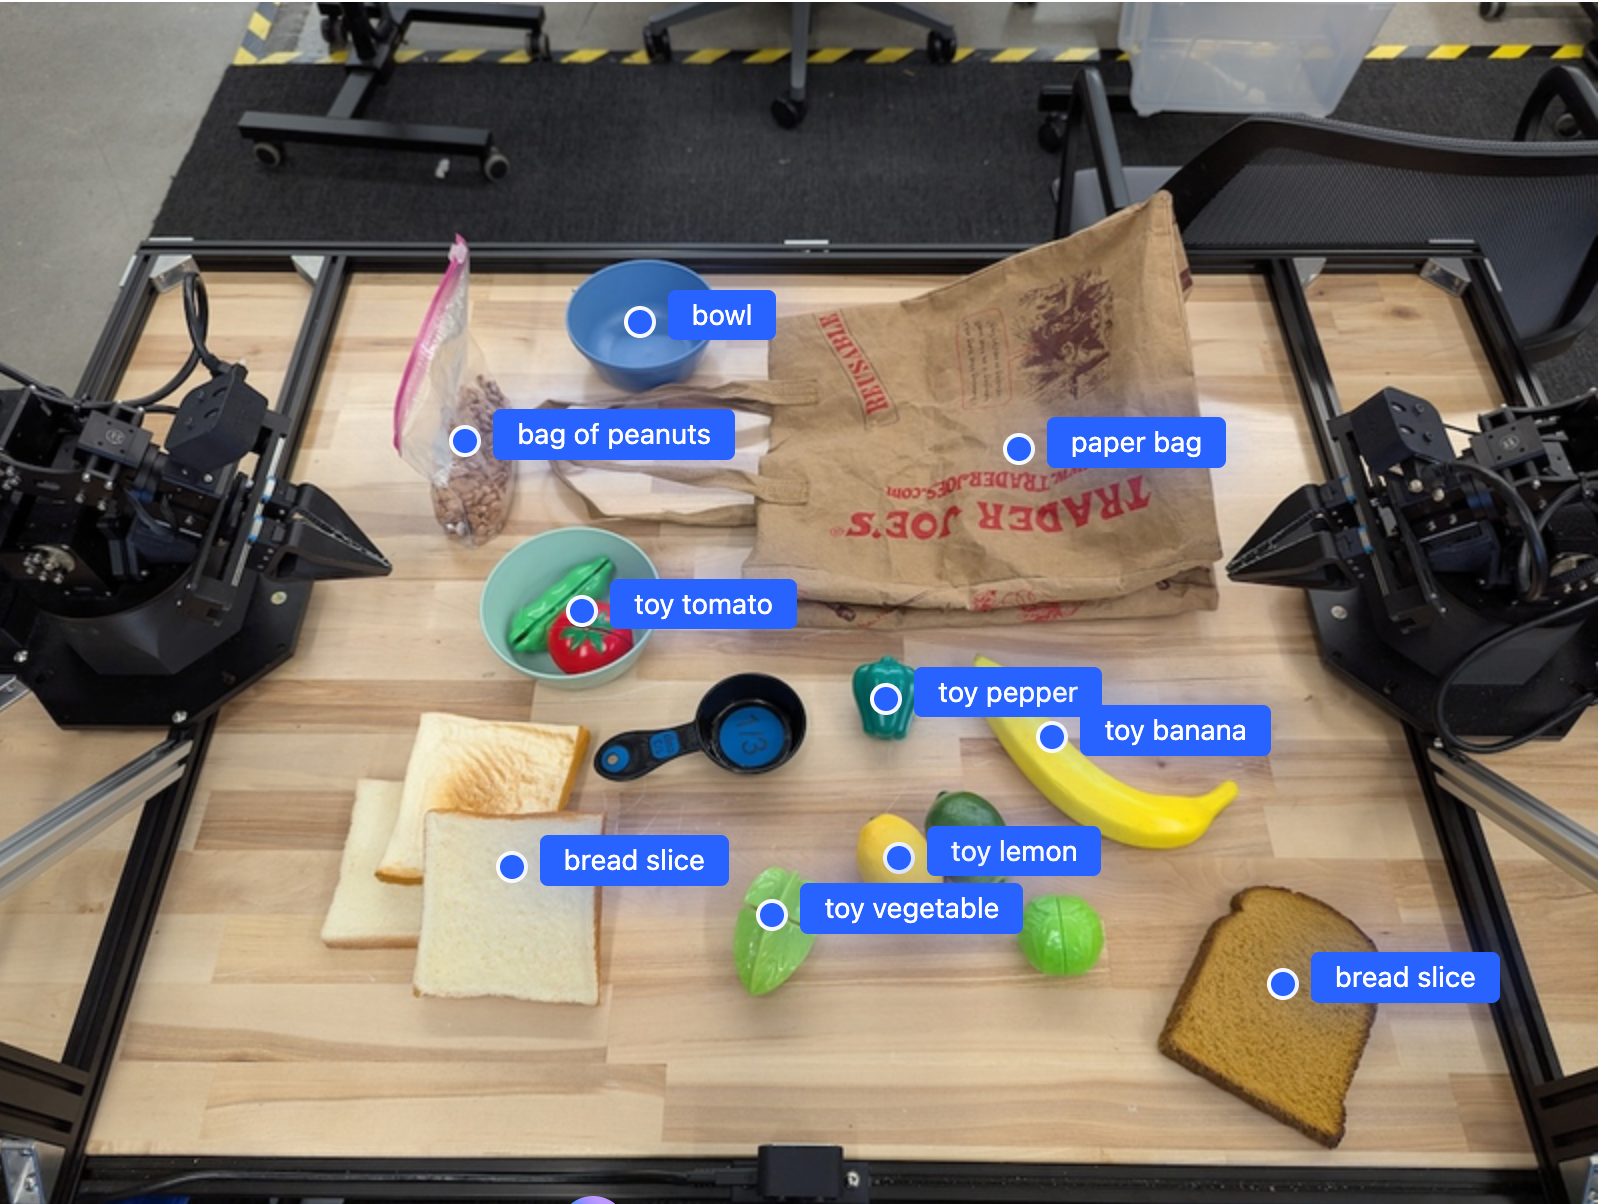
Imazhi i mëposhtëm është një shembull se si mund të shfaqen këto pika:
Si funksionon
Gemini Robotics ER merr të dhëna hyrëse imazhi, videoje ose audioje me udhëzime në gjuhën natyrore. Ai identifikon objektet, arsyet rreth kontekstit të skenës dhe marrëdhëniet hapësinore, dhe kthen të dhëna të strukturuara si koordinata ose kuti kufizuese.
Gemini Robotics ER është gjithashtu agjentik: ai i ndan detyrat komplekse në nën-detyra dhe i ekzekuton ato duke thirrur funksionet e robotit tuaj ose duke ekzekutuar kodin e gjeneruar. Për shembull, "vendos mollën në tas" bëhet një sekuencë hapash për të gjetur, kapur dhe vendosur.
Shihni Thirrja e Funksionit për detaje se si Gemini ekzekuton thirrjet e mjeteve.
Siguria
Ndërsa Gemini Robotics ER u ndërtua duke pasur parasysh sigurinë, është përgjegjësia juaj të ruani një mjedis të sigurt rreth robotit. Modelet gjeneruese të IA-së mund të bëjnë gabime dhe robotët fizikë mund të shkaktojnë dëme. Për të mësuar më shumë, vizitoni faqen e sigurisë së robotikës në Google DeepMind .
Praktikat më të mira
Përdorni gjuhë të thjeshtë dhe natyrale. Përshkruani se çfarë doni që roboti të bëjë ashtu siç do të bënit me një person. Nëse një term nuk funksionon, provoni një sinonim të zakonshëm.
Optimizoni të dhënat vizuale. Pritini ose zmadhoni objektet e vogla ose të paqarta përpara se të dërgoni imazhin. Ndriçimi dhe kontrasti i ulët i ngjyrave mund të ndikojnë në zbulimin.
Ndani detyrat komplekse në hapa. Dërgoni çdo hap si një kërkesë të veçantë për ta mbajtur modelin të fokusuar dhe për të përmirësuar saktësinë.
Kryeni pyetje të shumëfishta dhe nxirrni rezultate mesatare për detyra me precizion të lartë. Kjo qasje konsensusi zvogëlon variancën në rezultatet hapësinore.
Kufizime
Merrni parasysh kufizimet e mëposhtme kur zhvilloni me Gemini Robotics ER:
- Kufizimet e çelësit API: API Gemini nuk pranon kërkesa nga çelësat API të pakufizuar dhe kthen një gabim
403 Forbidden. Siguroni çelësin tuaj API duke shtuar kufizime në AI Studio . Shihni Siguroni çelësat API të pakufizuar për detaje. - Vonesa kundrejt performancës: Pyetjet komplekse, të dhënat hyrëse me rezolucion të lartë ose nivelet e larta të të menduarit mund të çojnë në kohë më të gjata përpunimi. Për nivelin e të menduarit, përdorni nivelin mesatar për një ekuilibër të mirë midis latencës dhe performancës.
- Halucinacione: Ashtu si të gjitha modelet e mëdha gjuhësore, modelet Gemini Robotics ER mund të "halucinojnë" herë pas here ose të japin informacion të pasaktë, veçanërisht për kërkesa të paqarta ose të dhëna jashtë shpërndarjes.
- Varësia nga cilësia e mesazhit të dhënë: Cilësia e rezultatit varet nga qartësia e mesazhit të dhënë në hyrje. Përdorni mesazhe specifike dhe të strukturuara mirë.
- Kostoja llogaritëse: Ekzekutimi i modelit, veçanërisht me hyrje video ose
thinking_budgettë lartë, konsumon burime llogaritëse dhe shkakton kosto. Shihni faqen e të menduarit për më shumë detaje. - Llojet e të dhënave hyrëse: Shihni temat e mëposhtme për detaje mbi kufizimet për secilin modalitet.
Njoftim për Privatësinë
Ju pranoni që modelet e referuara në këtë dokument ("Modelet e Robotikës") shfrytëzojnë të dhënat video dhe audio për të operuar dhe lëvizur harduerin tuaj në përputhje me udhëzimet tuaja. Prandaj, ju mund të operoni Modelet e Robotikës në mënyrë që të dhënat nga persona të identifikueshëm, siç janë zëri, imazhet dhe të dhënat e ngjashmërisë ("Të Dhënat Personale"), të mblidhen nga Modelet e Robotikës. Nëse zgjidhni të operoni Modelet e Robotikës në një mënyrë që mbledh të Dhëna Personale, ju pranoni se nuk do të lejoni asnjë person të identifikueshëm të bashkëveprojë me, ose të jetë i pranishëm në zonën përreth, Modeleve të Robotikës, përveç nëse dhe derisa personat e tillë të identifikueshëm të jenë njoftuar mjaftueshëm dhe të kenë dhënë pëlqimin për faktin se të Dhënat e tyre Personale mund t'i ofrohen dhe të përdoren nga Google, siç përshkruhet në Kushtet Shtesë të Shërbimit të Gemini API që gjenden në https://ai.google.dev/gemini-api/terms ("Kushtet"), duke përfshirë edhe në përputhje me seksionin e titulluar "Si i Përdor Google të Dhënat Tuaja". Ju do të siguroheni që një njoftim i tillë lejon mbledhjen dhe përdorimin e të Dhënave Personale siç përcaktohet në Kushte, dhe do të bëni përpjekje të arsyeshme komerciale për të minimizuar mbledhjen dhe shpërndarjen e të Dhënave Personale duke përdorur teknika të tilla si mjegullimi i fytyrës dhe operimi i Modeleve Robotike në zona që nuk përmbajnë persona të identifikueshëm në masën e praktikueshme.
Çmimet
Për informacion të detajuar mbi çmimet dhe rajonet e disponueshme, referojuni faqes së çmimeve .
Pikat fundore të modelit
Pamje paraprake e Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e transmetimit të Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-streaming-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Nuk mbështetet Mbështetur Nuk mbështetet |
| Opsionet e konsumit të | Nuk mbështetet Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e Gemini Robotics ER 1.6
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-1.6-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Dhjetor 2025 |
| i njohurive | Janar 2025 |
Çfarë vjen më pas
- Arsyetimi hapësinor — drejtimi, ndjekja, kutitë kufizuese, trajektore.
- Aftësitë agjentike — ekzekutimi i kodit, leximi i instrumenteve, shënimi i imazheve.
- Orkestrimi i detyrave — detyra me horizont të gjatë me API-të e robotëve të personalizuar.
- Robotikë me transmetim — transmetim dypalësh në kohë reale (vetëm Gemini Robotics ER 2).
- Kuptimi i videos — gjetja e momenteve dhe klasifikimi i progresit (vetëm Gemini Robotics ER 2).
- Siguria në robotikën e Google DeepMind — hulumtimi i sigurisë që qëndron pas familjes së modeleve.
Modelet ER (arsyetimi i mishëruar) të Gemini Robotics janë modele të gjuhës së vizionit (VLM) që i lejojnë robotët të perceptojnë dhe të bashkëveprojnë me botën fizike. Ata interpretojnë të dhënat vizuale, kryejnë arsyetim hapësinor dhe kohor, planifikojnë detyra me shumë hapa dhe orkestrojnë robotë dhe mjete.
Modele
Modeli Gemini Robotics ER 2 është modeli më i fundit në Gemini Robotics. Është modeli ynë i përditësuar i arsyetimit që u mundëson robotëve të kuptojnë me saktësi mjedisin e tyre. Ai specializohet në aftësitë e arsyetimit të mishëruar, siç është orkestrimi agjentik i robotëve (p.sh. duke përdorur VLA), kuptimi i videos së robotit duke përfshirë kuptimin e progresit dhe zbulimin e suksesit, leximin e instrumenteve, drejtimin dhe arsyetimin hapësinor.
Modeli Gemini Robotics ER 2 prezanton dy pika fundore të modelit:
-
gemini-robotics-er-2-preview: Modeli standard ER 2. Ndërtohet mbi Gemini 3.5 Flash me arsyetim hapësinor të përmirësuar, gjetje të momenteve video, klasifikim të progresit të videos, orkestrim me shumë robotë dhe përdorim mjetesh me shumë hapa. -
gemini-robotics-er-2-streaming-preview: Optimizuar për transmetim në kohë reale nëpërmjet Live API . Përdorni këtë model për agjentë robotikë me vonesë të ulët që përpunojnë të dhëna të vazhdueshme audio dhe video.
Nëse po përdorni Gemini Robotics ER 1.6, përditësojeni në Gemini Robotics ER 2 duke zëvendësuar model="gemini-robotics-er-1.6-preview" me model="gemini-robotics-er-2-preview" ose model="gemini-robotics-er-2-streaming-preview" në thirrjet tuaja API. Vini re se modeli Gemini Robotics ER 1.6 do të mbyllet në fund të gushtit .
Provoni Gemini Robotics ER 2 në Google AI Studio
Aftësitë e robotikës
Gemini Robotics ER mbështet një gamë të gjerë aftësish arsyetimi të mishëruara. Zgjidhni një aftësi për të mësuar më shumë:
| Aftësia | Përshkrimi | Udhëzues |
|---|---|---|
| Arsyetimi hapësinor | Trego objekte, gjurmoji ato në video, zbuloji me anë të kutive kufizuese, planifiko trajektore. | Arsyetimi hapësinor |
| Vizioni agjentik | Përdorni ekzekutimin e kodit për të përmirësuar aftësi të tjera duke shfrytëzuar mjetet e manipulimit të imazheve. | Vizioni agjentik |
| Orkestrimi i detyrave | Kombinoni arsyetimin hapësinor me API-të e robotëve të personalizuar për të përfunduar detyra me horizont të gjatë. | Orkestrimi i detyrave |
| Transmetim (vetëm pika fundore e transmetimit Gemini Robotics ER 2) | Transmetim bidirektiv për agjentë robotë në kohë reale me thirrje të funksioneve me latencë të ulët. | Transmetim për robotikë |
| Progresi i videos (vetëm Gemini Robotics ER 2) | Gjetja e momenteve dhe klasifikimi i progresit nga transmetimet e vazhdueshme të videos. | Kuptimi i videos |
Fillimi
Shembulli i mëposhtëm gjen objektet në një imazh dhe kthen koordinatat dhe etiketat e tyre të normalizuara 2D. Mund ta kaloni këtë rezultat direkt në një API robotike ose një model VLA për të gjeneruar veprime të robotit.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
PUSHTIM
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
Rezultati do të jetë një varg JSON që përmban objekte, secila me një point (koordinatat e normalizuara [y, x] ) dhe një label që identifikon objektin.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Imazhi i mëposhtëm është një shembull se si mund të shfaqen këto pika:
Si funksionon
Gemini Robotics ER merr të dhëna hyrëse imazhi, videoje ose audioje me udhëzime në gjuhën natyrore. Ai identifikon objektet, arsyet rreth kontekstit të skenës dhe marrëdhëniet hapësinore, dhe kthen të dhëna të strukturuara si koordinata ose kuti kufizuese.
Gemini Robotics ER është gjithashtu agjentik: ai i ndan detyrat komplekse në nën-detyra dhe i ekzekuton ato duke thirrur funksionet e robotit tuaj ose duke ekzekutuar kodin e gjeneruar. Për shembull, "vendos mollën në tas" bëhet një sekuencë hapash për të gjetur, kapur dhe vendosur.
Shihni Thirrja e Funksionit për detaje se si Gemini ekzekuton thirrjet e mjeteve.
Siguria
Ndërsa Gemini Robotics ER u ndërtua duke pasur parasysh sigurinë, është përgjegjësia juaj të ruani një mjedis të sigurt rreth robotit. Modelet gjeneruese të IA-së mund të bëjnë gabime dhe robotët fizikë mund të shkaktojnë dëme. Për të mësuar më shumë, vizitoni faqen e sigurisë së robotikës në Google DeepMind .
Praktikat më të mira
Përdorni gjuhë të thjeshtë dhe natyrale. Përshkruani se çfarë doni që roboti të bëjë ashtu siç do të bënit me një person. Nëse një term nuk funksionon, provoni një sinonim të zakonshëm.
Optimizoni të dhënat vizuale. Pritini ose zmadhoni objektet e vogla ose të paqarta përpara se të dërgoni imazhin. Ndriçimi dhe kontrasti i ulët i ngjyrave mund të ndikojnë në zbulimin.
Ndani detyrat komplekse në hapa. Dërgoni çdo hap si një kërkesë të veçantë për ta mbajtur modelin të fokusuar dhe për të përmirësuar saktësinë.
Kryeni pyetje të shumëfishta dhe nxirrni rezultate mesatare për detyra me precizion të lartë. Kjo qasje konsensusi zvogëlon variancën në rezultatet hapësinore.
Kufizime
Merrni parasysh kufizimet e mëposhtme kur zhvilloni me Gemini Robotics ER:
- Kufizimet e çelësit API: API Gemini nuk pranon kërkesa nga çelësat API të pakufizuar dhe kthen një gabim
403 Forbidden. Siguroni çelësin tuaj API duke shtuar kufizime në AI Studio . Shihni Siguroni çelësat API të pakufizuar për detaje. - Vonesa kundrejt performancës: Pyetjet komplekse, të dhënat hyrëse me rezolucion të lartë ose nivelet e larta të të menduarit mund të çojnë në kohë më të gjata përpunimi. Për nivelin e të menduarit, përdorni nivelin mesatar për një ekuilibër të mirë midis latencës dhe performancës.
- Halucinacione: Ashtu si të gjitha modelet e mëdha gjuhësore, modelet Gemini Robotics ER mund të "halucinojnë" herë pas here ose të japin informacion të pasaktë, veçanërisht për kërkesa të paqarta ose të dhëna jashtë shpërndarjes.
- Varësia nga cilësia e mesazhit të dhënë: Cilësia e rezultatit varet nga qartësia e mesazhit të dhënë në hyrje. Përdorni mesazhe specifike dhe të strukturuara mirë.
- Kostoja llogaritëse: Ekzekutimi i modelit, veçanërisht me hyrje video ose
thinking_budgettë lartë, konsumon burime llogaritëse dhe shkakton kosto. Shihni faqen e të menduarit për më shumë detaje. - Llojet e të dhënave hyrëse: Shihni temat e mëposhtme për detaje mbi kufizimet për secilin modalitet.
Njoftim për Privatësinë
Ju pranoni që modelet e referuara në këtë dokument ("Modelet e Robotikës") shfrytëzojnë të dhënat video dhe audio për të operuar dhe lëvizur harduerin tuaj në përputhje me udhëzimet tuaja. Prandaj, ju mund të operoni Modelet e Robotikës në mënyrë që të dhënat nga persona të identifikueshëm, siç janë zëri, imazhet dhe të dhënat e ngjashmërisë ("Të Dhënat Personale"), të mblidhen nga Modelet e Robotikës. Nëse zgjidhni të operoni Modelet e Robotikës në një mënyrë që mbledh të Dhëna Personale, ju pranoni se nuk do të lejoni asnjë person të identifikueshëm të bashkëveprojë me, ose të jetë i pranishëm në zonën përreth, Modeleve të Robotikës, përveç nëse dhe derisa personat e tillë të identifikueshëm të jenë njoftuar mjaftueshëm dhe të kenë dhënë pëlqimin për faktin se të Dhënat e tyre Personale mund t'i ofrohen dhe të përdoren nga Google, siç përshkruhet në Kushtet Shtesë të Shërbimit të Gemini API që gjenden në https://ai.google.dev/gemini-api/terms ("Kushtet"), duke përfshirë edhe në përputhje me seksionin e titulluar "Si i Përdor Google të Dhënat Tuaja". Ju do të siguroheni që një njoftim i tillë lejon mbledhjen dhe përdorimin e të Dhënave Personale siç përcaktohet në Kushte, dhe do të bëni përpjekje të arsyeshme komerciale për të minimizuar mbledhjen dhe shpërndarjen e të Dhënave Personale duke përdorur teknika të tilla si mjegullimi i fytyrës dhe operimi i Modeleve Robotike në zona që nuk përmbajnë persona të identifikueshëm në masën e praktikueshme.
Çmimet
Për informacion të detajuar mbi çmimet dhe rajonet e disponueshme, referojuni faqes së çmimeve .
Pikat fundore të modelit
Pamje paraprake e Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e transmetimit të Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-streaming-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Nuk mbështetet Mbështetur Nuk mbështetet |
| Opsionet e konsumit të | Nuk mbështetet Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e Gemini Robotics ER 1.6
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-1.6-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Dhjetor 2025 |
| i njohurive | Janar 2025 |
Çfarë vjen më pas
- Arsyetimi hapësinor — drejtimi, ndjekja, kutitë kufizuese, trajektore.
- Aftësitë agjentike — ekzekutimi i kodit, leximi i instrumenteve, shënimi i imazheve.
- Orkestrimi i detyrave — detyra me horizont të gjatë me API-të e robotëve të personalizuar.
- Robotikë me transmetim — transmetim dypalësh në kohë reale (vetëm Gemini Robotics ER 2).
- Kuptimi i videos — gjetja e momenteve dhe klasifikimi i progresit (vetëm Gemini Robotics ER 2).
- Siguria në robotikën e Google DeepMind — hulumtimi i sigurisë që qëndron pas familjes së modeleve.
Modelet ER (arsyetimi i mishëruar) të Gemini Robotics janë modele të gjuhës së vizionit (VLM) që i lejojnë robotët të perceptojnë dhe të bashkëveprojnë me botën fizike. Ata interpretojnë të dhënat vizuale, kryejnë arsyetim hapësinor dhe kohor, planifikojnë detyra me shumë hapa dhe orkestrojnë robotë dhe mjete.
Modele
Modeli Gemini Robotics ER 2 është modeli më i fundit në Gemini Robotics. Është modeli ynë i përditësuar i arsyetimit që u mundëson robotëve të kuptojnë me saktësi mjedisin e tyre. Ai specializohet në aftësitë e arsyetimit të mishëruar, siç është orkestrimi agjentik i robotëve (p.sh. duke përdorur VLA), kuptimi i videos së robotit duke përfshirë kuptimin e progresit dhe zbulimin e suksesit, leximin e instrumenteve, drejtimin dhe arsyetimin hapësinor.
Modeli Gemini Robotics ER 2 prezanton dy pika fundore të modelit:
-
gemini-robotics-er-2-preview: Modeli standard ER 2. Ndërtohet mbi Gemini 3.5 Flash me arsyetim hapësinor të përmirësuar, gjetje të momenteve video, klasifikim të progresit të videos, orkestrim me shumë robotë dhe përdorim mjetesh me shumë hapa. -
gemini-robotics-er-2-streaming-preview: Optimizuar për transmetim në kohë reale nëpërmjet Live API . Përdorni këtë model për agjentë robotikë me vonesë të ulët që përpunojnë të dhëna të vazhdueshme audio dhe video.
Nëse po përdorni Gemini Robotics ER 1.6, përditësojeni në Gemini Robotics ER 2 duke zëvendësuar model="gemini-robotics-er-1.6-preview" me model="gemini-robotics-er-2-preview" ose model="gemini-robotics-er-2-streaming-preview" në thirrjet tuaja API. Vini re se modeli Gemini Robotics ER 1.6 do të mbyllet në fund të gushtit .
Provoni Gemini Robotics ER 2 në Google AI Studio
Aftësitë e robotikës
Gemini Robotics ER mbështet një gamë të gjerë aftësish arsyetimi të mishëruara. Zgjidhni një aftësi për të mësuar më shumë:
| Aftësia | Përshkrimi | Udhëzues |
|---|---|---|
| Arsyetimi hapësinor | Trego objekte, gjurmoji ato në video, zbuloji me anë të kutive kufizuese, planifiko trajektore. | Arsyetimi hapësinor |
| Vizioni agjentik | Përdorni ekzekutimin e kodit për të përmirësuar aftësi të tjera duke shfrytëzuar mjetet e manipulimit të imazheve. | Vizioni agjentik |
| Orkestrimi i detyrave | Kombinoni arsyetimin hapësinor me API-të e robotëve të personalizuar për të përfunduar detyra me horizont të gjatë. | Orkestrimi i detyrave |
| Transmetim (vetëm pika fundore e transmetimit Gemini Robotics ER 2) | Transmetim bidirektiv për agjentë robotë në kohë reale me thirrje të funksioneve me latencë të ulët. | Transmetim për robotikë |
| Progresi i videos (vetëm Gemini Robotics ER 2) | Gjetja e momenteve dhe klasifikimi i progresit nga transmetimet e vazhdueshme të videos. | Kuptimi i videos |
Fillimi
Shembulli i mëposhtëm gjen objektet në një imazh dhe kthen koordinatat dhe etiketat e tyre të normalizuara 2D. Mund ta kaloni këtë rezultat direkt në një API robotike ose një model VLA për të gjeneruar veprime të robotit.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
PUSHTIM
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
Rezultati do të jetë një varg JSON që përmban objekte, secila me një point (koordinatat e normalizuara [y, x] ) dhe një label që identifikon objektin.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Imazhi i mëposhtëm është një shembull se si mund të shfaqen këto pika:
Si funksionon
Gemini Robotics ER merr të dhëna hyrëse imazhi, videoje ose audioje me udhëzime në gjuhën natyrore. Ai identifikon objektet, arsyet rreth kontekstit të skenës dhe marrëdhëniet hapësinore, dhe kthen të dhëna të strukturuara si koordinata ose kuti kufizuese.
Gemini Robotics ER është gjithashtu agjentik: ai i ndan detyrat komplekse në nën-detyra dhe i ekzekuton ato duke thirrur funksionet e robotit tuaj ose duke ekzekutuar kodin e gjeneruar. Për shembull, "vendos mollën në tas" bëhet një sekuencë hapash për të gjetur, kapur dhe vendosur.
Shihni Thirrja e Funksionit për detaje se si Gemini ekzekuton thirrjet e mjeteve.
Siguria
Ndërsa Gemini Robotics ER u ndërtua duke pasur parasysh sigurinë, është përgjegjësia juaj të ruani një mjedis të sigurt rreth robotit. Modelet gjeneruese të IA-së mund të bëjnë gabime dhe robotët fizikë mund të shkaktojnë dëme. Për të mësuar më shumë, vizitoni faqen e sigurisë së robotikës në Google DeepMind .
Praktikat më të mira
Përdorni gjuhë të thjeshtë dhe natyrale. Përshkruani se çfarë doni që roboti të bëjë ashtu siç do të bënit me një person. Nëse një term nuk funksionon, provoni një sinonim të zakonshëm.
Optimizoni të dhënat vizuale. Pritini ose zmadhoni objektet e vogla ose të paqarta përpara se të dërgoni imazhin. Ndriçimi dhe kontrasti i ulët i ngjyrave mund të ndikojnë në zbulimin.
Ndani detyrat komplekse në hapa. Dërgoni çdo hap si një kërkesë të veçantë për ta mbajtur modelin të fokusuar dhe për të përmirësuar saktësinë.
Kryeni pyetje të shumëfishta dhe nxirrni rezultate mesatare për detyra me precizion të lartë. Kjo qasje konsensusi zvogëlon variancën në rezultatet hapësinore.
Kufizime
Merrni parasysh kufizimet e mëposhtme kur zhvilloni me Gemini Robotics ER:
- Kufizimet e çelësit API: API Gemini nuk pranon kërkesa nga çelësat API të pakufizuar dhe kthen një gabim
403 Forbidden. Siguroni çelësin tuaj API duke shtuar kufizime në AI Studio . Shihni Siguroni çelësat API të pakufizuar për detaje. - Vonesa kundrejt performancës: Pyetjet komplekse, të dhënat hyrëse me rezolucion të lartë ose nivelet e larta të të menduarit mund të çojnë në kohë më të gjata përpunimi. Për nivelin e të menduarit, përdorni nivelin mesatar për një ekuilibër të mirë midis latencës dhe performancës.
- Halucinacione: Ashtu si të gjitha modelet e mëdha gjuhësore, modelet Gemini Robotics ER mund të "halucinojnë" herë pas here ose të japin informacion të pasaktë, veçanërisht për kërkesa të paqarta ose të dhëna jashtë shpërndarjes.
- Varësia nga cilësia e mesazhit të dhënë: Cilësia e rezultatit varet nga qartësia e mesazhit të dhënë në hyrje. Përdorni mesazhe specifike dhe të strukturuara mirë.
- Kostoja llogaritëse: Ekzekutimi i modelit, veçanërisht me hyrje video ose
thinking_budgettë lartë, konsumon burime llogaritëse dhe shkakton kosto. Shihni faqen e të menduarit për më shumë detaje. - Llojet e të dhënave hyrëse: Shihni temat e mëposhtme për detaje mbi kufizimet për secilin modalitet.
Njoftim për Privatësinë
Ju pranoni që modelet e referuara në këtë dokument ("Modelet e Robotikës") shfrytëzojnë të dhënat video dhe audio për të operuar dhe lëvizur harduerin tuaj në përputhje me udhëzimet tuaja. Prandaj, ju mund të operoni Modelet e Robotikës në mënyrë që të dhënat nga persona të identifikueshëm, siç janë zëri, imazhet dhe të dhënat e ngjashmërisë ("Të Dhënat Personale"), të mblidhen nga Modelet e Robotikës. Nëse zgjidhni të operoni Modelet e Robotikës në një mënyrë që mbledh të Dhëna Personale, ju pranoni se nuk do të lejoni asnjë person të identifikueshëm të bashkëveprojë me, ose të jetë i pranishëm në zonën përreth, Modeleve të Robotikës, përveç nëse dhe derisa personat e tillë të identifikueshëm të jenë njoftuar mjaftueshëm dhe të kenë dhënë pëlqimin për faktin se të Dhënat e tyre Personale mund t'i ofrohen dhe të përdoren nga Google, siç përshkruhet në Kushtet Shtesë të Shërbimit të Gemini API që gjenden në https://ai.google.dev/gemini-api/terms ("Kushtet"), duke përfshirë edhe në përputhje me seksionin e titulluar "Si i Përdor Google të Dhënat Tuaja". Ju do të siguroheni që një njoftim i tillë lejon mbledhjen dhe përdorimin e të Dhënave Personale siç përcaktohet në Kushte, dhe do të bëni përpjekje të arsyeshme komerciale për të minimizuar mbledhjen dhe shpërndarjen e të Dhënave Personale duke përdorur teknika të tilla si mjegullimi i fytyrës dhe operimi i Modeleve Robotike në zona që nuk përmbajnë persona të identifikueshëm në masën e praktikueshme.
Çmimet
Për informacion të detajuar mbi çmimet dhe rajonet e disponueshme, referojuni faqes së çmimeve .
Pikat fundore të modelit
Pamje paraprake e Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e transmetimit të Gemini Robotics ER 2
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-2-streaming-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Nuk mbështetet Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Nuk mbështetet Mbështetur Nuk mbështetet |
| Opsionet e konsumit të | Nuk mbështetet Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Korrik 2026 |
| Modeli i kartës | Kartë modeli |
Pamje paraprake e Gemini Robotics ER 1.6
| Pronë | Përshkrimi |
|---|---|
| Kodi i modelit të | gemini-robotics-er-1.6-preview |
| llojet e të dhënave të mbështetura | Të dhënat hyrëse Tekst, imazhe, video, audio Prodhimi Tekst |
| Limitet token-it [*] | Limiti i tokenit të hyrjes 131,072 Limiti i tokenit të daljes 65,536 |
| Aftësitë e | Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Mbështetur Nuk mbështetet Nuk mbështetet Mbështetur Mbështetur Mbështetur Mbështetur |
| Opsionet e konsumit të | Mbështetur Nuk mbështetet Nuk mbështetet |
| Versione |
|
| Përditësimi më i fundit | Dhjetor 2025 |
| i njohurive | Janar 2025 |
Çfarë vjen më pas
- Arsyetimi hapësinor — drejtimi, ndjekja, kutitë kufizuese, trajektore.
- Aftësitë agjentike — ekzekutimi i kodit, leximi i instrumenteve, shënimi i imazheve.
- Orkestrimi i detyrave — detyra me horizont të gjatë me API-të e robotëve të personalizuar.
- Robotikë me transmetim — transmetim dypalësh në kohë reale (vetëm Gemini Robotics ER 2).
- Kuptimi i videos — gjetja e momenteve dhe klasifikimi i progresit (vetëm Gemini Robotics ER 2).
- Siguria në robotikën e Google DeepMind — hulumtimi i sigurisë që qëndron pas familjes së modeleve.
Modelet ER (arsyetimi i mishëruar) të Gemini Robotics janë modele të gjuhës së vizionit (VLM) që i lejojnë robotët të perceptojnë dhe të bashkëveprojnë me botën fizike. Ata interpretojnë të dhënat vizuale, kryejnë arsyetim hapësinor dhe kohor, planifikojnë detyra me shumë hapa dhe orkestrojnë robotë dhe mjete.
Modele
Modeli Gemini Robotics ER 2 është modeli më i fundit në Gemini Robotics. Është modeli ynë i përditësuar i arsyetimit që u mundëson robotëve të kuptojnë me saktësi mjedisin e tyre. Ai specializohet në aftësitë e arsyetimit të mishëruar, siç është orkestrimi agjentik i robotëve (p.sh. duke përdorur VLA), kuptimi i videos së robotit duke përfshirë kuptimin e progresit dhe zbulimin e suksesit, leximin e instrumenteve, drejtimin dhe arsyetimin hapësinor.
Modeli Gemini Robotics ER 2 prezanton dy pika fundore të modelit:
-
gemini-robotics-er-2-preview: Modeli standard ER 2. Ndërtohet mbi Gemini 3.5 Flash me arsyetim hapësinor të përmirësuar, gjetje të momenteve video, klasifikim të progresit të videos, orkestrim me shumë robotë dhe përdorim mjetesh me shumë hapa. -
gemini-robotics-er-2-streaming-preview: Optimizuar për transmetim në kohë reale nëpërmjet Live API . Përdorni këtë model për agjentë robotikë me vonesë të ulët që përpunojnë të dhëna të vazhdueshme audio dhe video.
Nëse po përdorni Gemini Robotics ER 1.6, përditësojeni në Gemini Robotics ER 2 duke zëvendësuar model="gemini-robotics-er-1.6-preview" me model="gemini-robotics-er-2-preview" ose model="gemini-robotics-er-2-streaming-preview" në thirrjet tuaja API. Vini re se modeli Gemini Robotics ER 1.6 do të mbyllet në fund të gushtit .
Provoni Gemini Robotics ER 2 në Google AI Studio
Aftësitë e robotikës
Gemini Robotics ER mbështet një gamë të gjerë aftësish arsyetimi të mishëruara. Zgjidhni një aftësi për të mësuar më shumë:
| Aftësia | Përshkrimi | Udhëzues |
|---|---|---|
| Arsyetimi hapësinor | Trego objekte, gjurmoji ato në video, zbuloji me anë të kutive kufizuese, planifiko trajektore. | Arsyetimi hapësinor |
| Vizioni agjentik | Përdorni ekzekutimin e kodit për të përmirësuar aftësi të tjera duke shfrytëzuar mjetet e manipulimit të imazheve. | Vizioni agjentik |
| Orkestrimi i detyrave | Kombinoni arsyetimin hapësinor me API-të e robotëve të personalizuar për të përfunduar detyra me horizont të gjatë. | Orkestrimi i detyrave |
| Transmetim (vetëm pika fundore e transmetimit Gemini Robotics ER 2) | Transmetim bidirektiv për agjentë robotë në kohë reale me thirrje të funksioneve me latencë të ulët. | Transmetim për robotikë |
| Progresi i videos (vetëm Gemini Robotics ER 2) | Gjetja e momenteve dhe klasifikimi i progresit nga transmetimet e vazhdueshme të videos. | Kuptimi i videos |
Fillimi
The following example finds objects in an image and returns their normalized 2D coordinates and labels. You can pass this output directly to a robotics API or a VLA model to generate robot actions.
Python
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
PUSHTIM
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
The output will be a JSON array containing objects, each with a point (normalized [y, x] coordinates) and a label identifying the object.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
The following image is an example of how these points can be displayed:
Si funksionon
Gemini Robotics ER takes image, video, or audio input with natural language prompts. It identifies objects, reasons about scene context and spatial relationships, and returns structured output like coordinates or bounding boxes.
Gemini Robotics ER is also agentic: it breaks complex tasks into sub-tasks and executes them by calling your robot functions or running generated code. For example, "put the apple in the bowl" becomes a sequence of locate, grasp, and place steps.
See Function calling for details on how Gemini executes tool calls.
Siguria
While Gemini Robotics ER was built with safety in mind, it is your responsibility to maintain a safe environment around the robot. Generative AI models can make mistakes, and physical robots can cause damage. To learn more, visit the Google DeepMind robotics safety page .
Praktikat më të mira
Use plain, natural language. Describe what you want the robot to do as you would to a person. If a term isn't working, try a common synonym.
Optimize visual input. Crop or zoom into small or unclear objects before sending the image. Lighting and low color contrast can affect detection.
Break complex tasks into steps. Send each step as a separate prompt to keep the model focused and improve accuracy.
Query multiple times and average results for high-precision tasks. This consensus approach reduces variance on spatial outputs.
Limitations
Consider the following limitations when developing with Gemini Robotics ER:
- API key restrictions: The Gemini API does not accept requests from unrestricted API keys and returns a
403 Forbiddenerror. Secure your API key by adding restrictions in AI Studio . See Secure unrestricted API keys for details. - Latency vs performance: Complex queries, high-resolution inputs or high thinking levels can lead to increased processing times. For thinking level use medium for a good balance between latency and performance.
- Hallucinations: Like all large language models, Gemini Robotics ER models can occasionally "hallucinate" or provide incorrect information, especially for ambiguous prompts or out-of-distribution inputs.
- Dependence on prompt quality: Output quality depends on the clarity of the input prompt. Use specific, well-structured prompts.
- Computational cost: Running the model, especially with video inputs or high
thinking_budget, consumes computational resources and incurs costs. See the Thinking page for more details. - Input types: See the following topics for details on limitations for each mode.
Njoftim për Privatësinë
You acknowledge that the models referenced in this document (the "Robotics Models") leverage video and audio data in order to operate and move your hardware in accordance with your instructions. You therefore may operate the Robotics Models such that data from identifiable persons, such as voice, imagery, and likeness data ("Personal Data"), will be collected by the Robotics Models. If you elect to operate the Robotics Models in a manner that collects Personal Data, you agree that you will not permit any identifiable persons to interact with, or be present in the area surrounding, the Robotics Models, unless and until such identifiable persons have been sufficiently notified of and consented to the fact that their Personal Data may be provided to and used by Google as outlined in the Gemini API Additional Terms of Service found at https://ai.google.dev/gemini-api/terms (the "Terms"), including in accordance with the section entitled "How Google Uses Your Data". You will ensure that such notice permits the collection and use of Personal Data as outlined in the Terms, and you will use commercially reasonable efforts to minimize the collection and distribution of Personal Data by using techniques such as face blurring and operating the Robotics Models in areas not containing identifiable persons to the extent practicable.
Çmimet
For detailed information on pricing and available regions, refer to the pricing page.
Model endpoints
Gemini Robotics ER 2 Preview
| Pronë | Përshkrimi |
|---|---|
| Model code | gemini-robotics-er-2-preview |
| Supported data types | Inputs Text, images, video, audio Prodhimi Tekst |
| Token limits [*] | Input token limit 131,072 Output token limit 65,536 |
| Capabilities | Not supported Supported Supported Supported Supported Supported Supported Not supported Not supported Supported Supported Supported Supported |
| Consumption options | Supported Not supported Not supported |
| Versions |
|
| Latest update | Korrik 2026 |
| Model card | Model card |
Gemini Robotics ER 2 Streaming Preview
| Pronë | Përshkrimi |
|---|---|
| Model code | gemini-robotics-er-2-streaming-preview |
| Supported data types | Inputs Text, images, video, audio Prodhimi Tekst |
| Token limits [*] | Input token limit 131,072 Output token limit 65,536 |
| Capabilities | Not supported Not supported Not supported Not supported Not supported Supported Not supported Not supported Supported Supported Not supported Supported Not supported |
| Consumption options | Not supported Not supported Not supported |
| Versions |
|
| Latest update | Korrik 2026 |
| Model card | Model card |
Gemini Robotics ER 1.6 Preview
| Pronë | Përshkrimi |
|---|---|
| Model code | gemini-robotics-er-1.6-preview |
| Supported data types | Inputs Text, images, video, audio Prodhimi Tekst |
| Token limits [*] | Input token limit 131,072 Output token limit 65,536 |
| Capabilities | Not supported Supported Supported Supported Supported Supported Supported Not supported Not supported Supported Supported Supported Supported |
| Consumption options | Supported Not supported Not supported |
| Versions |
|
| Latest update | Dhjetor 2025 |
| Knowledge cutoff | January 2025 |
What's next
- Spatial reasoning — pointing, tracking, bounding boxes, trajectories.
- Agentic capabilities — code execution, instrument reading, image annotation.
- Task orchestration — long-horizon tasks with custom robot APIs.
- Robotics with streaming — real-time bidirectional streaming (Gemini Robotics ER 2 only).
- Video understanding — moment finding and progress classification (Gemini Robotics ER 2 only).
- Google DeepMind robotics safety — safety research behind the model family.