

ממשק Gemini API מספק הגדרות בטיחות שאפשר לשנות בשלב יצירת אב טיפוס כדי לקבוע אם האפליקציה שלכם דורשת הגדרת בטיחות מגבילה יותר או פחות. אתם יכולים לשנות את ההגדרות האלה ב-4 קטגוריות של מסננים כדי להגביל סוגים מסוימים של תוכן או לאפשר אותם.
במדריך הזה מוסבר איך Gemini API מטפל בהגדרות הבטיחות ובסינון, ואיך אתם יכולים לשנות את הגדרות הבטיחות באפליקציה שלכם.
מסנני בטיחות
מסנני הבטיחות המתכווננים של Gemini API מכסים את הקטגוריות הבאות:
| קטגוריה | תיאור |
|---|---|
| הטרדה | תגובות שליליות או פוגעניות שמתמקדות בזהות או במאפיינים מוגנים. |
| דברי שטנה | תוכן גס, לא מכבד או חילול קודש. |
| תוכן מיני בוטה | מכיל אזכורים של מעשים מיניים או תוכן גס אחר. |
| תוכן מסוכן | מקדם גרימת נזק, מעודד גרימת נזק או עוזר לבצע פעולות מזיקות. |
הקטגוריות האלה מוגדרות ב-HarmCategory. אתם יכולים להשתמש במסננים האלה כדי לשנות את מה שמתאים לתרחיש לדוגמה שלכם. לדוגמה, אם אתם יוצרים דיאלוג למשחק וידאו, יכול להיות שתחליטו שזה בסדר לאפשר יותר תוכן שמסווג כמסוכן בגלל אופי המשחק.
בנוסף למסנני הבטיחות שניתנים להתאמה, ל-Gemini API יש אמצעי הגנה מובנים מפני פגיעות חמורות, כמו תוכן שמסכן את בטיחות הילדים. סוגי הפגיעה האלה תמיד חסומים ואי אפשר לשנות את ההגדרות שלהם.
רמת הסינון של בטיחות התוכן
Gemini API מסווג את רמת הסבירות שהתוכן לא בטוח בתור HIGH, MEDIUM, LOW או NEGLIGIBLE.
ממשק Gemini API חוסם תוכן על סמך הסבירות שהתוכן לא בטוח, ולא על סמך חומרת הבעיה. חשוב להביא את זה בחשבון כי יש תכנים שהסבירות שהם לא בטוחים נמוכה, אבל חומרת הפגיעה עדיין יכולה להיות גבוהה. לדוגמה, בהשוואה בין המשפטים:
- הרובוט נתן לי אגרוף.
- הרובוט חתך אותי.
המשפט הראשון עלול להוביל לסבירות גבוהה יותר של תוצאה לא בטוחה, אבל יכול להיות שהמשפט השני יחשב לחמור יותר מבחינת אלימות. לכן חשוב לבדוק בקפידה ולשקול מה רמת החסימה המתאימה שנדרשת כדי לתמוך בתרחישי השימוש העיקריים שלכם, תוך מזעור הפגיעה במשתמשי הקצה.
סינון בטיחות לכל בקשה
אתם יכולים לשנות את הגדרות הבטיחות לכל בקשה שאתם שולחים ל-API. כששולחים בקשה, התוכן מנותח ומקבל דירוג בטיחות. דירוג הבטיחות כולל את הקטגוריה ואת הסבירות לסיווג הפגיעה. לדוגמה, אם התוכן נחסם כי בקטגוריה "הטרדה" הייתה סבירות גבוהה, דירוג הבטיחות שיוחזר יכלול את הקטגוריה HARASSMENT וסבירות הפגיעה תוגדר כ-HIGH.
בגלל הבטיחות המובנית של המודל, מסננים נוספים מושבתים כברירת מחדל. אם תבחרו להפעיל אותם, תוכלו להגדיר את המערכת כך שתחסום תוכן על סמך הסבירות שהוא לא בטוח. ההתנהגות של המודל כברירת מחדל מתאימה לרוב התרחישים לדוגמה, לכן כדאי לשנות את ההגדרות האלה רק אם נדרשת עקביות באפליקציה.
בטבלה הבאה מתוארות הגדרות החסימה שאפשר לשנות בכל קטגוריה. לדוגמה, אם מגדירים את הגדרת החסימה לחסימה של חלק מהתוכן בקטגוריה דברי שטנה, כל מה שיש לו סיכוי גבוה להיות תוכן של דברי שטנה ייחסם. אבל מותר להשתמש בכל דבר שההסתברות שלו נמוכה יותר.
| סף (Google AI Studio) | סף (API) | תיאור |
|---|---|---|
| מושבת | OFF |
השבתת מסנן הבטיחות |
| ללא חסימה | BLOCK_NONE |
הצגה תמיד, ללא קשר להסתברות של תוכן לא בטוח |
| חסימה של כמה | BLOCK_ONLY_HIGH |
חסימה כשיש הסתברות גבוהה לתוכן לא בטוח |
| חסימת חלק מהמשתמשים | BLOCK_MEDIUM_AND_ABOVE |
חסימה כשיש סבירות בינונית או גבוהה לתוכן לא בטוח |
| חסימה של רוב האנשים | BLOCK_LOW_AND_ABOVE |
חסימה כשיש סבירות נמוכה, בינונית או גבוהה לתוכן לא בטוח |
| לא רלוונטי | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
הסף לא צוין, החסימה תתבצע באמצעות סף ברירת המחדל |
אם לא מגדירים את הסף, סף החסימה שמוגדר כברירת מחדל הוא מושבת עבור Gemini 2.5 ומודלים מתקדמים יותר.
אפשר להגדיר את ההגדרות האלה לכל בקשה ששולחים לשירות הגנרטיבי.
לפרטים נוספים, עיינו במאמרי העזרה של ה-API של HarmBlockThreshold.
משוב בנושא בטיחות
generateContent מחזיר GenerateContentResponse שכולל משוב בנושא בטיחות.
משוב על פרומפטים כלול בpromptFeedback. אם מוגדר הערך promptFeedback.blockReason, התוכן של ההנחיה נחסם.
המשוב על מועמדים לתשובה נכלל ב-Candidate.finishReason וב-Candidate.safetyRatings. אם תוכן התשובה נחסם והערך של finishReason היה SAFETY, אפשר לבדוק את safetyRatings כדי לקבל פרטים נוספים. התוכן שנחסם לא מוחזר.
שינוי הגדרות הבטיחות
בקטע הזה מוסבר איך לשנות את הגדרות הבטיחות ב-Google AI Studio ובקוד.
Google AI Studio
אתם יכולים לשנות את הגדרות הבטיחות ב-Google AI Studio.
לוחצים על הגדרות בטיחות בקטע הגדרות מתקדמות בחלונית הגדרות ההרצה כדי לפתוח את תיבת הדו-שיח הגדרות הבטיחות של ההרצה. במודל, אתם יכולים להשתמש בפסי ההזזה כדי לשנות את רמת סינון התוכן לפי קטגוריית בטיחות:
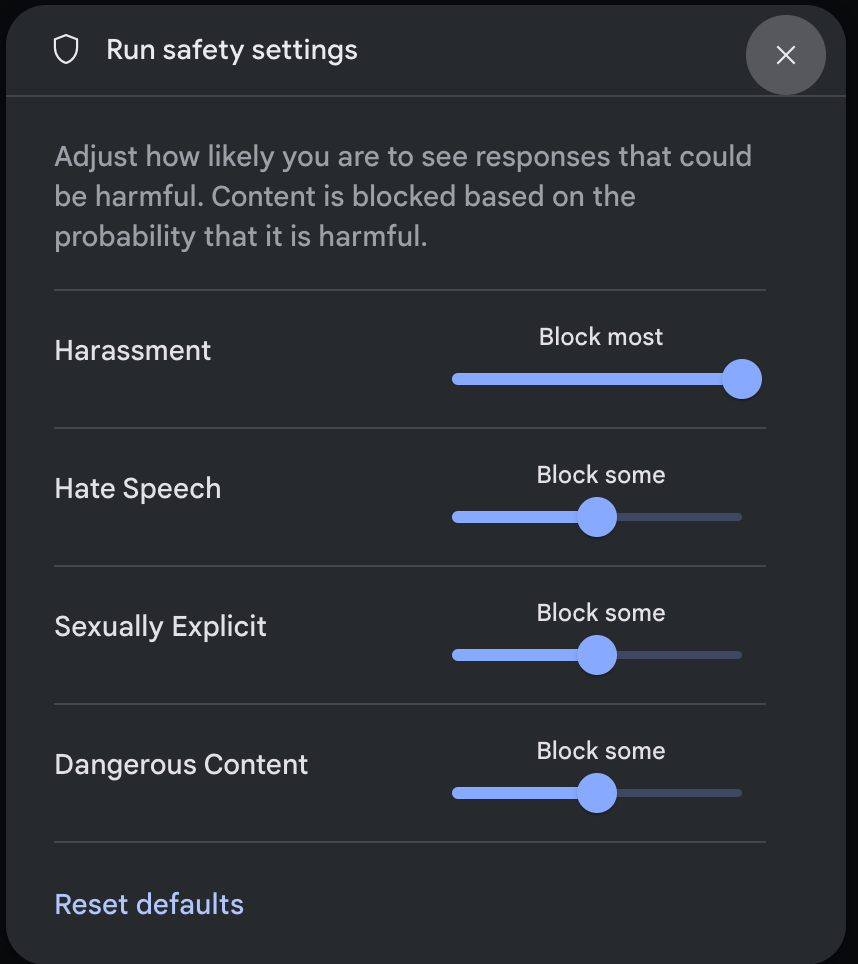
כששולחים בקשה (למשל, שואלים את המודל שאלה), אם התוכן של הבקשה חסום, מופיעה ההודעה התוכן חסום. כדי לראות פרטים נוספים, מעבירים את הסמן מעל הטקסט Content blocked כדי לראות את הקטגוריה ואת הסבירות לסיווג הנזק.
דוגמאות לקוד
בקטע הקוד הבא מוצג איך מגדירים הגדרות בטיחות בקריאה ל-GenerateContent. ההגדרה הזו קובעת את הסף של קטגוריית דברי השטנה (HARM_CATEGORY_HATE_SPEECH). הגדרה של הקטגוריה הזו לערך BLOCK_LOW_AND_ABOVE חוסמת כל תוכן שיש סבירות נמוכה או גבוהה יותר שהוא מכיל דברי שטנה. כדי להבין את הגדרות הסף, אפשר לעיין במאמר סינון בטיחותי לכל בקשה.
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
השלבים הבאים
- כדי לקבל מידע נוסף על ה-API המלא, אפשר לעיין במאמרי העזרה של ה-API.
- כדאי לעיין בהנחיות הבטיחות כדי לקבל סקירה כללית של שיקולי בטיחות בפיתוח עם מודלים של שפה גדולה (LLM).
- הצוות של Jigsaw מסביר איך להעריך את הסבירות לעומת החומרה.
- מידע נוסף על המוצרים שמשמשים לפתרונות בטיחות כמו Perspective API. * אתם יכולים להשתמש בהגדרות הבטיחות האלה כדי ליצור מסווג תוכן פוגעני. כדי להתחיל, אפשר לעיין בדוגמה לסיווג.