

Gemini API 提供安全設定,您可以在原型設計階段調整,判斷應用程式是否需要更嚴格或寬鬆的安全設定。您可以調整四個篩選器類別的設定,限制或允許特定類型的內容。
本指南說明 Gemini API 如何處理安全設定和篩選,以及如何變更應用程式的安全設定。
安全篩選機制
Gemini API 的可調整安全篩選器涵蓋下列類別:
| 類別 | 說明 |
|---|---|
| 騷擾 | 針對特定身分和/或受保護特質發表負面或有害言論。 |
| 仇恨言論 | 粗俗、不尊重或不雅的內容。 |
| 煽情露骨內容 | 提及性行為或其他猥褻情事的內容。 |
| 危險內容 | 宣傳、鼓吹或助長有害舉動。 |
這些類別定義於 HarmCategory。您可以運用這些篩選機制,根據使用情境將模型調整為適當的狀態。舉例來說,如果您正在製作電玩遊戲對白,可能為配合遊戲風格,而允許較多遭評為「危險」的內容。
除了可調整的安全篩選器,Gemini API 也內建防護機制,可防範核心危害,例如危害兒童安全的內容。系統一律會封鎖這類有害內容,且無法調整。
內容安全篩選等級
Gemini API 會將內容不安全的機率分為 HIGH、MEDIUM、LOW 或 NEGLIGIBLE。
Gemini API 會根據內容不安全的機率 (而非嚴重程度) 封鎖內容。請務必考量這點,因為即使某些內容造成嚴重危害的機率不高,仍可能造成嚴重傷害。舉例來說,比較以下句子:
- 機器人揍了我一拳。
- 機器人砍傷了我。
第一句可能較容易被判定為不安全,但就暴力程度而言,您可能會認為第二句較為嚴重。因此,請務必仔細測試並考量適當的封鎖層級,確保支援重要用途,同時盡量減少對使用者的傷害。
每個要求的安全篩選
在向 API 發出的每項要求,都可以調整安全設定。提出要求後,系統會分析內容並給予安全評分。安全評分指的是 Gemini 判斷內容屬於特定危害類別的機率。舉例來說,如果系統判定內容屬於騷擾類別的機率很高,並加以封鎖,則傳回的安全評分會將類別設為 HARASSMENT,並將危害機率設為 HIGH。
由於模型本身具有安全性,因此額外篩選器預設為「關閉」。如果選擇啟用,可以設定系統根據不安全內容的可能性,封鎖相關內容。預設模型行為適用於大多數用途,因此除非應用程式有必要,否則請勿調整這些設定。
下表說明各類別可調整的封鎖設定。舉例來說,如果將「仇恨言論」類別的封鎖設定設為「封鎖極少數內容」,系統會封鎖所有極可能屬於仇恨言論的內容。但只要機率低於這個值,系統就會允許。
| 門檻 (Google AI Studio) | 門檻 (API) | 說明 |
|---|---|---|
| 關閉 | OFF |
關閉安全篩選器 |
| 不封鎖任何項目 | BLOCK_NONE |
無論不安全的機率為何,一律顯示內容 |
| 封鎖少數 | BLOCK_ONLY_HIGH |
封鎖不安全機率高的內容 |
| 封鎖一些 | BLOCK_MEDIUM_AND_ABOVE |
封鎖有害機率中等以上的內容 |
| 封鎖多數 | BLOCK_LOW_AND_ABOVE |
封鎖不安全機率低、中等、高的內容 |
| 不適用 | HARM_BLOCK_THRESHOLD_UNSPECIFIED |
未指定門檻,使用預設門檻封鎖 |
如未設定門檻,Gemini 2.5 和後續版本模型預設會關閉封鎖門檻。
您可以為向生成服務提出的每項要求,設定這些設定。詳情請參閱 HarmBlockThreshold API 參考資料。
安全性意見回饋
generateContent 會傳回包含安全意見回饋的 GenerateContentResponse。
提示意見回饋會納入 promptFeedback。如果設定 promptFeedback.blockReason,系統會封鎖提示內容。
候選回覆意見回饋包含在 Candidate.finishReason 和 Candidate.safetyRatings 中。如果回覆內容遭到封鎖,且 finishReason 為 SAFETY,您可以檢查 safetyRatings,瞭解更多詳細資料。系統不會傳回遭封鎖的內容。
調整安全設定
本節說明如何在 Google AI Studio 和程式碼中調整安全設定。
Google AI Studio
您可以在 Google AI Studio 中調整安全設定。
在「執行設定」面板中,按一下「進階設定」下方的「安全設定」,開啟「執行安全設定」模式。在互動視窗中,您可以使用滑桿調整各安全類別的內容篩選等級:
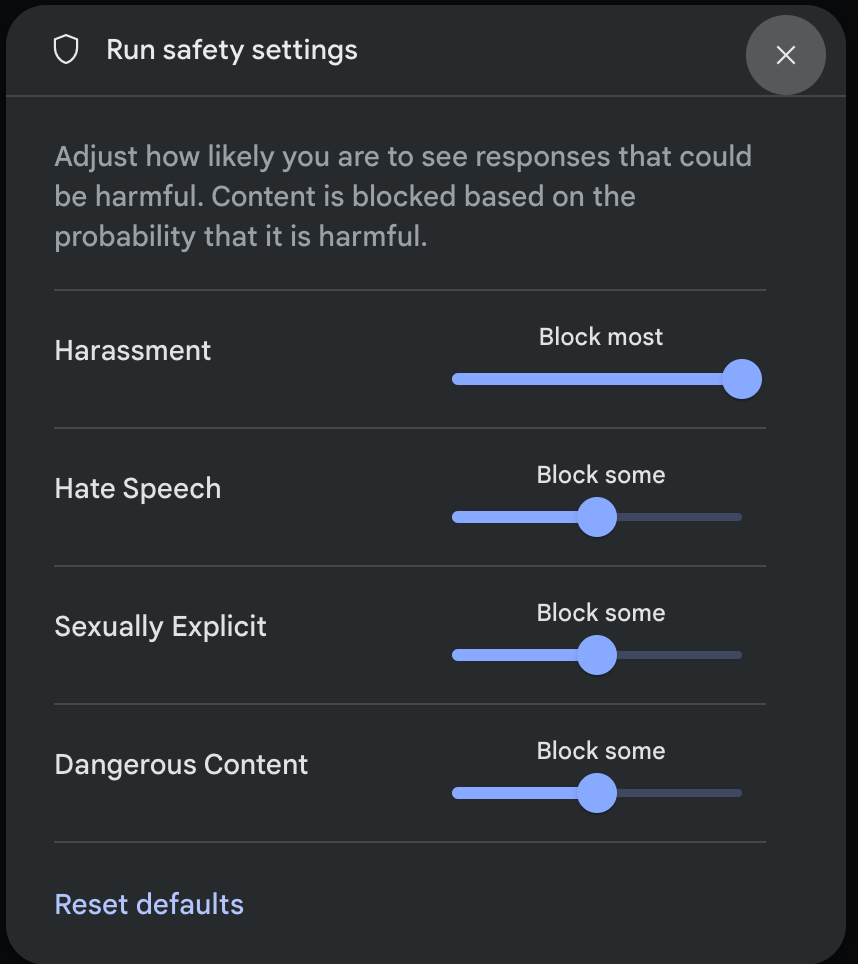
當您傳送要求 (例如向模型提問) 時,如果要求的內容遭到封鎖,系統會顯示 「Content blocked」(內容已封鎖) 訊息。如要查看更多詳細資料,請將指標懸停在「內容已封鎖」文字上,即可查看類別和危害分類的機率。
程式碼範例
下列程式碼片段說明如何在 GenerateContent 呼叫中設定安全設定。這會設定仇恨言論 (HARM_CATEGORY_HATE_SPEECH) 類別的門檻。如果將這個類別設為 BLOCK_LOW_AND_ABOVE,系統就會封鎖任何可能屬於仇恨言論的內容。如要瞭解門檻設定,請參閱「每個要求的安全篩選機制」。
Python
from google import genai
from google.genai import types

client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.8-flash",
    contents="Some potentially unsafe prompt",
    config=types.GenerateContentConfig(
      safety_settings=[
        types.SafetySetting(
            category=types.HarmCategory.HARM_CATEGORY_HATE_SPEECH,
            threshold=types.HarmBlockThreshold.BLOCK_LOW_AND_ABOVE,
        ),
      ]
    )
)

print(response.text)
Go
package main

import (
    "context"
    "fmt"
    "log"
    "google.golang.org/genai"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    config := &genai.GenerateContentConfig{
        SafetySettings: []*genai.SafetySetting{
            {
                Category:  "HARM_CATEGORY_HATE_SPEECH",
                Threshold: "BLOCK_LOW_AND_ABOVE",
            },
        },
    }

    response, err := client.Models.GenerateContent(
        ctx,
        "gemini-3.8-flash",
        genai.Text("Some potentially unsafe prompt."),
        config,
    )
    if err != nil {
        log.Fatal(err)
    }
    fmt.Println(response.Text())
}
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

const safetySettings = [
  {
    category: "HARM_CATEGORY_HATE_SPEECH",
    threshold: "BLOCK_LOW_AND_ABOVE",
  },
];

async function main() {
  const response = await ai.models.generateContent({
    model: "gemini-3.8-flash",
    contents: "Some potentially unsafe prompt.",
    config: {
      safetySettings: safetySettings,
    },
  });
  console.log(response.text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.types.GenerateContentConfig;
import com.google.genai.types.GenerateContentResponse;
import com.google.genai.types.HarmBlockThreshold;
import com.google.genai.types.HarmCategory;
import com.google.genai.types.SafetySetting;
import java.util.Arrays;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .category(HarmCategory.Known.HARM_CATEGORY_HATE_SPEECH)
        .threshold(HarmBlockThreshold.Known.BLOCK_LOW_AND_ABOVE)
        .build();

GenerateContentConfig config =
    GenerateContentConfig.builder()
        .safetySettings(Arrays.asList(hateSpeechSafety))
        .build();

GenerateContentResponse response =
    client.models.generateContent(
        "gemini-3.8-flash", "Some potentially unsafe prompt.", config);

System.out.println(response.text());
REST
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "safetySettings": [
        {"category": "HARM_CATEGORY_HATE_SPEECH", "threshold": "BLOCK_LOW_AND_ABOVE"}
    ],
    "contents": [{
        "parts":[{
            "text": "'\''Some potentially unsafe prompt.'\''"
        }]
    }]
}'
後續步驟
- 如要進一步瞭解完整的 API,請參閱 API 參考資料。
- 請參閱安全指南,概略瞭解使用 LLM 開發時的安全考量。
- 如要進一步瞭解如何評估機率與嚴重程度,請參閱 Jigsaw 團隊的文章
- 進一步瞭解有助於打造安全解決方案的產品,例如 Perspective API。* 您可以使用這些安全設定建立有害內容分類器。如要開始使用,請參閱分類範例。