

Les modèles Gemini Robotics ER (raisonnement incarné) sont des modèles de vision-langage (VLM) qui permettent aux robots de percevoir le monde physique et d'interagir avec lui. Ils interprètent les données visuelles, effectuent des raisonnements spatiaux et temporels, planifient des tâches en plusieurs étapes, et orchestrent les robots et les outils.
Modèles
Le modèle Gemini Robotics ER 2 est le dernier modèle de Gemini Robotics. Il s'agit de notre modèle de raisonnement mis à jour, qui permet aux robots de comprendre précisément leur environnement. Il est spécialisé dans les capacités de raisonnement incarné, telles que l'orchestration agentique de robots (par exemple, à l'aide de VLA), la compréhension vidéo des robots, y compris la compréhension de la progression et la détection des réussites, la lecture d'instruments, le pointage et le raisonnement spatial.
Le modèle Gemini Robotics ER 2 introduit deux points de terminaison de modèle :
gemini-robotics-er-2-preview: modèle ER 2 standard. S'appuie sur Gemini 3.5 Flash avec un raisonnement spatial amélioré, la recherche de moments vidéo, la classification de la progression vidéo, l'orchestration multirobot et l'utilisation d'outils en plusieurs étapes.gemini-robotics-er-2-streaming-preview: optimisé pour le streaming en temps réel à l'aide de l'API Live. Utilisez ce modèle pour les agents robotiques à faible latence qui traitent des entrées audio et vidéo continues.
Gemini Robotics ER 1.6 a été abandonné le 31 août 2026.
Si vous utilisez toujours Gemini Robotics ER 1.6, passez à Gemini Robotics ER 2 en remplaçant model="gemini-robotics-er-1.6-preview" par model="gemini-robotics-er-2-preview" ou model="gemini-robotics-er-2-streaming-preview" dans vos appels d'API.
Essayer Gemini Robotics ER 2 dans Google AI Studio
Fonctionnalités de robotique
Gemini Robotics ER est compatible avec un éventail de capacités de raisonnement incarné. Sélectionnez une fonctionnalité pour en savoir plus :
| Capacité | Description | Guide |
|---|---|---|
| Raisonnement spatial | Pointez sur des objets, suivez-les dans une vidéo, détectez-les avec des cadres de délimitation et planifiez des trajectoires. | Raisonnement spatial |
| Vision agentique | Utilisez l'exécution de code pour améliorer d'autres fonctionnalités en exploitant des outils de manipulation d'images. | Vision agentique |
| Orchestration des tâches | Combinez le raisonnement spatial avec des API de robot personnalisées pour effectuer des tâches à long horizon. | Orchestration des tâches |
| Streaming (point de terminaison de streaming Gemini Robotics ER 2 uniquement) | Streaming bidirectionnel pour les agents robotiques en temps réel avec appel de fonction à faible latence. | Streaming pour la robotique |
| Progression de la vidéo (Gemini Robotics ER 2 uniquement) | Détection de moments et classification de la progression à partir de flux vidéo continus. | Compréhension des vidéos |
Avant de commencer
Les modèles Gemini Robotics ER sont disponibles via l'API Gemini Developer. Pour commencer, créez une clé API Gemini à partir de Google AI Studio ou de la console Google Cloud, puis configurez votre environnement.
Pour en savoir plus sur les types de clés, la sécurité et la configuration de votre clé en Python, JavaScript et d'autres langages, consultez Utiliser des clés API Gemini.
Premiers pas
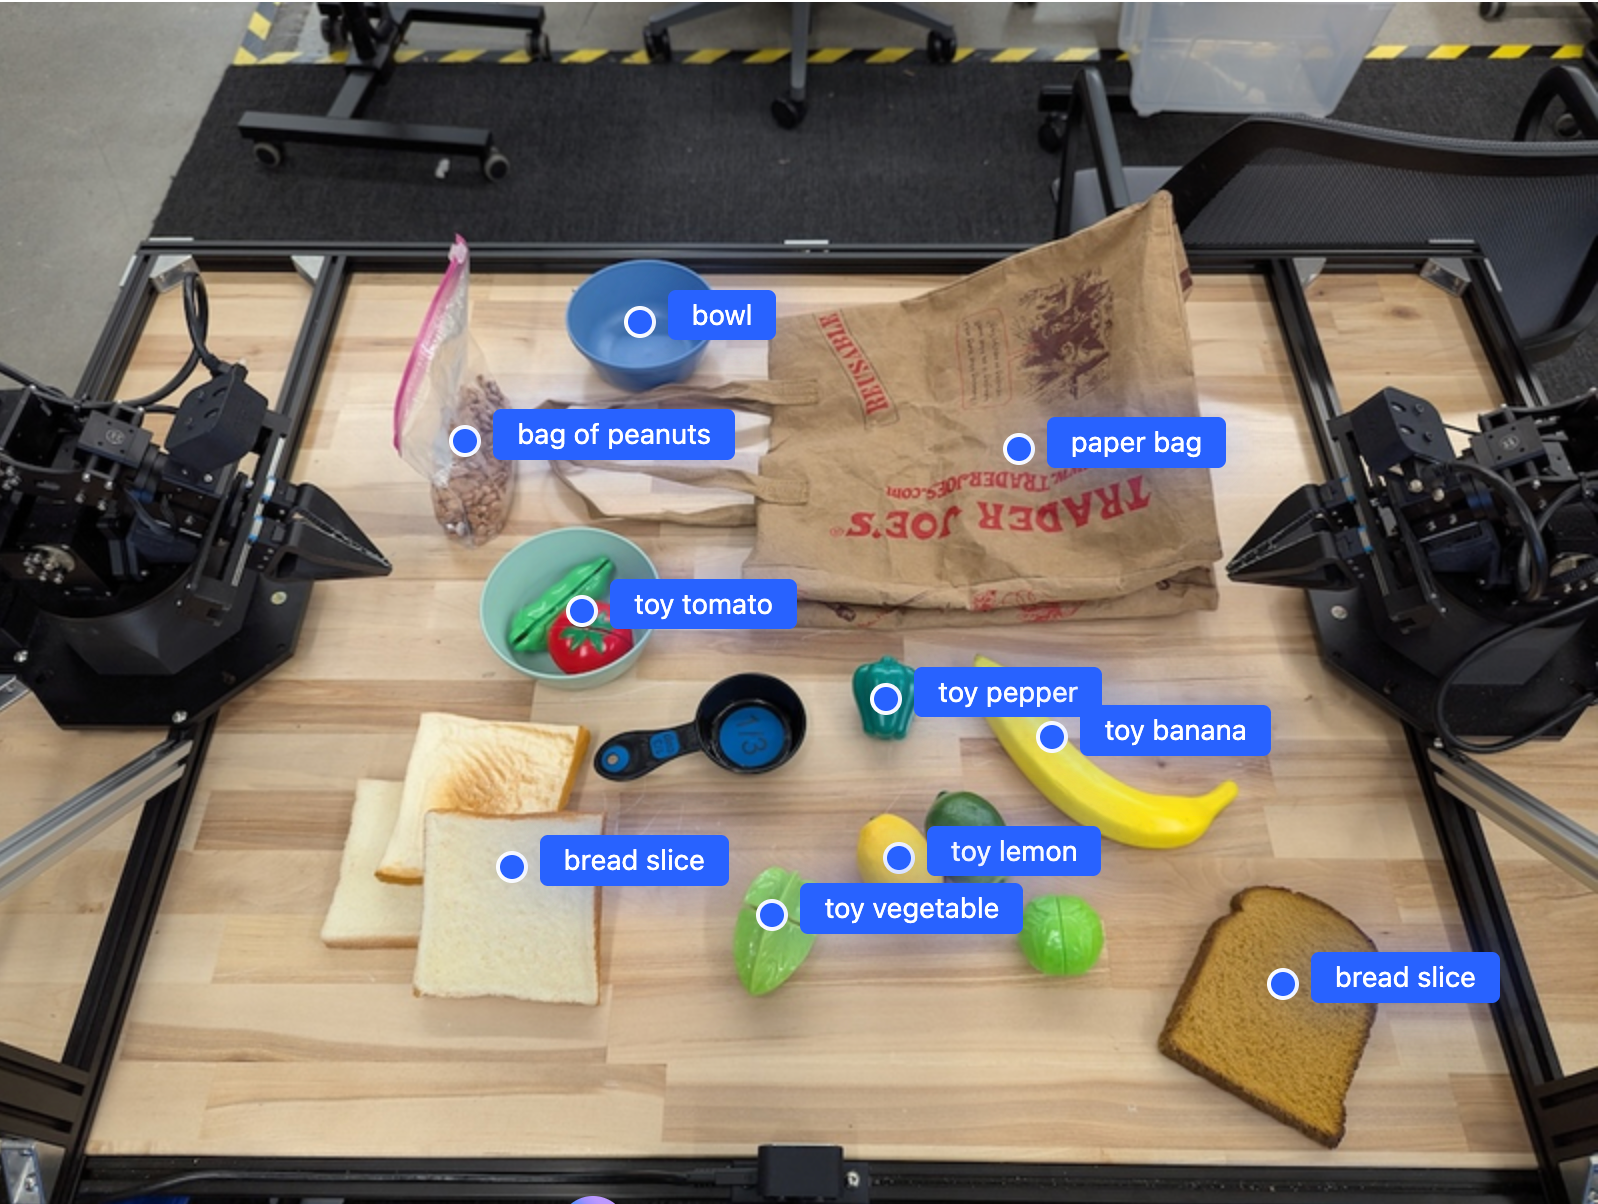
L'exemple suivant recherche des objets dans une image et renvoie leurs coordonnées 2D normalisées et leurs étiquettes. Vous pouvez transmettre ce résultat directement à une API de robotique ou à un modèle VLA pour générer des actions de robot.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
Le résultat sera un tableau JSON contenant des objets, chacun avec un point (coordonnées [y, x] normalisées) et un label identifiant l'objet.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
L'image suivante montre un exemple d'affichage de ces points :
Fonctionnement
Gemini Robotics ER accepte des images, des vidéos ou des fichiers audio en entrée avec des requêtes en langage naturel. Il identifie les objets, raisonne sur le contexte de la scène et les relations spatiales, et renvoie une sortie structurée, comme des coordonnées ou des cadres de délimitation.
Gemini Robotics ER est également agentique : il décompose les tâches complexes en sous-tâches et les exécute en appelant vos fonctions de robot ou en exécutant le code généré. Par exemple, "mettre la pomme dans le bol" devient une séquence d'étapes de localisation, de saisie et de placement.
Consultez Appel de fonction pour savoir comment Gemini exécute les appels d'outils.
Sécurité
Bien que Gemini Robotics ER ait été conçu dans un souci de sécurité, il est de votre responsabilité de maintenir un environnement sûr autour du robot. Les modèles d'IA générative peuvent faire des erreurs, et les robots physiques peuvent causer des dommages. Pour en savoir plus, consultez la page sur la sécurité de Gemini Robotics.
Bonnes pratiques
Utilisez un langage simple et naturel. Décrivez ce que vous voulez que le robot fasse, comme vous le feriez avec une personne. Si un terme ne fonctionne pas, essayez un synonyme courant.
Optimisez l'entrée visuelle. Recadrez ou zoomez sur les objets petits ou peu clairs avant d'envoyer l'image. La luminosité et un faible contraste des couleurs peuvent affecter la détection.
Décomposez les tâches complexes en étapes. Envoyez chaque étape sous la forme d'une requête distincte pour que le modèle reste concentré et pour améliorer la précision.
Interrogez plusieurs fois et calculez la moyenne des résultats pour les tâches de haute précision. Cette approche consensuelle réduit la variance des résultats spatiaux.
Limites
Tenez compte des limites suivantes lorsque vous développez avec Gemini Robotics ER :
- Restrictions des clés API : l'API Gemini n'accepte pas les requêtes provenant de clés API sans restriction et renvoie une erreur
403 Forbidden. Sécurisez votre clé API en ajoutant des restrictions dans AI Studio. Pour en savoir plus, consultez Sécuriser les clés API sans restriction. - Latence et performances : les requêtes complexes, les entrées haute résolution ou les niveaux de réflexion élevés peuvent entraîner des temps de traitement plus longs. Pour le niveau de réflexion, utilisez "Moyen" pour un bon équilibre entre latence et performances.
- Hallucinations : comme tous les grands modèles de langage, les modèles Gemini Robotics ER peuvent parfois "halluciner" ou fournir des informations incorrectes, en particulier pour les requêtes ambiguës ou les entrées hors distribution.
- Dépendance à la qualité du prompt : la qualité de la sortie dépend de la clarté du prompt d'entrée. Utilisez des prompts spécifiques et bien structurés.
- Coût de calcul : l'exécution du modèle, en particulier avec des entrées vidéo ou un
thinking_budgetélevé, consomme des ressources de calcul et entraîne des coûts. Pour en savoir plus, consultez la page Réflexion. - Types d'entrées : consultez les rubriques suivantes pour en savoir plus sur les limites de chaque mode.
Avis de confidentialité
Vous reconnaissez que les modèles référencés dans ce document (les "modèles robotiques") exploitent des données vidéo et audio pour faire fonctionner et déplacer votre matériel conformément à vos instructions. Vous pouvez donc utiliser les Modèles robotiques de manière à ce que des données de personnes identifiables, telles que des données vocales, des images et des données de ressemblance ("Données à caractère personnel"), soient collectées par les Modèles robotiques. Si vous choisissez d'utiliser les Modèles robotiques d'une manière qui collecte des Données à caractère personnel, vous acceptez de ne pas autoriser les personnes identifiables à interagir avec les Modèles robotiques ou à être présentes dans la zone qui les entoure, à moins que ces personnes identifiables n'aient été suffisamment informées et n'aient consenti au fait que leurs Données à caractère personnel puissent être fournies à Google et utilisées par Google, comme indiqué dans les Conditions d'utilisation supplémentaires de l'API Gemini disponibles à l'adresse https://ai.google.dev/gemini-api/terms (les "Conditions"), y compris conformément à la section intitulée "Comment Google utilise vos données". Vous devez vous assurer que cet avis autorise la collecte et l'utilisation des Données à caractère personnel comme indiqué dans les Conditions, et vous devez déployer des efforts commercialement raisonnables pour minimiser la collecte et la distribution des Données à caractère personnel en utilisant des techniques telles que le floutage des visages et en utilisant les Modèles robotiques dans des zones ne contenant pas de personnes identifiables, dans la mesure du possible.
Tarifs
Pour en savoir plus sur les tarifs et les régions disponibles, consultez la page Tarifs.
Points de terminaison de modèles
Gemini Robotics ER 2 Preview
| Propriété | Description |
|---|---|
| Code du modèle | gemini-robotics-er-2-preview |
| Types de données acceptés |
Entrées Texte, images, vidéo, audio Résultat Texte |
| Limites de jetons[*] |
Limite de jetons d'entrée 131 072 Limite de jetons de sortie 65 536 |
| Fonctionnalités | Not supported Compatible Compatible Compatible Compatible Compatible Compatible Not supported Not supported Compatible Compatible Compatible Compatible |
| Options de consommation |
Compatible Not supported Not supported |
| versions |
|
| Dernière mise à jour | Juillet 2026 |
| Fiche de modèle | fiche de modèle |
Preview de Gemini Robotics ER 2 Streaming
| Propriété | Description |
|---|---|
| Code du modèle | gemini-robotics-er-2-streaming-preview |
| Types de données acceptés |
Entrées Texte, images, vidéo, audio Résultat Texte |
| Limites de jetons[*] |
Limite de jetons d'entrée 131 072 Limite de jetons de sortie 65 536 |
| Fonctionnalités | Not supported Not supported Not supported Not supported Not supported Compatible Not supported Not supported Compatible Compatible Not supported Compatible Not supported |
| Options de consommation |
Not supported Not supported Not supported |
| versions |
|
| Dernière mise à jour | Juillet 2026 |
| Fiche de modèle | fiche de modèle |
Gemini Robotics ER 1.6 Preview
| Propriété | Description |
|---|---|
| Code du modèle | gemini-robotics-er-1.6-preview |
| Types de données acceptés |
Entrées Texte, images, vidéo, audio Résultat Texte |
| Limites de jetons[*] |
Limite de jetons d'entrée 131 072 Limite de jetons de sortie 65 536 |
| Fonctionnalités | Not supported Compatible Compatible Compatible Compatible Compatible Compatible Not supported Not supported Compatible Compatible Compatible Compatible |
| Options de consommation |
Compatible Not supported Not supported |
| versions |
|
| Dernière mise à jour | Décembre 2025 |
| Date limite des connaissances (ou "knowledge cutoff") | Janvier 2025 |
Étape suivante
- Raisonnement spatial : pointage, suivi, cadres de délimitation, trajectoires.
- Capacités agentiques : exécution de code, lecture d'instruments, annotation d'images.
- Orchestration des tâches : tâches à long horizon avec des API de robot personnalisées.
- Robotique avec streaming : streaming bidirectionnel en temps réel (Gemini Robotics ER 2 uniquement).
- Compréhension vidéo : recherche de moments et classification de la progression (Gemini Robotics ER 2 uniquement).
- Sécurité de Gemini Robotics : recherche sur la sécurité derrière la famille de modèles.