

Os modelos Gemini Robotics ER (raciocínio incorporado) são modelos de visão-linguagem (VLMs) que permitem que os robôs percebam e interajam com o mundo físico. Eles interpretam dados visuais, realizam raciocínio espacial e temporal, planejam tarefas de várias etapas e orquestram robôs e ferramentas.
Modelos
O modelo Gemini Robotics ER 2 é o mais recente do Gemini Robotics. É nosso modelo de raciocínio atualizado que permite que os robôs entendam os ambientes com precisão. Ele é especializado em recursos de raciocínio incorporado, como orquestração agêntica de robôs (por exemplo, usando VLAs), compreensão de vídeo de robôs, incluindo compreensão de progresso e detecção de sucesso, leitura de instrumentos, apontamento e raciocínio espacial.
O modelo Gemini Robotics ER 2 apresenta dois endpoints de modelo:
gemini-robotics-er-2-preview: o modelo ER 2 padrão. Criado com base no Gemini 3.5 Flash, com melhorias no raciocínio espacial, na localização de momentos em vídeos, na classificação de progresso de vídeos, na orquestração de vários robôs e no uso de ferramentas em várias etapas.gemini-robotics-er-2-streaming-preview: otimizado para streaming em tempo real usando a API Live. Use esse modelo para agentes robóticos de baixa latência que processam entradas contínuas de áudio e vídeo.
O Gemini Robotics ER 1.6 foi
descontinuado em 31 de agosto de 2026.
Se você ainda estiver usando o Gemini Robotics ER 1.6, faça upgrade para o Gemini Robotics ER 2
substituindo model="gemini-robotics-er-1.6-preview" por
model="gemini-robotics-er-2-preview" ou
model="gemini-robotics-er-2-streaming-preview" nas chamadas de API.
Teste o Gemini Robotics ER 2 no Google AI Studio
Recursos de robótica
O Gemini Robotics ER oferece suporte a uma variedade de recursos de raciocínio incorporado. Selecione um recurso para saber mais:
| Capacidade | Descrição | Guia |
|---|---|---|
| Raciocínio espacial | Aponte para objetos, rastreie-os em vídeos, detecte-os com caixas delimitadoras, planeje trajetórias. | Raciocínio espacial |
| Visão agêntica | Use a execução de código para aprimorar outros recursos com ferramentas de manipulação de imagens. | Visão agêntica |
| Orquestração de tarefas | Combine o raciocínio espacial com APIs de robôs personalizadas para concluir tarefas de longo alcance. | Orquestração de tarefas |
| Streaming (somente endpoint de streaming do Gemini Robotics ER 2) | Streaming bidirecional para agentes robóticos em tempo real com chamada de função de baixa latência. | Streaming para robótica |
| Progresso do vídeo (somente Gemini Robotics ER 2) | Descoberta de momentos e classificação de progresso em feeds de vídeo contínuos. | Compreensão do vídeo |
Antes de começar
Os modelos de ER do Gemini Robotics estão disponíveis na API Gemini Developer. Para começar, crie uma chave de API Gemini no Google AI Studio ou no console do Google Cloud e configure seu ambiente.
Para detalhes sobre tipos de chave, segurança e como configurar sua chave em Python, JavaScript e outras linguagens, consulte Como usar chaves de API Gemini.
Primeiros passos
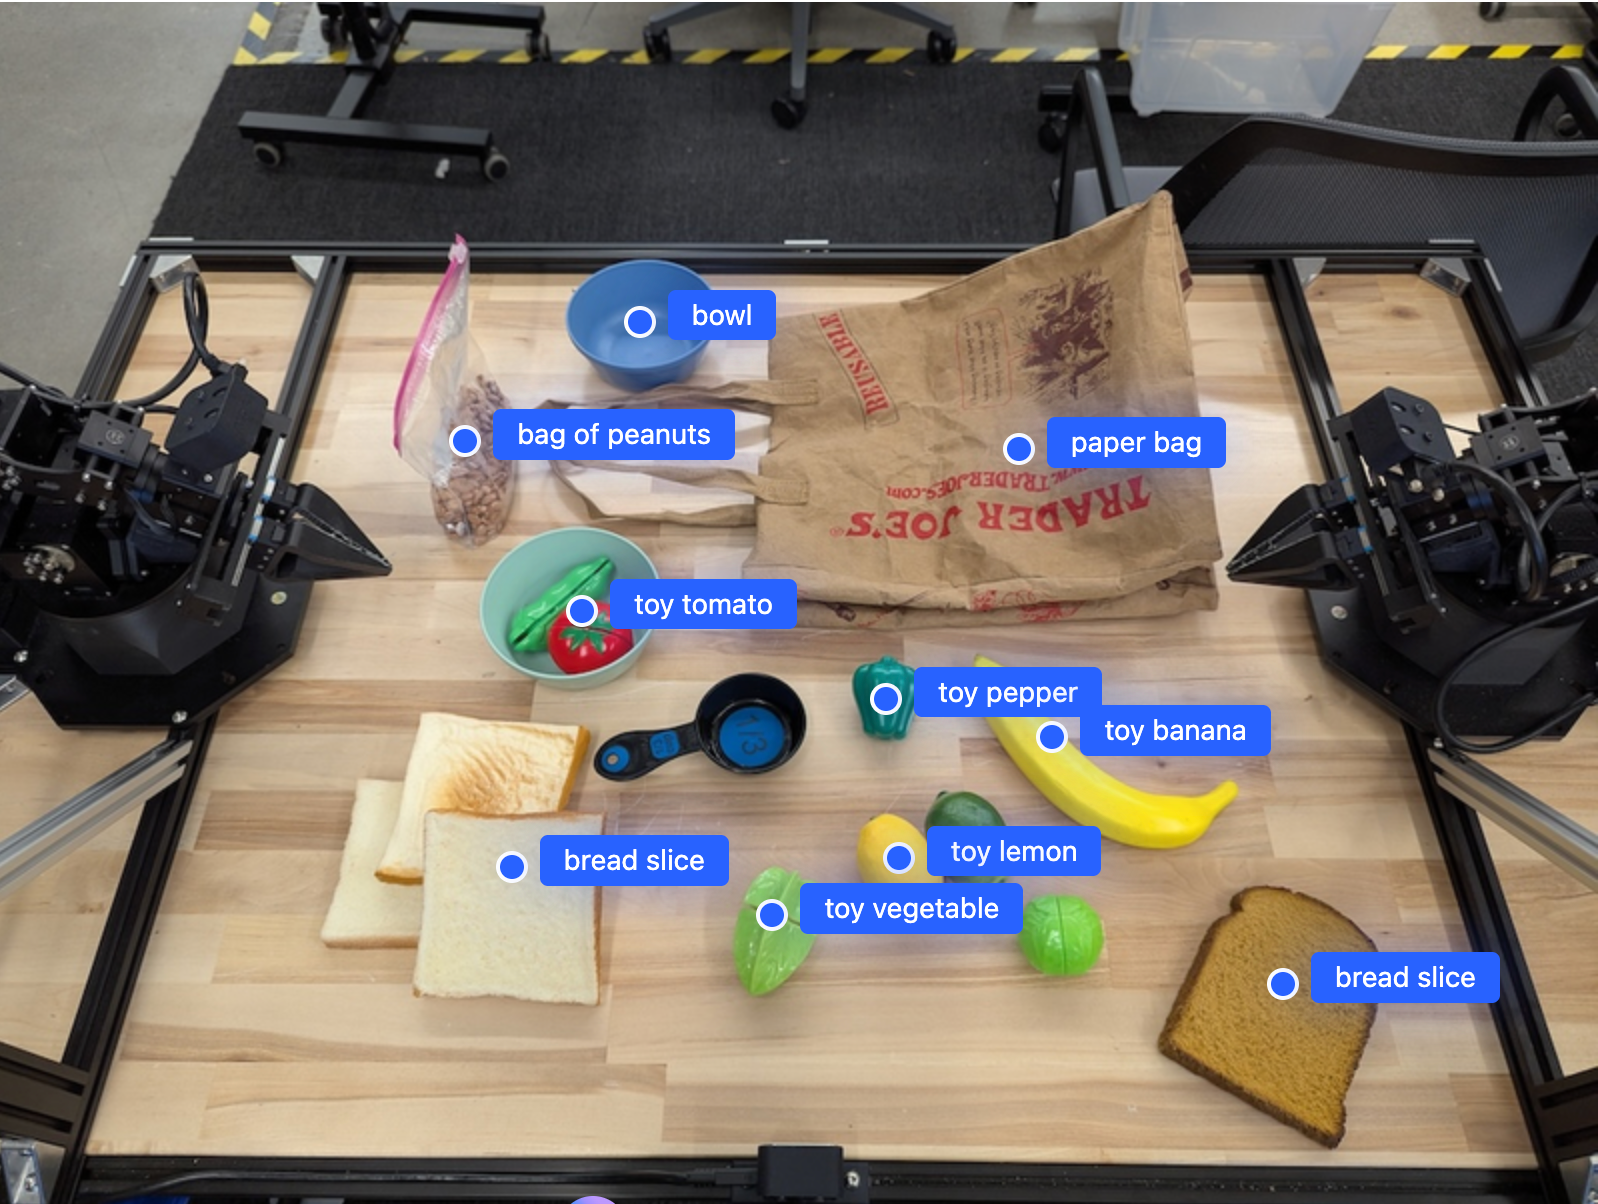
O exemplo a seguir encontra objetos em uma imagem e retorna as coordenadas 2D normalizadas e os rótulos deles. É possível transmitir essa saída diretamente para uma API de robótica ou um modelo de VLA para gerar ações de robô.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
A saída será uma matriz JSON com objetos, cada um com um point
(coordenadas [y, x] normalizadas) e um label que identifica o objeto.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
A imagem a seguir é um exemplo de como esses pontos podem ser exibidos:
Como funciona
O Gemini Robotics ER recebe entradas de imagem, vídeo ou áudio com comandos de linguagem natural. Ele identifica objetos, raciocina sobre o contexto da cena e as relações espaciais e retorna uma saída estruturada, como coordenadas ou caixas delimitadoras.
O Gemini Robotics ER também é agêntico: ele divide tarefas complexas em subtarefas e as executa chamando as funções do robô ou executando o código gerado. Por exemplo, "colocar a maçã na tigela" se torna uma sequência de etapas de localização, captura e colocação.
Consulte Chamada de função para saber como o Gemini executa chamadas de ferramentas.
Segurança
Embora o Gemini Robotics ER tenha sido criado com a segurança em mente, é sua responsabilidade manter um ambiente seguro ao redor do robô. Os modelos de IA generativa podem cometer erros, e os robôs físicos podem causar danos. Para saber mais, acesse a página de segurança da Gemini Robotics.
Práticas recomendadas
Use uma linguagem simples e natural. Descreva o que você quer que o robô faça como se estivesse falando com uma pessoa. Se um termo não funcionar, tente um sinônimo comum.
Otimize a entrada visual. Corte ou amplie objetos pequenos ou pouco nítidos antes de enviar a imagem. A iluminação e o baixo contraste de cores podem afetar a detecção.
Divida tarefas complexas em etapas. Envie cada etapa como um comando separado para manter o modelo focado e melhorar a precisão.
Faça várias consultas e calcule a média dos resultados para tarefas de alta precisão. Essa abordagem de consenso reduz a variância nas saídas espaciais.
Limitações
Considere as seguintes limitações ao desenvolver com o Gemini Robotics ER:
- Restrições de chave de API:a API Gemini não aceita solicitações de
chaves de API irrestritas e retorna um erro
403 Forbidden. Proteja sua chave de API adicionando restrições no AI Studio. Consulte Proteger chaves de API irrestritas para mais detalhes. - Latência x desempenho:consultas complexas, entradas de alta resolução ou níveis de raciocínio elevados podem aumentar o tempo de processamento. Para o nível de raciocínio, use o médio para um bom equilíbrio entre latência e desempenho.
- Alucinações:como todos os modelos de linguagem grandes, os modelos de ER da Gemini Robotics podem, às vezes, "alucinar" ou fornecer informações incorretas, especialmente para comandos ambíguos ou entradas fora da distribuição.
- Dependência da qualidade do comando:a qualidade da saída depende da clareza do comando de entrada. Use comandos específicos e bem estruturados.
- Custo computacional:a execução do modelo, especialmente com entradas de vídeo ou
thinking_budgetalto, consome recursos computacionais e gera custos. Consulte a página Raciocínio para mais detalhes. - Tipos de entrada:consulte os tópicos a seguir para saber mais sobre as limitações de cada modo.
Aviso de privacidade
Você reconhece que os modelos mencionados neste documento (os "Modelos de Robótica") usam dados de vídeo e áudio para operar e mover seu hardware de acordo com suas instruções. Portanto, você pode operar os Modelos de Robótica de modo que dados de pessoas identificáveis, como voz, imagens e dados de semelhança ("Dados Pessoais"), sejam coletados pelos Modelos de Robótica. Se você optar por operar os Modelos de Robótica de uma maneira que colete Dados Pessoais, você concorda que não permitirá que nenhuma pessoa identificável interaja com os Modelos de Robótica ou esteja presente na área ao redor deles, a menos que e até que essas pessoas identificáveis tenham sido suficientemente notificadas e tenham consentido com o fato de que seus Dados Pessoais podem ser fornecidos e usados pelo Google, conforme descrito nos Termos Adicionais de Serviço da API Gemini, disponíveis em https://ai.google.dev/gemini-api/terms (os "Termos"), incluindo de acordo com a seção intitulada "Como o Google usa seus dados". Você vai garantir que esse aviso permita a coleta e o uso de Dados Pessoais, conforme descrito nos Termos, e vai empregar esforços comercialmente razoáveis para minimizar a coleta e a distribuição de Dados Pessoais usando técnicas como desfoque de rosto e operação dos Modelos de Robótica em áreas que não contenham pessoas identificáveis, na medida do possível.
Preços
Para informações detalhadas sobre preços e regiões disponíveis, consulte a página de preços.
Endpoints de modelos
Pré-lançamento do Gemini Robotics ER 2
| Propriedade | Descrição |
|---|---|
| Código do modelo | gemini-robotics-er-2-preview |
| Tipos de dados aceitos |
Entradas (link em inglês) Texto, imagens, vídeo, áudio Saída Texto |
| Limites de tokens[*] |
Limite de tokens de entrada 131.072 Limite de tokens de saída 65.536 |
| Recursos | incompatível Compatível Compatível Compatível Compatível Compatível Compatível incompatível incompatível Compatível Compatível Compatível Compatível |
| Opções de consumo |
Compatível incompatível incompatível |
| Versões |
|
| Atualização mais recente | Julho de 2026 |
| Card de modelo | Card de modelo |
Pré-lançamento de streaming do Gemini Robotics ER 2
| Propriedade | Descrição |
|---|---|
| Código do modelo | gemini-robotics-er-2-streaming-preview |
| Tipos de dados aceitos |
Entradas (link em inglês) Texto, imagens, vídeo, áudio Saída Texto |
| Limites de tokens[*] |
Limite de tokens de entrada 131.072 Limite de tokens de saída 65.536 |
| Recursos | incompatível incompatível incompatível incompatível incompatível Compatível incompatível incompatível Compatível Compatível incompatível Compatível incompatível |
| Opções de consumo |
incompatível incompatível incompatível |
| Versões |
|
| Atualização mais recente | Julho de 2026 |
| Card de modelo | Card de modelo |
Pré-lançamento do Gemini Robotics ER 1.6
| Propriedade | Descrição |
|---|---|
| Código do modelo | gemini-robotics-er-1.6-preview |
| Tipos de dados aceitos |
Entradas (link em inglês) Texto, imagens, vídeo, áudio Saída Texto |
| Limites de tokens[*] |
Limite de tokens de entrada 131.072 Limite de tokens de saída 65.536 |
| Recursos | incompatível Compatível Compatível Compatível Compatível Compatível Compatível incompatível incompatível Compatível Compatível Compatível Compatível |
| Opções de consumo |
Compatível incompatível incompatível |
| Versões |
|
| Atualização mais recente | Dezembro de 2025 |
| Limite de conhecimento | Janeiro de 2025 |
A seguir
- Raciocínio espacial: apontar, rastrear, caixas delimitadoras, trajetórias.
- Recursos agênticos: execução de código, leitura de instrumentos, anotação de imagens.
- Orquestração de tarefas: tarefas de longo alcance com APIs de robô personalizadas.
- Robótica com streaming: streaming bidirecional em tempo real (somente Gemini Robotics ER 2).
- Compreensão de vídeo: localização de momentos e classificação de progresso (somente no Gemini Robotics ER 2).
- Segurança do Gemini Robotics: pesquisa de segurança por trás da família de modelos.