

نماذج Gemini Robotics ER (الاستدلال المجسّد) هي نماذج للرؤية واللغة (VLM) تتيح للروبوتات إدراك العالم المادي والتفاعل معه. وهي تفسّر البيانات المرئية، وتجري عمليات استدلال مكاني وزماني، وتخطّط لمهام متعدّدة الخطوات، وتنسّق بين الروبوتات والأدوات.
النماذج
Gemini Robotics ER 2 هو أحدث نموذج في Gemini Robotics. وهو نموذج محدّث للاستدلال يتيح للروبوتات فهم بيئاتها بدقة. وهي متخصّصة في إمكانات الاستدلال المجسّد، مثل التنسيق بين برامج الروبوت (مثل استخدام المساعدين الافتراضيين المرئيين) وفهم فيديوهات الروبوت، بما في ذلك فهم التقدم المحرز ورصد النجاح وقراءة الأدوات والإشارة والاستدلال المكاني.
يقدّم نموذج Gemini Robotics ER 2 نقطتَي نهاية للنموذج:
-
gemini-robotics-er-2-preview: نموذج ER 2 العادي يستند إلى Gemini 3.5 Flash مع تحسينات على الاستدلال المكاني، والعثور على لحظات في الفيديو، وتصنيف تقدّم الفيديو، وتنسيق عمل الروبوتات المتعددة، واستخدام الأدوات المتعددة الخطوات. gemini-robotics-er-2-streaming-preview: تم تحسينه للبث المباشر في الوقت الفعلي من خلال Live API. استخدِم هذا النموذج لتطبيقات الروبوتات التي تتطلّب زمن استجابة منخفضًا وتتعامل مع بيانات صوت وفيديو متواصلة.
إذا كنت تستخدم Gemini Robotics ER 1.6، يمكنك الترقية إلى Gemini Robotics ER 2 من خلال استبدال
model="gemini-robotics-er-1.6-preview" بـ
model="gemini-robotics-er-2-preview" أو
model="gemini-robotics-er-2-streaming-preview" في طلبات البيانات من واجهة برمجة التطبيقات. يُرجى العلم أنّه سيتم إيقاف نموذج Gemini Robotics ER 1.6 في نهاية أغسطس.
تجربة الإصدار الثاني من Gemini Robotics في Google AI Studio
إمكانات علم الروبوتات
يتيح Gemini Robotics ER مجموعة من إمكانات الاستدلال المجسَّد. اختَر إحدى الإمكانيات لمعرفة المزيد:
| إمكانية | الوصف | الدليل |
|---|---|---|
| الاستدلال المكاني | توجيه الكاميرا نحو الأجسام وتتبُّعها في الفيديو ورصدها باستخدام مربّعات حدودية وتخطيط مساراتها | الاستدلال المكاني |
| الرؤية المستنِدة إلى الذكاء الاصطناعي الوكيل | استخدِم ميزة "تنفيذ الرموز البرمجية" لتحسين الإمكانات الأخرى من خلال الاستفادة من أدوات معالجة الصور. | الرؤية المستندة إلى الذكاء الاصطناعي الوكيل |
| تنظيم المهام | يمكنك الجمع بين الاستدلال المكاني وواجهات برمجة التطبيقات المخصّصة للروبوتات لإكمال مهام طويلة الأمد. | تنظيم المهام |
| البث (نقطة نهاية البث في Gemini Robotics ER 2 فقط) | بث ثنائي الاتجاه لوكلاء الروبوت في الوقت الفعلي مع إمكانية طلب الدوال بوقت استجابة منخفض | البث المباشر للروبوتات |
| شريط تقدّم الفيديو (ميزة حصرية في Gemini Robotics ER 2) | العثور على لحظات وتصنيف مستوى التقدّم من خلاصات الفيديو المتواصلة | فهم الفيديوهات |
الخطوات الأولى
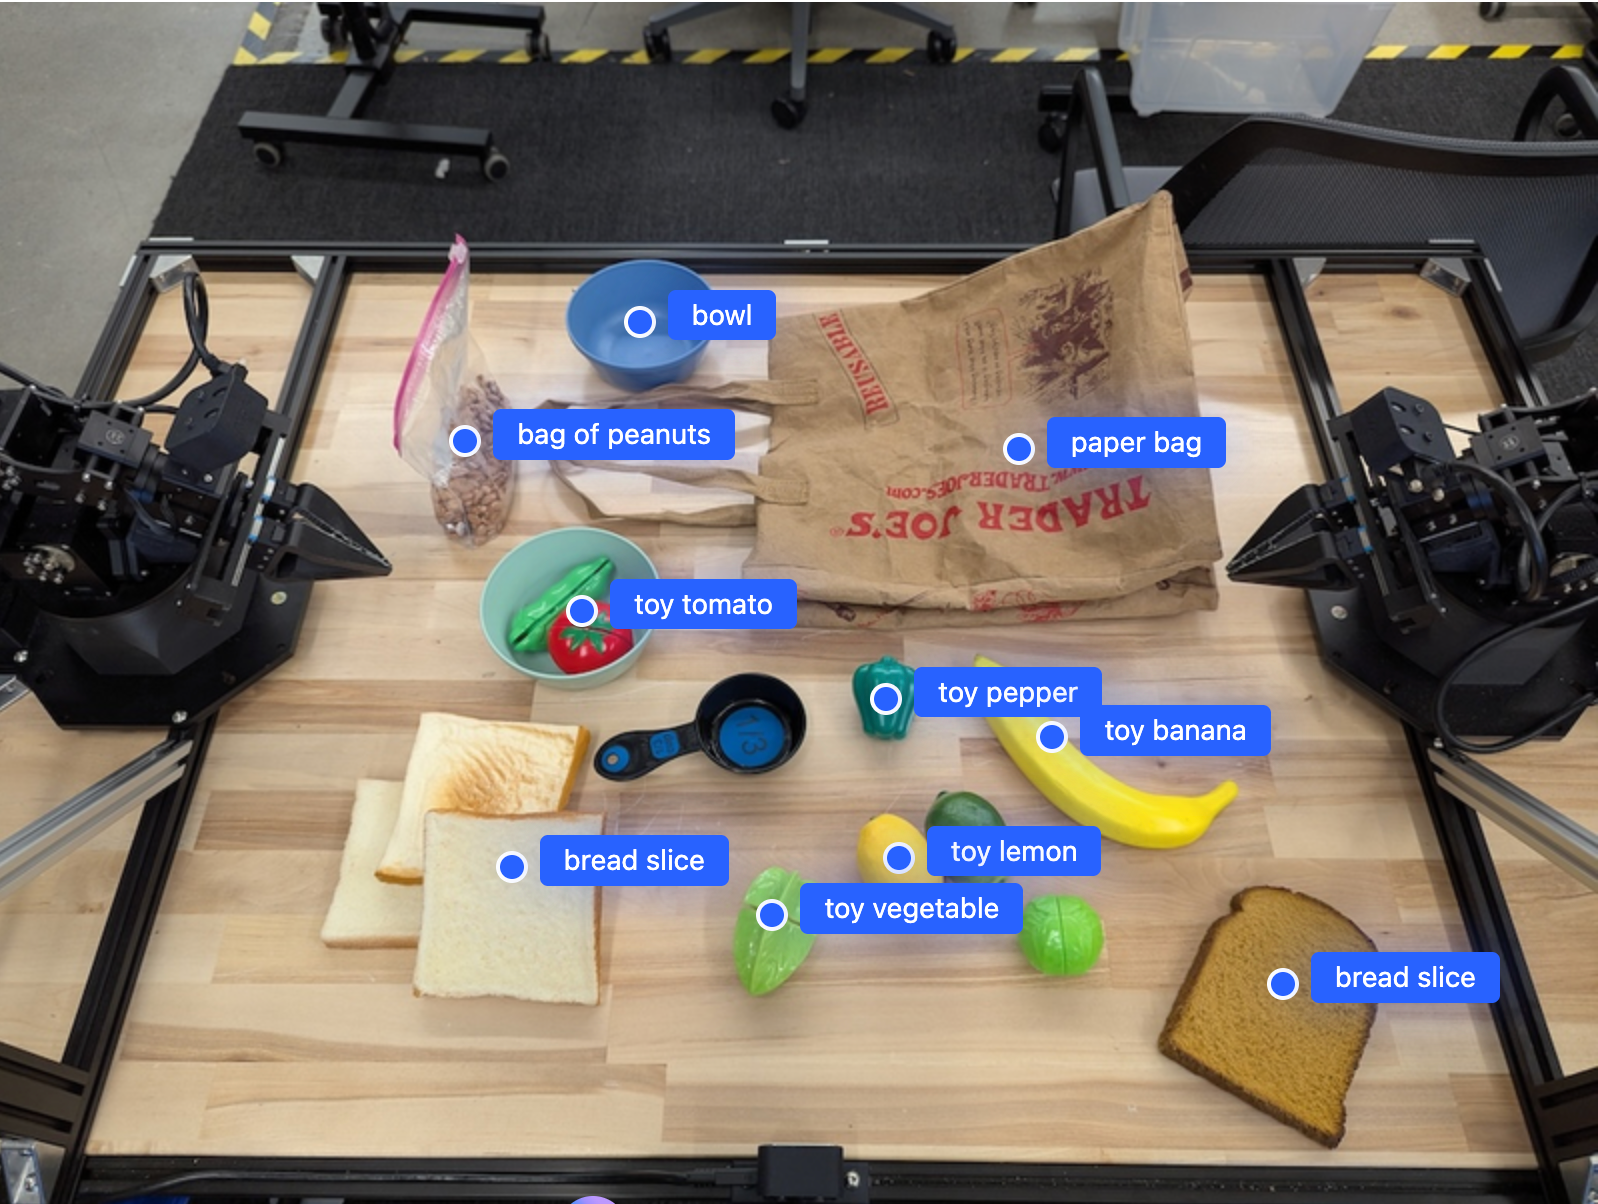
يعثر المثال التالي على عناصر في صورة ويعرض إحداثياتها الثنائية الأبعاد العادية وتصنيفاتها. يمكنك تمرير هذا الناتج مباشرةً إلى واجهة برمجة تطبيقات خاصة بالروبوتات أو إلى نموذج VLA لإنشاء إجراءات الروبوت.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
جافا
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
سيكون الناتج مصفوفة JSON تحتوي على عناصر، كل منها يتضمّن point (إحداثيات [y, x] موحّدة) وlabel لتحديد العنصر.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
في ما يلي مثال على كيفية عرض هذه النقاط:
آلية العمل
تتلقّى Gemini Robotics ER الصور أو الفيديوهات أو المحتوى الصوتي من خلال طلبات مكتوبة باللغة الطبيعية. تحدّد هذه الخدمة العناصر، وتستنتج سياق المشهد والعلاقات المكانية، وتعرض نتائج منظَّمة، مثل الإحداثيات أو مربّعات الإحاطة.
تتّسم Gemini Robotics ER أيضًا بالقدرة على اتخاذ القرارات: فهي تقسم المهام المعقّدة إلى مهام فرعية وتنفّذها من خلال استدعاء وظائف الروبوت أو تشغيل الرمز البرمجي الذي تم إنشاؤه. على سبيل المثال، تتحوّل الجملة "ضَع التفاحة في الوعاء" إلى سلسلة من الخطوات التي تتضمّن تحديد الموقع والإمساك والوضع.
يمكنك الاطّلاع على استدعاء الدوال للحصول على تفاصيل حول طريقة تنفيذ Gemini لطلبات استخدام الأدوات.
الأمان
على الرغم من أنّ Gemini Robotics ER مصمَّم مع مراعاة السلامة، تقع على عاتقك مسؤولية الحفاظ على بيئة آمنة حول الروبوت. قد ترتكب نماذج الذكاء الاصطناعي التوليدي أخطاءً، وقد تتسبّب الروبوتات المادية في إلحاق الضرر. لمزيد من المعلومات، يُرجى الانتقال إلى صفحة أمان الروبوتات في Google DeepMind.
أفضل الممارسات
استخدِم اللغة الطبيعية. قدِّم وصفًا لما تريد أن ينفّذه الروبوت كما لو كنت تتحدث إلى شخص. إذا لم تنجح عبارة بحث، جرِّب استخدام مرادف شائع.
تحسين الإدخال المرئي اقطع أو كبِّر العناصر الصغيرة أو غير الواضحة قبل إرسال الصورة. يمكن أن تؤثر الإضاءة والتباين المنخفض للألوان في عملية الرصد.
قسِّم المهام المعقّدة إلى خطوات. أرسِل كل خطوة كطلب منفصل للحفاظ على تركيز النموذج وتحسين الدقة.
إرسال طلبات بحث متعددة والحصول على متوسط النتائج للمهام التي تتطلّب دقة عالية يقلّل نهج التوافق هذا من التباين في النتائج المكانية.
القيود
يجب مراعاة القيود التالية عند التطوير باستخدام Gemini Robotics ER:
- القيود المفروضة على مفتاح واجهة برمجة التطبيقات: لا تقبل Gemini API الطلبات الواردة من مفاتيح واجهة برمجة التطبيقات غير الخاضعة لقيود، وتعرض الخطأ
403 Forbidden. يمكنك حماية مفتاح واجهة برمجة التطبيقات من خلال إضافة قيود في AI Studio. لمزيد من التفاصيل، يمكنك الاطّلاع على تأمين مفاتيح واجهة برمجة التطبيقات غير المحظورة. - وقت الاستجابة مقابل الأداء: يمكن أن تؤدي الطلبات المعقّدة أو المدخلات العالية الدقة أو مستويات التفكير العالية إلى زيادة أوقات المعالجة. بالنسبة إلى مستوى التفكير، استخدِم متوسطًا لتحقيق توازن جيد بين وقت الاستجابة والأداء.
- الهلوسات: مثل جميع النماذج اللغوية الكبيرة، يمكن أن "تهلوس" نماذج Gemini Robotics ER في بعض الأحيان أو تقدّم معلومات غير صحيحة، خاصةً عند تلقّي طلبات غامضة أو مدخلات خارج نطاق التوزيع.
- الاعتماد على جودة الطلب: تعتمد جودة النتائج على وضوح الطلب المُدخَل. استخدِم طلبات محدّدة ومنظَّمة بشكل جيد.
- التكلفة الحسابية: يؤدي تشغيل النموذج، خاصةً مع إدخال فيديوهات أو
thinking_budgetعالية، إلى استهلاك موارد حسابية وتكبّد تكاليف. يمكنك الاطّلاع على صفحة التفكير لمزيد من التفاصيل. - أنواع الإدخال: اطّلِع على المواضيع التالية لمعرفة تفاصيل عن القيود المفروضة على كل وضع.
إشعار الخصوصية
أنت تقرّ بأنّ النماذج المشار إليها في هذا المستند ("نماذج الروبوتات") تستخدم بيانات الفيديو والصوت لتشغيل الأجهزة وتحريكها وفقًا لتعليماتك. وبالتالي، يمكنك تشغيل "نماذج الروبوتات" بطريقة تؤدي إلى جمع بيانات من أشخاص يمكن التعرّف عليهم، مثل بيانات الصوت والصور والتشابه ("البيانات الشخصية"). إذا اخترت تشغيل "نماذج الروبوتات" بطريقة تجمع البيانات الشخصية، أنت توافق على عدم السماح لأي أشخاص يمكن التعرّف عليهم بالتفاعل مع "نماذج الروبوتات" أو التواجد في المنطقة المحيطة بها، إلا بعد إبلاغ هؤلاء الأشخاص بشكل كافٍ وموافقتهم على إمكانية تقديم بياناتهم الشخصية إلى Google واستخدامها من قِبلها على النحو الموضّح في "بنود الخدمة الإضافية الخاصة بواجهة Gemini API" المتوفّرة على الرابط https://ai.google.dev/gemini-api/terms (يُشار إليها باسم "البنود")، بما في ذلك وفقًا للقسم بعنوان "كيفية استخدام Google لبياناتك". عليك التأكّد من أنّ هذا الإشعار يسمح بجمع البيانات الشخصية واستخدامها على النحو الموضّح في "البنود"، وعليك بذل جهود معقولة تجاريًا للحدّ من جمع البيانات الشخصية وتوزيعها من خلال استخدام تقنيات مثل تمويه الوجوه وتشغيل "نماذج الروبوتات" في مناطق لا تحتوي على أشخاص يمكن التعرّف عليهم إلى الحدّ الذي يمكن تنفيذه عمليًا.
الأسعار
للحصول على معلومات تفصيلية حول الأسعار والمناطق المتاحة، يُرجى الرجوع إلى صفحة الأسعار.
نقاط نهاية النماذج
Gemini Robotics ER 2 Preview
| الموقع | الوصف |
|---|---|
| رمز النموذج | gemini-robotics-er-2-preview |
| أنواع البيانات المتوافقة |
المدخلات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| حدود الرموز المميزة[*] |
الحدّ الأقصى لعدد الرموز المميزة التي يمكن إدخالها 131,072 الحدّ الأقصى لرموز الناتج المميزة 65,536 |
| الإمكانات | غير متاح متاح متاح متاح متاح متاح متاح غير متاح غير متاح متاح متاح متاح متاح |
| خيارات الاستهلاك |
متاح غير متاح غير متاح |
| Versions |
|
| آخر تعديل | يوليو 2026 |
| بطاقة النموذج | بطاقة النموذج |
معاينة البث المباشر لـ Gemini Robotics ER 2
| الموقع | الوصف |
|---|---|
| رمز النموذج | gemini-robotics-er-2-streaming-preview |
| أنواع البيانات المتوافقة |
المدخلات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| حدود الرموز المميزة[*] |
الحدّ الأقصى لعدد الرموز المميزة التي يمكن إدخالها 131,072 الحدّ الأقصى لرموز الناتج المميزة 65,536 |
| الإمكانات | غير متاح غير متاح غير متاح غير متاح غير متاح متاح غير متاح غير متاح متاح متاح غير متاح متاح غير متاح |
| خيارات الاستهلاك |
غير متاح غير متاح غير متاح |
| Versions |
|
| آخر تعديل | يوليو 2026 |
| بطاقة النموذج | بطاقة النموذج |
Gemini Robotics ER 1.6 Preview
| الموقع | الوصف |
|---|---|
| رمز النموذج | gemini-robotics-er-1.6-preview |
| أنواع البيانات المتوافقة |
المدخلات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| حدود الرموز المميزة[*] |
الحدّ الأقصى لعدد الرموز المميزة التي يمكن إدخالها 131,072 الحدّ الأقصى لرموز الناتج المميزة 65,536 |
| الإمكانات | غير متاح متاح متاح متاح متاح متاح متاح غير متاح غير متاح متاح متاح متاح متاح |
| خيارات الاستهلاك |
متاح غير متاح غير متاح |
| Versions |
|
| آخر تعديل | ديسمبر 2025 |
| تاريخ آخر تحديث للبيانات | يناير 2025 |
الخطوات التالية
- الاستدلال المكاني: الإشارة والتتبّع ومربّعات الحدود والمسارات
- إمكانات بالذكاء الاصطناعي الوكيل: تطبيق الرموز البرمجية، وقياس حالة التطبيق، وإضافة تعليقات توضيحية على الصور.
- تنظيم المهام: مهام طويلة الأمد باستخدام واجهات برمجة تطبيقات مخصّصة للروبوتات
- الروبوتات مع البث: بث ثنائي الاتجاه في الوقت الفعلي (Gemini Robotics ER 2 فقط)
- فهم الفيديو: العثور على اللحظات وتصنيف مستوى التقدّم (الإصدار الثاني من Gemini Robotics فقط)
- أمان الروبوتات في Google DeepMind: أبحاث الأمان التي تستند إليها مجموعة النماذج