

Gemini Robotics ER-Modelle (Embodied Reasoning) sind Vision-Language-Modelle (VLMs), mit denen Roboter die physische Welt wahrnehmen und mit ihr interagieren können. Sie interpretieren visuelle Daten, führen räumliche und zeitliche Schlussfolgerungen durch, planen mehrstufige Aufgaben und orchestrieren Roboter und Tools.
Modelle
Das Gemini Robotics ER 2-Modell ist das neueste Modell von Gemini Robotics. Es ist unser aktualisiertes Reasoning-Modell, mit dem Roboter ihre Umgebung genau verstehen können. Es ist auf Funktionen für verkörpertes Denken spezialisiert, z. B. die agentische Orchestrierung von Robotern (z. B. mit VLAs), das Verständnis von Robotervideos, einschließlich des Verständnisses von Fortschritten und der Erkennung von Erfolgen, das Ablesen von Instrumenten, das Zeigen und das räumliche Denken.
Das Gemini Robotics ER 2-Modell bietet zwei Modellendpunkte:
gemini-robotics-er-2-preview: Das Standard-ER 2-Modell. Basiert auf Gemini 3.5 Flash und bietet verbesserte räumliche Schlussfolgerungen, die Suche nach Videomomenten, die Klassifizierung des Videofortschritts, die Orchestrierung mehrerer Roboter und die Verwendung von Tools mit mehreren Schritten.gemini-robotics-er-2-streaming-preview: Optimiert für Echtzeit-Streaming mit der Live API. Verwenden Sie dieses Modell für Roboter-Agenten mit niedriger Latenz, die kontinuierliche Audio- und Videoeingaben verarbeiten.
Gemini Robotics ER 1.6 wurde am 31. August 2026 eingestellt.
Wenn Sie noch Gemini Robotics ER 1.6 verwenden, führen Sie ein Upgrade auf Gemini Robotics ER 2 durch, indem Sie in Ihren API-Aufrufen model="gemini-robotics-er-1.6-preview" durch model="gemini-robotics-er-2-preview" oder model="gemini-robotics-er-2-streaming-preview" ersetzen.
Gemini Robotics ER 2 in Google AI Studio testen
Robotikfunktionen
Gemini Robotics ER unterstützt eine Reihe von Funktionen für verkörpertes Denken. Wählen Sie eine Funktion aus, um mehr zu erfahren:
| Funktion | Beschreibung | Leitfaden |
|---|---|---|
| Räumliches Denken | Auf Objekte zeigen, sie in Videos verfolgen, mit Begrenzungsrahmen erkennen und Trajektorien planen. | Räumliches Denken |
| Agentic Vision | Mit der Code-Ausführung können Sie andere Funktionen verbessern, indem Sie Tools zur Bildbearbeitung nutzen. | Agentische Vision |
| Aufgabenorchestrierung | Kombinieren Sie räumliches Denken mit benutzerdefinierten Roboter-APIs, um langfristige Aufgaben zu erledigen. | Aufgabenorchestrierung |
| Streaming (nur Gemini Robotics ER 2-Streaming-Endpunkt) | Bidirektionales Streaming für Echtzeit-Roboter-Agents mit Funktionsaufrufen mit niedriger Latenz. | Streaming für Robotik |
| Videofortschritt (nur Gemini Robotics ER 2) | Momentfindung und Fortschrittsklassifizierung aus kontinuierlichen Videofeeds. | Video-Understanding |
Hinweis
Die Gemini Robotics ER-Modelle sind über die Gemini Developer API verfügbar. Erstellen Sie zuerst einen Gemini API-Schlüssel in Google AI Studio oder in der Google Cloud Console und richten Sie Ihre Umgebung ein.
Weitere Informationen zu Schlüsseltypen, Sicherheit und zur Konfiguration Ihres Schlüssels in Python, JavaScript und anderen Sprachen finden Sie unter Gemini API-Schlüssel verwenden.
Erste Schritte
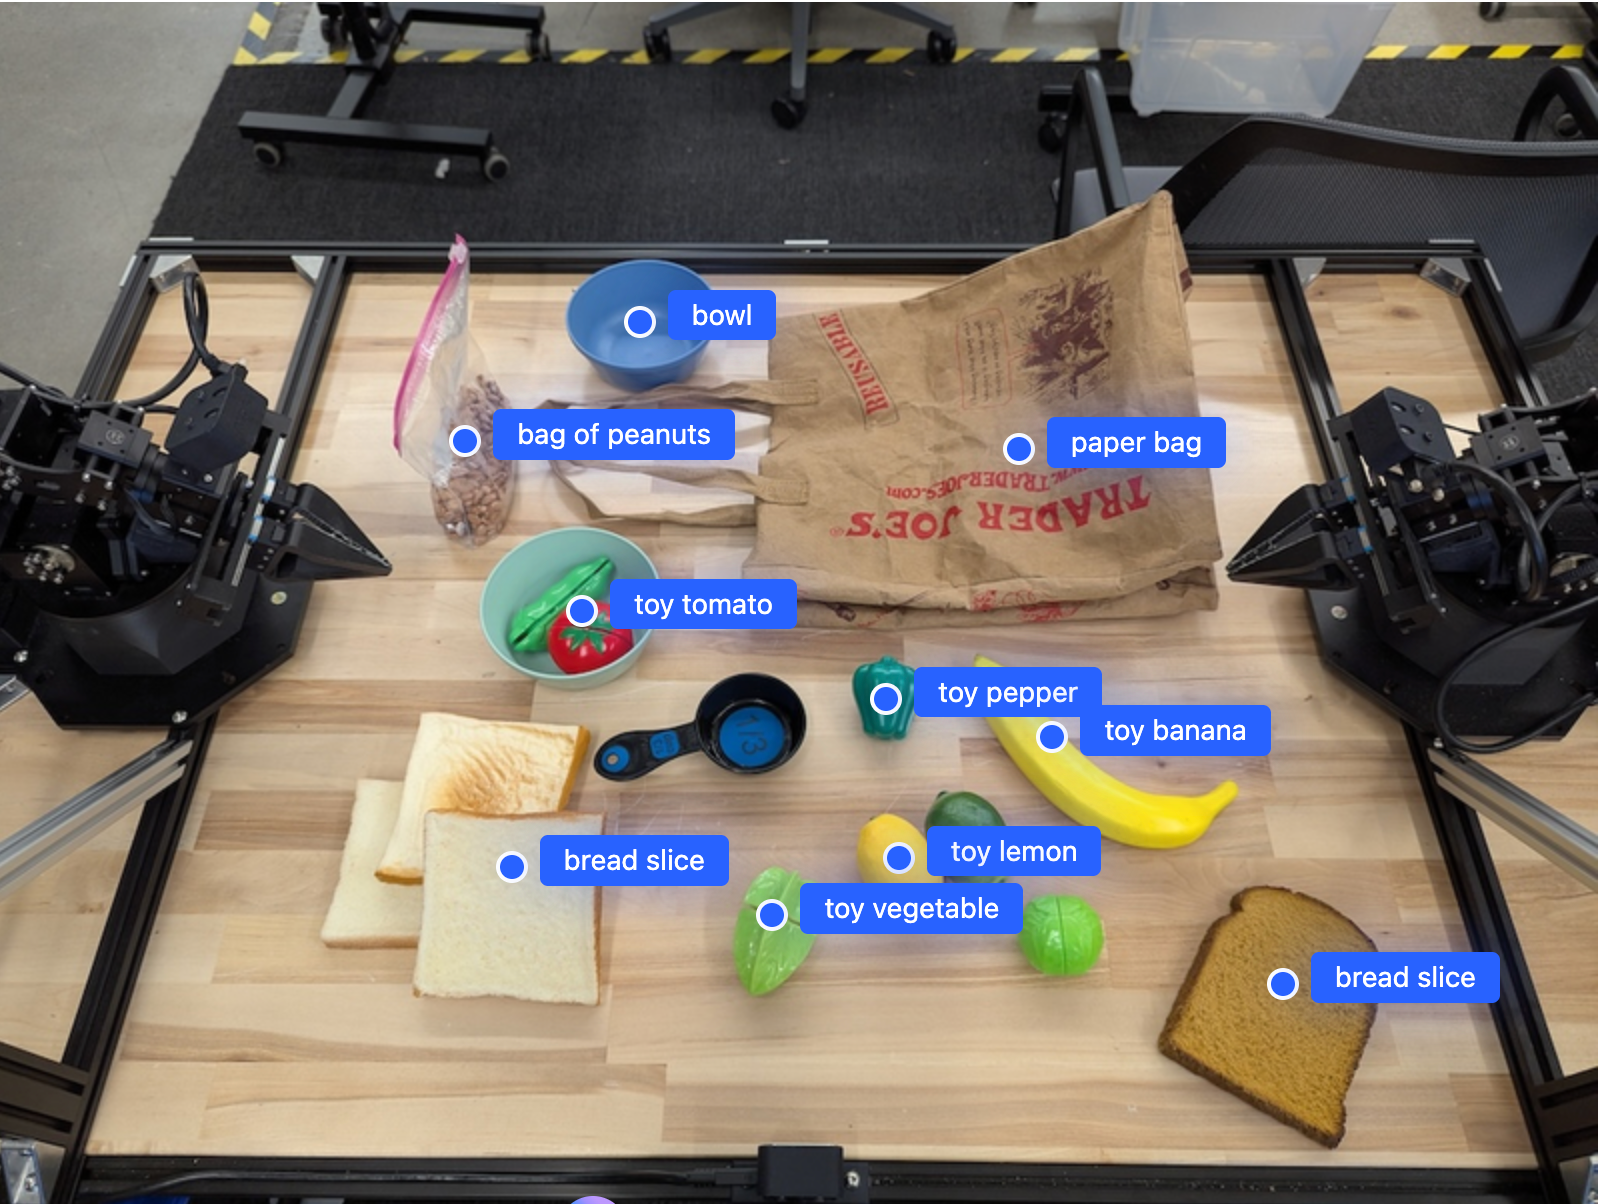
Im folgenden Beispiel werden Objekte in einem Bild gefunden und ihre normalisierten 2D-Koordinaten und Labels zurückgegeben. Sie können diese Ausgabe direkt an eine Robotik-API oder ein VLA-Modell übergeben, um Roboteraktionen zu generieren.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
Die Ausgabe ist ein JSON-Array mit Objekten, die jeweils einen point (normalisierte [y, x]-Koordinaten) und eine label zur Identifizierung des Objekts enthalten.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Die folgende Abbildung zeigt ein Beispiel dafür, wie diese Punkte dargestellt werden können:
Funktionsweise
Gemini Robotics ER akzeptiert Bild-, Video- oder Audioeingaben mit Prompts in natürlicher Sprache. Es identifiziert Objekte, zieht Schlussfolgerungen zum Szenenkontext und zu räumlichen Beziehungen und gibt strukturierte Ausgaben wie Koordinaten oder Begrenzungsrahmen zurück.
Gemini Robotics ER ist auch agentisch: Es zerlegt komplexe Aufgaben in Unteraufgaben und führt sie aus, indem es Ihre Roboterfunktionen aufruft oder generierten Code ausführt. Beispiel: „Lege den Apfel in die Schüssel“ wird zu einer Abfolge von Schritten zum Suchen, Greifen und Platzieren.
Weitere Informationen dazu, wie Gemini Toolaufrufe ausführt, finden Sie unter Funktionsaufrufe.
Sicherheit
Obwohl Gemini Robotics ER mit Blick auf die Sicherheit entwickelt wurde, liegt es in Ihrer Verantwortung, für eine sichere Umgebung um den Roboter herum zu sorgen. Generative KI-Modelle können Fehler machen und physische Roboter können Schäden verursachen. Weitere Informationen finden Sie auf der Seite zur Sicherheit von Gemini Robotics.
Best Practices
Verwenden Sie eine einfache, natürliche Sprache. Beschreiben Sie, was der Roboter tun soll, so, wie Sie es einer Person erklären würden. Wenn ein Begriff nicht funktioniert, versuchen Sie es mit einem gängigen Synonym.
Visuelle Eingaben optimieren Schneiden Sie kleine oder unklare Objekte aus oder zoomen Sie heran, bevor Sie das Bild senden. Die Beleuchtung und ein geringer Farbkontrast können die Erkennung beeinträchtigen.
Teilen Sie komplexe Aufgaben in Schritte auf. Senden Sie jeden Schritt als separaten Prompt, damit das Modell fokussiert bleibt und die Genauigkeit verbessert wird.
Führen Sie bei Aufgaben, die eine hohe Präzision erfordern, mehrere Abfragen durch und bilden Sie den Durchschnitt der Ergebnisse. Dieser Konsensansatz reduziert die Varianz bei räumlichen Ausgaben.
Beschränkungen
Beachten Sie bei der Entwicklung mit Gemini Robotics ER die folgenden Einschränkungen:
- Einschränkungen für API-Schlüssel: Die Gemini API akzeptiert keine Anfragen von uneingeschränkten API-Schlüsseln und gibt einen
403 Forbidden-Fehler zurück. Sichern Sie Ihren API-Schlüssel, indem Sie in AI Studio Einschränkungen hinzufügen. Weitere Informationen finden Sie unter Uneingeschränkte API-Schlüssel sichern. - Latenz im Vergleich zur Leistung: Komplexe Abfragen, hochauflösende Eingaben oder hohe Denkebenen können zu längeren Verarbeitungszeiten führen. Verwenden Sie für die Denkstufe „Mittel“, um ein ausgewogenes Verhältnis zwischen Latenz und Leistung zu erzielen.
- Halluzinationen: Wie alle Large Language Models können auch die ER-Modelle von Gemini Robotics gelegentlich „halluzinieren“ oder falsche Informationen liefern, insbesondere bei mehrdeutigen Prompts oder Eingaben, die nicht in den Trainingsdaten enthalten sind.
- Abhängigkeit von der Prompt-Qualität: Die Qualität der Ausgabe hängt von der Klarheit des Eingabe-Prompts ab. Verwenden Sie spezifische, gut strukturierte Prompts.
- Rechenkosten: Das Ausführen des Modells, insbesondere mit Videoeingaben oder einem hohen
thinking_budget-Wert, verbraucht Rechenressourcen und verursacht Kosten. Weitere Informationen finden Sie auf der Seite Thinking. - Eingabetypen: In den folgenden Themen finden Sie Details zu den Einschränkungen für die einzelnen Modi.
Datenschutzhinweise
Sie erkennen an, dass die in diesem Dokument genannten Modelle (die „Robotermodelle“) Video- und Audiodaten nutzen, um Ihre Hardware gemäß Ihren Anweisungen zu betreiben und zu bewegen. Sie können die Robotikmodelle daher so betreiben, dass Daten von identifizierbaren Personen, z. B. Sprach-, Bild- und Ähnlichkeitsdaten („personenbezogene Daten“), von den Robotikmodellen erhoben werden. Wenn Sie die Robotikmodelle so betreiben, dass personenbezogene Daten erhoben werden, verpflichten Sie sich, identifizierbaren Personen nicht zu erlauben, mit den Robotikmodellen zu interagieren oder sich in deren Nähe aufzuhalten, es sei denn, diese identifizierbaren Personen wurden ausreichend darüber informiert und haben eingewilligt, dass ihre personenbezogenen Daten gemäß den Zusatzbedingungen für die Gemini API unter https://ai.google.dev/gemini-api/terms (die „Bedingungen“) an Google weitergegeben und von Google verwendet werden dürfen, einschließlich gemäß dem Abschnitt „Wie Google Ihre Daten verwendet“. Sie müssen dafür sorgen, dass diese Mitteilung die Erhebung und Verwendung personenbezogener Daten gemäß den Nutzungsbedingungen zulässt. Außerdem müssen Sie sich in wirtschaftlich angemessener Weise bemühen, die Erhebung und Weitergabe personenbezogener Daten zu minimieren, indem Sie Techniken wie die Unkenntlichmachung von Gesichtern verwenden und die Robotermodelle nach Möglichkeit in Bereichen betreiben, in denen sich keine identifizierbaren Personen befinden.
Preise
Ausführliche Informationen zu Preisen und verfügbaren Regionen finden Sie auf der Preisseite.
Modellendpunkte
Gemini Robotics ER 2 (Vorabversion)
| Attribut | Beschreibung |
|---|---|
| -Modellcode | gemini-robotics-er-2-preview |
| Unterstützte Datentypen |
Eingaben Text, Bilder, Video, Audio Ausgabe Text |
| Token limits[*] |
Tokeneingabelimit 131.072 Tokenausgabelimit 65.536 |
| Funktionen | Nicht unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Nicht unterstützt Nicht unterstützt Unterstützt Unterstützt Unterstützt Unterstützt |
| Nutzungsoptionen |
Unterstützt Nicht unterstützt Nicht unterstützt |
| Versionen |
|
| Letzte Aktualisierung | Juli 2026 |
| Modellkarte | Modellkarte |
Gemini Robotics ER 2 Streaming (Vorabversion)
| Attribut | Beschreibung |
|---|---|
| -Modellcode | gemini-robotics-er-2-streaming-preview |
| Unterstützte Datentypen |
Eingaben Text, Bilder, Video, Audio Ausgabe Text |
| Token limits[*] |
Tokeneingabelimit 131.072 Tokenausgabelimit 65.536 |
| Funktionen | Nicht unterstützt Nicht unterstützt Nicht unterstützt Nicht unterstützt Nicht unterstützt Unterstützt Nicht unterstützt Nicht unterstützt Unterstützt Unterstützt Nicht unterstützt Unterstützt Nicht unterstützt |
| Nutzungsoptionen |
Nicht unterstützt Nicht unterstützt Nicht unterstützt |
| Versionen |
|
| Letzte Aktualisierung | Juli 2026 |
| Modellkarte | Modellkarte |
Gemini Robotics ER 1.6 (Vorabversion)
| Attribut | Beschreibung |
|---|---|
| -Modellcode | gemini-robotics-er-1.6-preview |
| Unterstützte Datentypen |
Eingaben Text, Bilder, Video, Audio Ausgabe Text |
| Token limits[*] |
Tokeneingabelimit 131.072 Tokenausgabelimit 65.536 |
| Funktionen | Nicht unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Unterstützt Nicht unterstützt Nicht unterstützt Unterstützt Unterstützt Unterstützt Unterstützt |
| Nutzungsoptionen |
Unterstützt Nicht unterstützt Nicht unterstützt |
| Versionen |
|
| Letzte Aktualisierung | Dezember 2025 |
| Wissensstichtag | Januar 2025 |
Nächste Schritte
- Räumliches Denken: Zeigen, Tracking, Begrenzungsrahmen, Trajektorien.
- Agentische Funktionen: Code-Ausführung, Instrumentenablesung, Bildannotation.
- Aufgabenorchestrierung: Langfristige Aufgaben mit benutzerdefinierten Roboter-APIs.
- Robotics mit Streaming: Bidirektionales Streaming in Echtzeit (nur Gemini Robotics ER 2).
- Videoverständnis: Momentfindung und Fortschrittsklassifizierung (nur Gemini Robotics ER 2).
- Gemini Robotics-Sicherheit: Sicherheitsforschung hinter der Modellfamilie.