

Gemini Robotics ER (एम्बॉडेड रीज़निंग) मॉडल, विज़न-लैंग्वेज मॉडल (वीएलएम) हैं. इनकी मदद से, रोबोट असल दुनिया को समझ सकते हैं और उससे इंटरैक्ट कर सकते हैं. ये विज़ुअल डेटा को समझते हैं, स्पेस और समय के हिसाब से तर्क करते हैं, कई चरणों वाले टास्क प्लान करते हैं, और रोबोट और टूल को मैनेज करते हैं.
मॉडल
Gemini Robotics ER 2 मॉडल, Gemini Robotics का सबसे नया मॉडल है. यह गहराई से विश्लेषण करने वाला हमारा अपडेट किया गया मॉडल है. इसकी मदद से, रोबोट अपने आस-पास के माहौल को सटीक तरीके से समझ पाते हैं. यह एम्बॉडेड रीज़निंग की क्षमताओं में माहिर है.जैसे, रोबोट का एजेंटिक ऑर्केस्ट्रेशन (जैसे, वीएलए का इस्तेमाल करना), रोबोट वीडियो को समझना. इसमें प्रोग्रेस को समझना और सफलता का पता लगाना, इंस्ट्रुमेंट रीडिंग, पॉइंटिंग, और स्पेशल रीज़निंग शामिल है.
Gemini Robotics ER 2 मॉडल में दो मॉडल एंडपॉइंट शामिल हैं:
gemini-robotics-er-2-preview: स्टैंडर्ड ER 2 मॉडल. यह Gemini 3.5 Flash पर आधारित है. इसमें कई चीज़ें बेहतर की गई हैं. जैसे, स्पेशल रीज़निंग, वीडियो में किसी खास पल को ढूंढना, वीडियो की प्रोग्रेस को कैटगरी में बांटना, कई रोबोट को एक साथ मैनेज करना, और कई चरणों वाले टूल का इस्तेमाल करना.gemini-robotics-er-2-streaming-preview: Live API का इस्तेमाल करके, रीयल-टाइम स्ट्रीमिंग के लिए ऑप्टिमाइज़ किया गया है. इस मॉडल का इस्तेमाल, कम इंतज़ार के समय वाले रोबोट एजेंट के लिए करें. ये एजेंट, लगातार ऑडियो और वीडियो इनपुट को प्रोसेस करते हैं.
Gemini Robotics ER 1.6 को 31 अगस्त, 2026 को बंद कर दिया गया था.
अगर अब भी Gemini Robotics ER 1.6 का इस्तेमाल किया जा रहा है, तो Gemini Robotics ER 2 पर अपग्रेड करें. इसके लिए, अपने एपीआई कॉल में model="gemini-robotics-er-1.6-preview" को model="gemini-robotics-er-2-preview" या model="gemini-robotics-er-2-streaming-preview" से बदलें.
Google AI Studio में Gemini Robotics ER 2 को आज़माना
रोबोटिक्स की क्षमताएं
Gemini Robotics ER, एम्बॉडेड रीज़निंग की कई क्षमताओं के साथ काम करता है. ज़्यादा जानने के लिए, कोई सुविधा चुनें:
| अनुमति | ब्यौरा | गाइड |
|---|---|---|
| स्पेशल रीज़निंग | ऑब्जेक्ट की पहचान करना, वीडियो में उन्हें ट्रैक करना, बाउंडिंग बॉक्स की मदद से उनका पता लगाना, और उनके मूवमेंट का अनुमान लगाना. | स्पेशल रीज़निंग |
| एजेंटिक विज़न | इमेज में बदलाव करने वाले टूल का इस्तेमाल करके, अन्य सुविधाओं को बेहतर बनाने के लिए कोड एक्ज़ीक्यूशन का इस्तेमाल करें. | एजेंटिक विज़न |
| टास्क ऑर्केस्ट्रेशन | स्पेशल रीज़निंग को कस्टम रोबोट एपीआई के साथ जोड़कर, लंबे समय तक चलने वाले टास्क पूरे करें. | टास्क ऑर्केस्ट्रेशन |
| स्ट्रीमिंग (सिर्फ़ Gemini Robotics ER 2 स्ट्रीमिंग एंडपॉइंट के लिए) | रीयल-टाइम रोबोट एजेंट के लिए, दोनों तरफ़ से स्ट्रीमिंग की सुविधा. इसमें कम इंतज़ार के समय वाली फ़ंक्शन कॉलिंग की सुविधा भी शामिल है. | रोबोटिक्स के लिए स्ट्रीमिंग |
| वीडियो की प्रोग्रेस (सिर्फ़ Gemini Robotics ER 2 के लिए) | लगातार वीडियो फ़ीड से, खास पल ढूंढने और प्रोग्रेस को कैटगरी में बांटने की सुविधा. | वीडियो को समझना |
शुरू करने से पहले
Gemini Robotics ER मॉडल, Gemini Developer API के ज़रिए उपलब्ध हैं. शुरू करने के लिए, Google AI Studio या Google Cloud console में जाकर, Gemini API पासकोड बनाएं. इसके बाद, अपना एनवायरमेंट सेट अप करें.
पासकोड के टाइप, सुरक्षा, और Python, JavaScript, और अन्य भाषाओं में पासकोड को कॉन्फ़िगर करने के तरीके के बारे में जानने के लिए, Gemini API पासकोड इस्तेमाल करना लेख पढ़ें.
शुरू करना
यहां दिए गए उदाहरण में, किसी इमेज में मौजूद ऑब्जेक्ट का पता लगाया गया है. साथ ही, उनके नॉर्मलाइज़ किए गए 2D कोऑर्डिनेट और लेबल दिखाए गए हैं. इस आउटपुट को सीधे तौर पर रोबोटिक्स एपीआई या वीएलए मॉडल को पास किया जा सकता है, ताकि रोबोट की कार्रवाइयां जनरेट की जा सकें.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
ऐप पर जाएं
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
आराम का समय
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
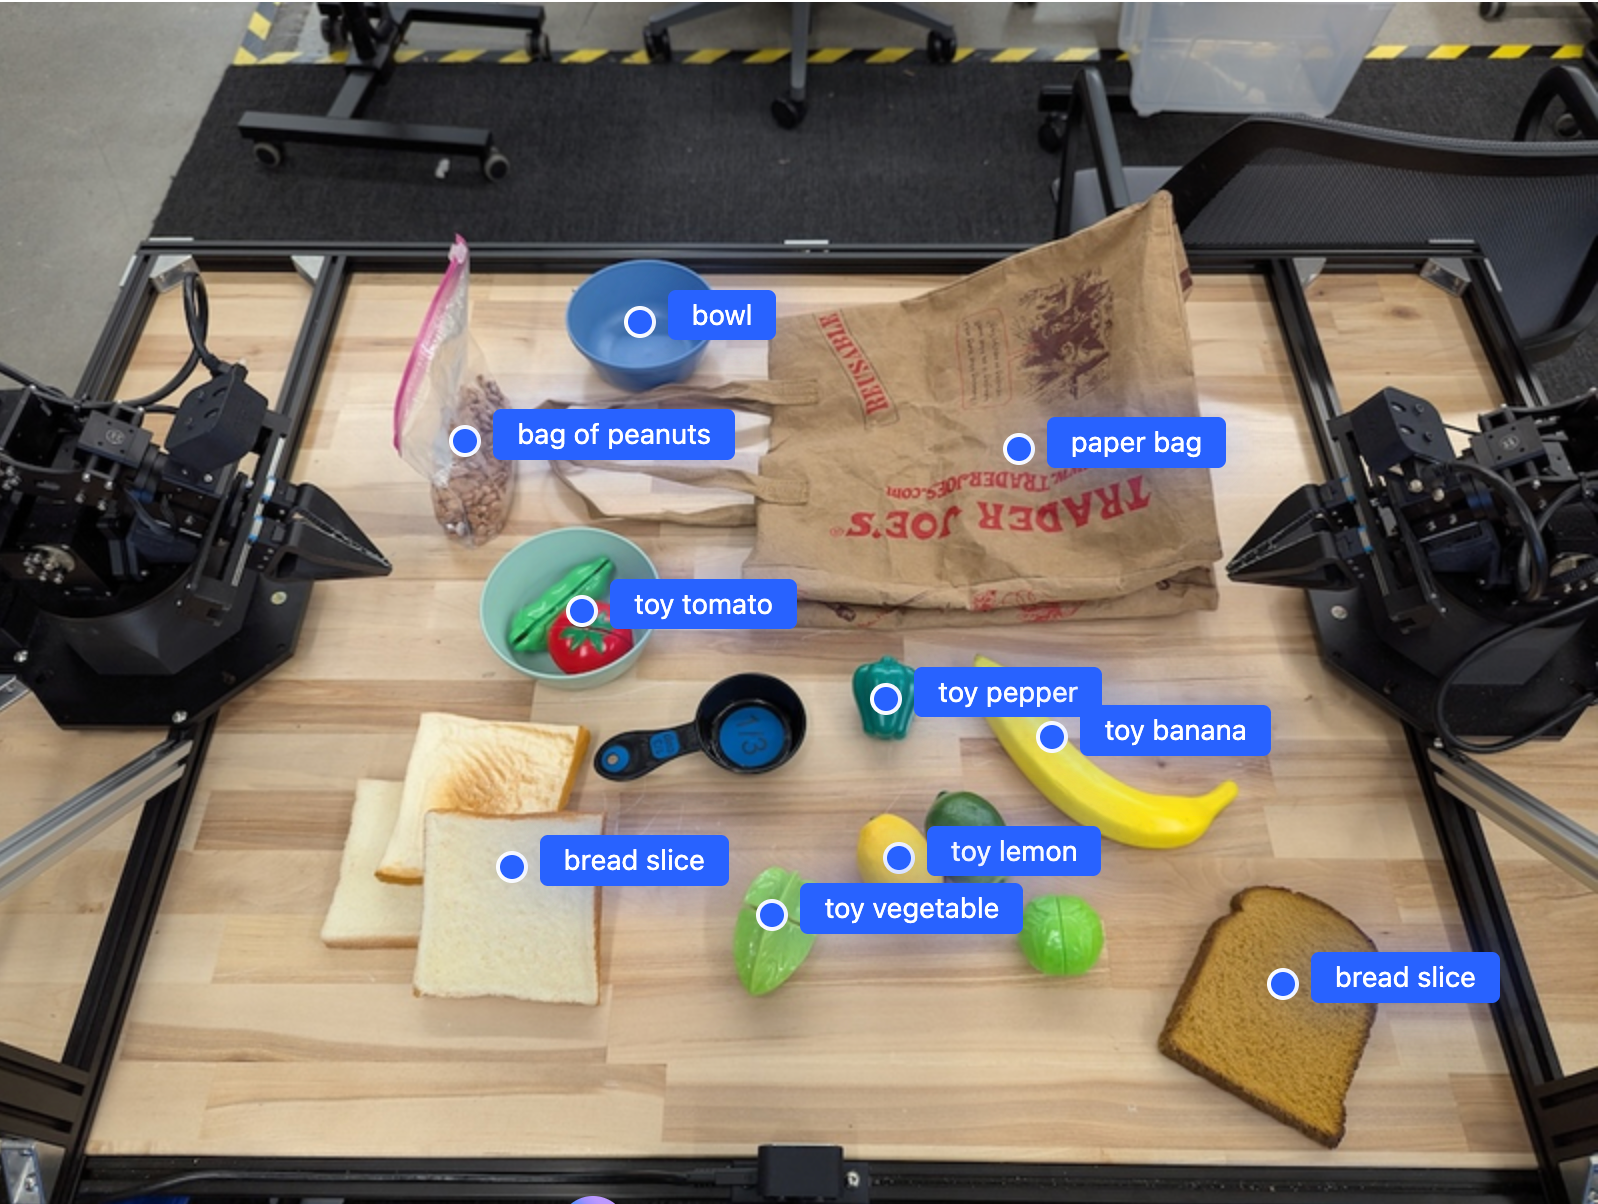
आउटपुट, ऑब्जेक्ट वाली JSON कलेक्शन होगी. हर ऑब्जेक्ट में एक point (सामान्य [y, x] निर्देशांक) और ऑब्जेक्ट की पहचान करने वाला label होगा.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
यहां दी गई इमेज में, इन पॉइंट को दिखाने का उदाहरण दिया गया है:
यह कैसे काम करता है
Gemini Robotics ER, नैचुरल लैंग्वेज प्रॉम्प्ट के साथ इमेज, वीडियो या ऑडियो इनपुट लेता है. यह ऑब्जेक्ट की पहचान करता है, सीन के कॉन्टेक्स्ट और स्पेशल रिलेशनशिप के बारे में बताता है, और स्ट्रक्चर्ड आउटपुट देता है, जैसे कि कोऑर्डिनेट या बाउंडिंग बॉक्स.
Gemini Robotics ER, एजेंट की तरह भी काम करता है: यह मुश्किल टास्क को छोटे-छोटे टास्क में बांटता है और आपके रोबोट के फ़ंक्शन को कॉल करके या जनरेट किए गए कोड को चलाकर उन्हें पूरा करता है. उदाहरण के लिए, "सेब को कटोरे में रखो" निर्देश को पूरा करने के लिए, रोबोट को सेब को ढूंढना, उसे पकड़ना, और कटोरे में रखना होगा.
Gemini, टूल कॉल कैसे करता है, इस बारे में जानने के लिए फ़ंक्शन कॉलिंग देखें.
सुरक्षा
Gemini Robotics ER को सुरक्षा को ध्यान में रखकर बनाया गया है. हालांकि, रोबोट के आस-पास सुरक्षित माहौल बनाए रखने की ज़िम्मेदारी आपकी है. जनरेटिव एआई मॉडल से गलतियां हो सकती हैं. साथ ही, फ़िज़िकल रोबोट से नुकसान हो सकता है. ज़्यादा जानने के लिए, Gemini Robotics के सुरक्षा पेज पर जाएं.
सबसे सही तरीके
आसान और नैचुरल लैंग्वेज का इस्तेमाल करें. रोबोट को वैसे ही निर्देश दें जैसे किसी व्यक्ति को देते हैं. अगर कोई शब्द काम नहीं कर रहा है, तो उसका कोई सामान्य समानार्थी शब्द इस्तेमाल करके देखें.
विज़ुअल इनपुट को ऑप्टिमाइज़ करना. इमेज भेजने से पहले, छोटे या धुंधले ऑब्जेक्ट को क्रॉप या ज़ूम करें. रोशनी और कम कलर कंट्रास्ट की वजह से, इंसान की मौजूदगी का पता लगाने की सुविधा पर असर पड़ सकता है.
मुश्किल टास्क को छोटे-छोटे हिस्सों में बांटें. हर चरण को अलग-अलग प्रॉम्प्ट के तौर पर भेजें, ताकि मॉडल का फ़ोकस बना रहे और वह सटीक जवाब दे सके.
ज़्यादा सटीक नतीजे पाने के लिए, कई बार क्वेरी करें और नतीजों का औसत निकालें. इस तरीके से, अलग-अलग जगहों पर वायु प्रदूषण की मात्रा के अनुमान में होने वाले अंतर को कम किया जा सकता है.
सीमाएं
Gemini Robotics ER की मदद से डेवलप करते समय, इन सीमाओं का ध्यान रखें:
- एपीआई पासकोड से जुड़ी पाबंदियां: Gemini API, बिना पाबंदी वाले एपीआई पासकोड से किए गए अनुरोध स्वीकार नहीं करता. साथ ही,
403 Forbiddenगड़बड़ी दिखाता है. AI Studio में पाबंदियां जोड़कर, अपने एपीआई पासकोड को सुरक्षित करें. ज़्यादा जानकारी के लिए, बिना पाबंदी वाले एपीआई पासकोड सुरक्षित करना लेख पढ़ें. - लेटेंसी बनाम परफ़ॉर्मेंस: मुश्किल क्वेरी, हाई रिज़ॉल्यूशन वाले इनपुट या ज़्यादा सोच-विचार करने की वजह से, प्रोसेसिंग में ज़्यादा समय लग सकता है. सोच-विचार करके जवाब देने के लेवल के लिए, मीडियम का इस्तेमाल करें. इससे इंतज़ार के समय और परफ़ॉर्मेंस के बीच अच्छा संतुलन बना रहता है.
- गलत जानकारी: सभी लार्ज लैंग्वेज मॉडल की तरह, Gemini Robotics ER मॉडल भी कभी-कभी "गलत जानकारी" दे सकते हैं. ऐसा खास तौर पर, साफ़ तौर पर न दिए गए प्रॉम्प्ट या आउट-ऑफ़-डिस्ट्रिब्यूशन इनपुट के लिए हो सकता है.
- प्रॉम्प्ट की क्वालिटी पर निर्भरता: आउटपुट की क्वालिटी, इनपुट प्रॉम्प्ट की क्वालिटी पर निर्भर करती है. सटीक और अच्छी तरह से स्ट्रक्चर किए गए प्रॉम्प्ट इस्तेमाल करें.
- कंप्यूटेशनल लागत: मॉडल को चलाने के लिए कंप्यूटेशनल संसाधनों की ज़रूरत होती है और लागत आती है. खास तौर पर, वीडियो इनपुट या ज़्यादा
thinking_budgetके साथ मॉडल को चलाने पर. ज़्यादा जानकारी के लिए, सोचने की क्षमता पेज देखें. - इनपुट टाइप: हर मोड की सीमाओं के बारे में जानने के लिए, यहां दिए गए विषय देखें.
निजता नोटिस
आप इस बात से सहमत हैं कि इस दस्तावेज़ में बताए गए मॉडल ("रोबोटिक्स मॉडल"), आपके निर्देशों के मुताबिक आपके हार्डवेयर को चलाने और उसे मूव करने के लिए, वीडियो और ऑडियो डेटा का इस्तेमाल करते हैं. इसलिए, हो सकता है कि आप रोबोटिक्स मॉडल को इस तरह से इस्तेमाल करें कि वे पहचाने जा सकने वाले लोगों का डेटा इकट्ठा करें. जैसे, आवाज़, इमेज, और मिलती-जुलती जानकारी ("निजी डेटा"). अगर आपको रोबोटिक्स मॉडल का इस्तेमाल इस तरह करना है कि निजी डेटा इकट्ठा हो, तो आपको इस बात से सहमत होना होगा कि आप किसी भी ऐसे व्यक्ति को रोबोटिक्स मॉडल के साथ इंटरैक्ट करने या उसके आस-पास मौजूद रहने की अनुमति नहीं देंगे जिसकी पहचान की जा सकती है. हालांकि, अगर ऐसे व्यक्ति को इस बात की सूचना दी गई है और उसने सहमति दी है कि उसका निजी डेटा, Google को दिया जा सकता है और Google उसका इस्तेमाल कर सकता है, तो उसे अनुमति दी जा सकती है. इस बारे में, Gemini API की सेवा की अतिरिक्त शर्तों में बताया गया है. ये शर्तें, https://ai.google.dev/gemini-api/terms ("शर्तें") पर देखी जा सकती हैं. इनमें "Google आपके डेटा का इस्तेमाल कैसे करता है" सेक्शन भी शामिल है. आपको यह पक्का करना होगा कि इस तरह की सूचना में, शर्तों के मुताबिक निजी डेटा को इकट्ठा करने और इस्तेमाल करने की अनुमति दी गई हो. साथ ही, आपको कारोबार के नज़रिए से सही तरीकों का इस्तेमाल करके, निजी डेटा को इकट्ठा और शेयर करने की प्रोसेस को कम से कम करना होगा. इसके लिए, आपको चेहरे को धुंधला करने जैसी तकनीकों का इस्तेमाल करना होगा. इसके अलावा, आपको रोबोटिक्स मॉडल को ऐसी जगहों पर इस्तेमाल करना होगा जहां पहचाने जा सकने वाले लोग मौजूद न हों.
कीमत
शुल्क और Gemini for Google Workspace की उपलब्धता वाले देशों/इलाकों के बारे में ज़्यादा जानकारी के लिए, शुल्क पेज पर जाएं.
मॉडल एंडपॉइंट
Gemini Robotics ER 2 Preview
| प्रॉपर्टी | ब्यौरा |
|---|---|
| मॉडल कोड | gemini-robotics-er-2-preview |
| इस्तेमाल किए जा सकने वाले डेटा टाइप |
इनपुट टेक्स्ट, इमेज, वीडियो, ऑडियो आउटपुट टेक्स्ट |
| टोकन की सीमाएं[*] |
इनपुट टोकन की सीमा 1,31,072 आउटपुट टोकन की सीमा 65,536 |
| सुविधाएं | काम नहीं करता है काम करता है काम करता है काम करता है काम करता है काम करता है काम करता है काम नहीं करता है काम नहीं करता है भरोसेमंद स्रोतों से जानकारी लें काम करता है काम करता है काम करता है काम करता है |
| कॉन्टेंट देखने के विकल्प |
काम करता है काम नहीं करता है काम नहीं करता है |
| वर्शन |
|
| नया अपडेट | जुलाई 2026 |
| मॉडल कार्ड | मॉडल कार्ड |
Gemini Robotics ER 2 स्ट्रीमिंग की झलक
| प्रॉपर्टी | ब्यौरा |
|---|---|
| मॉडल कोड | gemini-robotics-er-2-streaming-preview |
| इस्तेमाल किए जा सकने वाले डेटा टाइप |
इनपुट टेक्स्ट, इमेज, वीडियो, ऑडियो आउटपुट टेक्स्ट |
| टोकन की सीमाएं[*] |
इनपुट टोकन की सीमा 1,31,072 आउटपुट टोकन की सीमा 65,536 |
| सुविधाएं | काम नहीं करता है काम नहीं करता है काम नहीं करता है काम नहीं करता है काम नहीं करता है काम करता है काम नहीं करता है काम नहीं करता है काम करता है भरोसेमंद स्रोतों से जानकारी लें काम करता है काम नहीं करता है काम करता है काम नहीं करता है |
| कॉन्टेंट देखने के विकल्प |
काम नहीं करता है काम नहीं करता है काम नहीं करता है |
| वर्शन |
|
| नया अपडेट | जुलाई 2026 |
| मॉडल कार्ड | मॉडल कार्ड |
Gemini Robotics ER 1.6 Preview
| प्रॉपर्टी | ब्यौरा |
|---|---|
| मॉडल कोड | gemini-robotics-er-1.6-preview |
| इस्तेमाल किए जा सकने वाले डेटा टाइप |
इनपुट टेक्स्ट, इमेज, वीडियो, ऑडियो आउटपुट टेक्स्ट |
| टोकन की सीमाएं[*] |
इनपुट टोकन की सीमा 1,31,072 आउटपुट टोकन की सीमा 65,536 |
| सुविधाएं | काम नहीं करता है काम करता है काम करता है काम करता है काम करता है काम करता है काम करता है काम नहीं करता है काम नहीं करता है भरोसेमंद स्रोतों से जानकारी लें काम करता है काम करता है काम करता है काम करता है |
| कॉन्टेंट देखने के विकल्प |
काम करता है काम नहीं करता है काम नहीं करता है |
| वर्शन |
|
| नया अपडेट | दिसंबर 2025 |
| जानकारी न मिलना | जनवरी 2025 |
आगे क्या करना है
- स्पेशल रीज़निंग — पॉइंट करना, ट्रैक करना, बाउंडिंग बॉक्स, ट्रैजेक्टरी.
- एजेंटिक एआई की सुविधाएं — कोड एक्ज़ीक्यूशन, इंस्ट्रुमेंट रीडिंग, इमेज एनोटेशन.
- टास्क ऑर्केस्ट्रेशन — कस्टम रोबोट एपीआई की मदद से, लंबे समय तक चलने वाले टास्क.
- स्ट्रीमिंग के साथ रोबोटिक्स — रीयल-टाइम में दोनों तरफ़ से स्ट्रीमिंग (सिर्फ़ Gemini Robotics ER 2 के लिए).
- वीडियो को समझना — किसी खास पल को ढूंढना और प्रोग्रेस को कैटगरी में बांटना (सिर्फ़ Gemini Robotics ER 2 के लिए).
- Gemini Robotics की सुरक्षा — इस मॉडल फ़ैमिली के पीछे की सुरक्षा रिसर्च.