

โมเดล Gemini Robotics ER (การให้เหตุผลแบบเป็นรูปธรรม) เป็นโมเดลภาษาภาพ (VLM) ที่ช่วยให้หุ่นยนต์รับรู้และโต้ตอบกับโลกทางกายภาพได้ โดยจะตีความข้อมูลภาพ ทำการให้เหตุผลเชิงพื้นที่และเชิงเวลา วางแผนงานที่มีหลายขั้นตอน และควบคุมหุ่นยนต์และเครื่องมือต่างๆ
โมเดล
โมเดล Gemini Robotics ER 2 เป็นโมเดลล่าสุดใน Gemini Robotics ซึ่งเป็นโมเดลการให้เหตุผลที่อัปเดตแล้วของเราที่ช่วยให้หุ่นยนต์เข้าใจสภาพแวดล้อมได้อย่างแม่นยำ โมเดลนี้เชี่ยวชาญด้านความสามารถในการให้เหตุผลแบบเป็นรูปธรรม เช่น การจัดระเบียบหุ่นยนต์แบบ Agentic (เช่น การใช้ VLA) ความเข้าใจวิดีโอของหุ่นยนต์ รวมถึงความเข้าใจความคืบหน้าและการตรวจจับความสำเร็จ การอ่านเครื่องมือ การชี้ และการให้เหตุผลเชิงพื้นที่
โมเดล Gemini Robotics ER 2 มีปลายทางโมเดล 2 รายการดังนี้
gemini-robotics-er-2-preview: โมเดล ER 2 มาตรฐาน ต่อยอดจาก Gemini 3.5 Flash ด้วยการปรับปรุงการให้เหตุผลเชิงพื้นที่ การค้นหาช่วงเวลาในวิดีโอ การจัดประเภทความคืบหน้าของวิดีโอ การจัดระเบียบหุ่นยนต์หลายตัว และการใช้เครื่องมือแบบหลายขั้นตอนgemini-robotics-er-2-streaming-preview: เพิ่มประสิทธิภาพสำหรับการสตรีมแบบเรียลไทม์โดยใช้ Live API ใช้โมเดลนี้สำหรับเอเจนต์หุ่นยนต์ที่มีเวลาในการตอบสนองต่ำซึ่งประมวลผลอินพุตเสียงและวิดีโออย่างต่อเนื่อง
Gemini Robotics ER 1.6 เลิกใช้งานแล้วเมื่อวันที่ 31 สิงหาคม 2026
หากคุณยังใช้ Gemini Robotics ER 1.6 อยู่ ให้อัปเกรดเป็น Gemini Robotics ER 2 โดยแทนที่ model="gemini-robotics-er-1.6-preview" ด้วย model="gemini-robotics-er-2-preview" หรือ model="gemini-robotics-er-2-streaming-preview" ในการเรียก API
ลองใช้ Gemini Robotics ER 2 ใน Google AI Studio
ความสามารถด้านวิทยาการหุ่นยนต์
Gemini Robotics ER รองรับความสามารถในการให้เหตุผลแบบเป็นรูปธรรมที่หลากหลาย เลือกความสามารถเพื่อดูข้อมูลเพิ่มเติม
| ความสามารถ | คำอธิบาย | คู่มือ |
|---|---|---|
| การให้เหตุผลเชิงพื้นที่ | ชี้ไปที่วัตถุ ติดตามวัตถุในวิดีโอ ตรวจจับด้วยกรอบล้อมรอบ วางแผนวิถีการเคลื่อนที่ | การให้เหตุผลเชิงพื้นที่ |
| วิสัยทัศน์เกี่ยวกับ Agentic AI | ใช้การเรียกใช้โค้ดเพื่อเพิ่มประสิทธิภาพความสามารถอื่นๆ โดยใช้เครื่องมือจัดการรูปภาพ | วิสัยทัศน์ของ Agentic |
| การจัดการงาน | รวมการให้เหตุผลเชิงพื้นที่เข้ากับ API ของหุ่นยนต์ที่กำหนดเองเพื่อทำงานระยะยาวให้เสร็จสมบูรณ์ | การเรียบเรียงงาน |
| สตรีมมิง (ปลายทางสตรีมมิง Gemini Robotics ER 2 เท่านั้น) | การสตรีมแบบ 2 ทิศทางสำหรับเอเจนต์หุ่นยนต์แบบเรียลไทม์ที่มีการเรียกใช้ฟังก์ชันเวลาในการตอบสนองต่ำ | สตรีมมิงสำหรับหุ่นยนต์ |
| ความคืบหน้าของวิดีโอ (Gemini Robotics ER 2 เท่านั้น) | การค้นหาช่วงเวลาและการแยกประเภทความคืบหน้าจากฟีดวิดีโอต่อเนื่อง | ความเข้าใจวิดีโอ |
ก่อนเริ่มต้น
โมเดล ER ของ Gemini Robotics พร้อมให้บริการผ่าน Gemini Developer API หากต้องการเริ่มต้นใช้งาน ให้สร้างคีย์ Gemini API จาก Google AI Studio หรือคอนโซล Google Cloud แล้วตั้งค่าสภาพแวดล้อม
ดูรายละเอียดเกี่ยวกับประเภทคีย์ ความปลอดภัย และวิธีกำหนดค่าคีย์ใน Python, JavaScript และภาษาอื่นๆ ได้ที่หัวข้อการใช้คีย์ Gemini API
เริ่มต้นใช้งาน
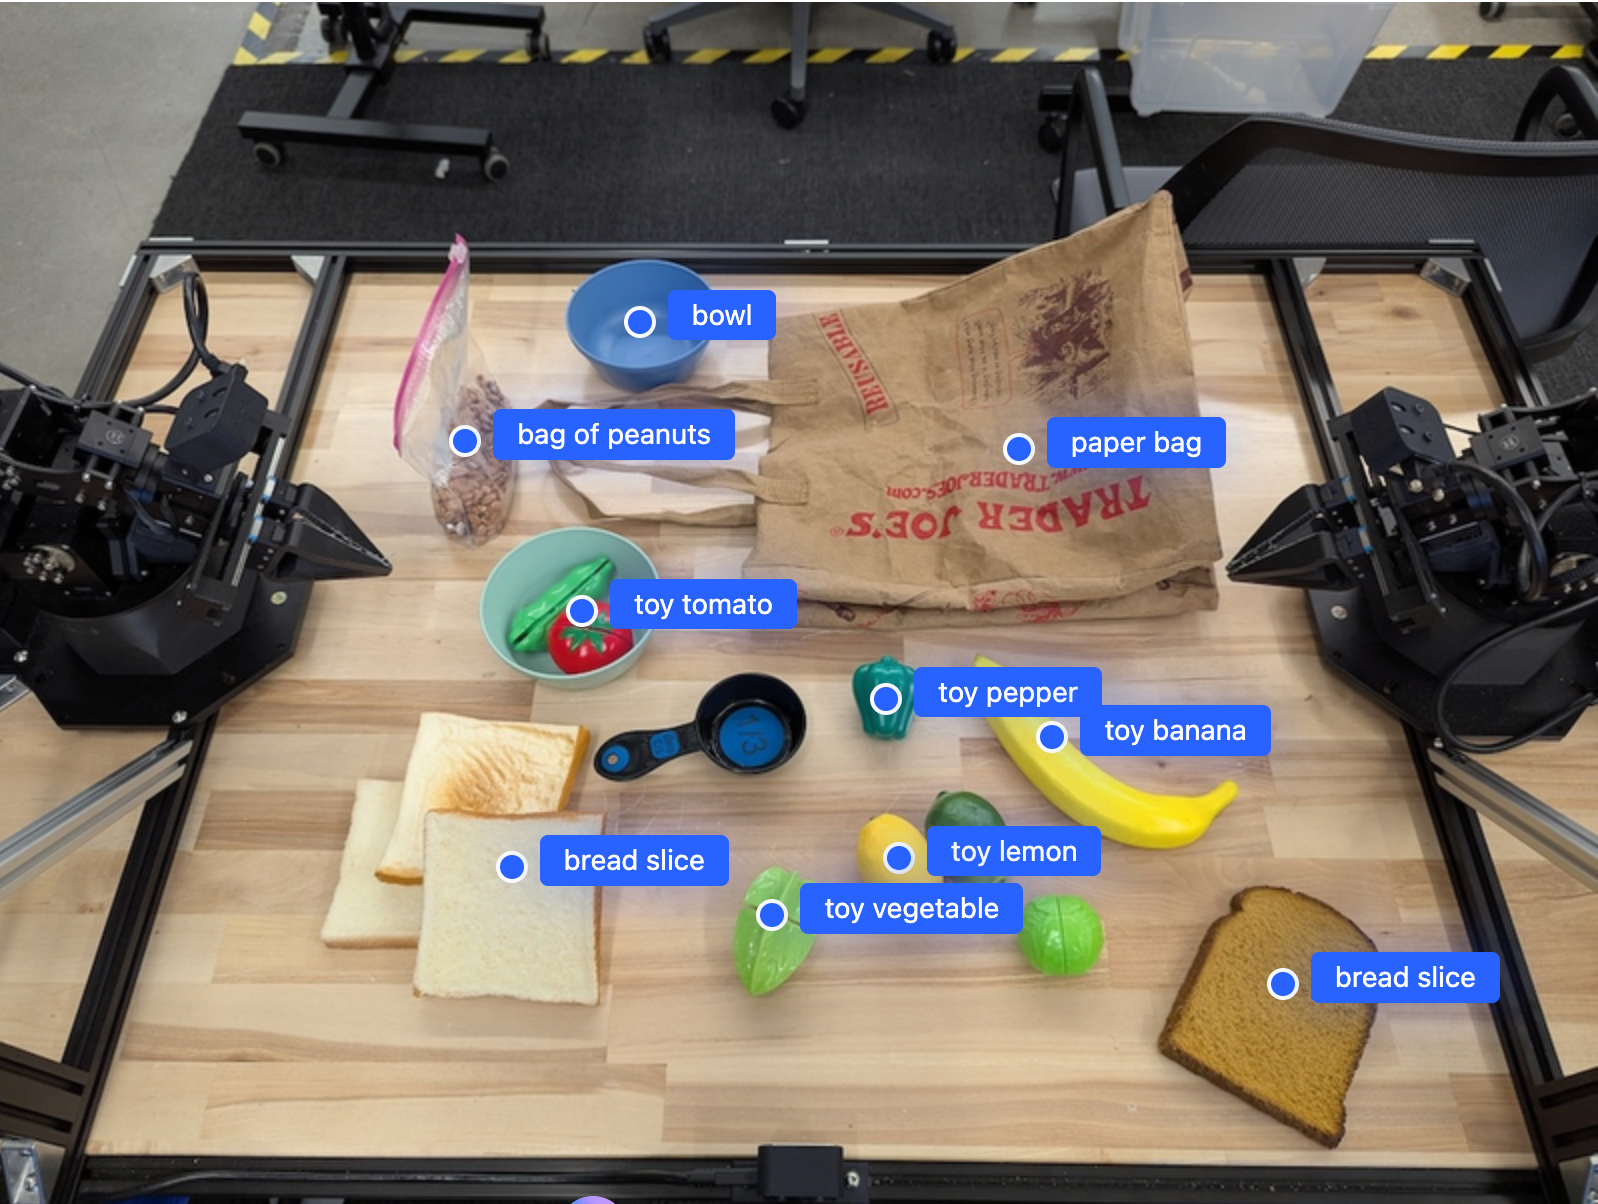
ตัวอย่างต่อไปนี้จะค้นหาวัตถุในรูปภาพและแสดงผลพิกัดและป้ายกำกับ 2 มิติที่ปรับมาตรฐานแล้ว คุณสามารถส่งเอาต์พุตนี้ไปยัง API หุ่นยนต์หรือโมเดล VLA โดยตรงเพื่อสร้างการทำงานของหุ่นยนต์
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
เอาต์พุตจะเป็นอาร์เรย์ JSON ที่มีออบเจ็กต์ โดยแต่ละออบเจ็กต์จะมี point (พิกัด [y, x] ที่ปรับมาตรฐานแล้ว) และ label ที่ระบุออบเจ็กต์
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
รูปภาพต่อไปนี้เป็นตัวอย่างวิธีแสดงคะแนนเหล่านี้
วิธีการทำงาน
Gemini Robotics ER รับอินพุตรูปภาพ วิดีโอ หรือเสียงด้วยพรอมต์ภาษาธรรมชาติ โดยจะระบุวัตถุ พิจารณาบริบทของฉากและความสัมพันธ์เชิงพื้นที่ และแสดงผลลัพธ์ที่มีโครงสร้าง เช่น พิกัดหรือกรอบล้อมรอบ
Gemini Robotics ER ยังเป็นแบบ Agentic ด้วย โดยจะแบ่งงานที่ซับซ้อนออกเป็นงานย่อยๆ และดำเนินการโดยเรียกใช้ฟังก์ชันหุ่นยนต์หรือเรียกใช้โค้ดที่สร้างขึ้น ตัวอย่างเช่น "วางแอปเปิลลงในชาม" จะกลายเป็นลำดับขั้นตอนการค้นหา การหยิบ และการวาง
ดูรายละเอียดเกี่ยวกับวิธีที่ Gemini เรียกใช้เครื่องมือได้ที่การเรียกใช้ฟังก์ชัน
ความปลอดภัย
แม้ว่า Gemini Robotics ER จะสร้างขึ้นโดยคำนึงถึงความปลอดภัย แต่คุณก็มีหน้าที่รับผิดชอบในการรักษาสภาพแวดล้อมที่ปลอดภัยรอบๆ หุ่นยนต์ โมเดล Generative AI อาจทำงานผิดพลาดได้ และหุ่นยนต์จริงอาจก่อให้เกิดความเสียหาย ดูข้อมูลเพิ่มเติมได้ที่หน้าความปลอดภัยของ Gemini Robotics
แนวทางปฏิบัติแนะนำ
ใช้ภาษาธรรมชาติที่เรียบง่าย อธิบายสิ่งที่คุณต้องการให้หุ่นยนต์ทำเหมือนกับที่คุณอธิบายให้คนฟัง หากคำใดใช้ไม่ได้ผล ให้ลองใช้คำพ้องความหมายที่ใช้กันทั่วไป
เพิ่มประสิทธิภาพอินพุตภาพ ครอบตัดหรือซูมวัตถุขนาดเล็กหรือไม่ชัดเจนก่อนส่งรูปภาพ แสงและคอนทราสต์ของสีที่ต่ำอาจส่งผลต่อการตรวจจับ
แบ่งงานที่ซับซ้อนออกเป็นขั้นตอนต่างๆ ส่งแต่ละขั้นตอนเป็นพรอมต์แยกกันเพื่อให้โมเดลโฟกัสและปรับปรุงความแม่นยำ
ค้นหาหลายครั้งและหาค่าเฉลี่ยของผลลัพธ์สำหรับงานที่ต้องการความแม่นยำสูง วิธีการที่ใช้ฉันทามตินี้จะช่วยลดความแปรปรวนของเอาต์พุตเชิงพื้นที่
ข้อจำกัด
โปรดคำนึงถึงข้อจำกัดต่อไปนี้เมื่อพัฒนาด้วย Gemini Robotics ER
- ข้อจำกัดของคีย์ API: Gemini API ไม่ยอมรับคำขอจากคีย์ API ที่ไม่จำกัด และจะแสดงข้อผิดพลาด
403 Forbiddenรักษาความปลอดภัยของคีย์ API โดยเพิ่มข้อจำกัดใน AI Studio ดูรายละเอียดได้ที่รักษาความปลอดภัยคีย์ API ที่ไม่มีการจำกัด - เวลาในการตอบสนองเทียบกับประสิทธิภาพ: คำถามที่ซับซ้อน ข้อมูลที่ป้อนที่มีความละเอียดสูง หรือระดับการคิดที่สูงอาจทำให้ใช้เวลาประมวลผลนานขึ้น สำหรับระดับการคิด ให้ใช้ระดับปานกลางเพื่อความสมดุลที่ดีระหว่างเวลาในการตอบสนองและประสิทธิภาพ
- อาการหลอน: โมเดล ER ของ Gemini Robotics อาจ "หลอน" หรือให้ข้อมูลที่ไม่ถูกต้องเป็นครั้งคราว เช่นเดียวกับโมเดลภาษาขนาดใหญ่ทั้งหมด โดยเฉพาะอย่างยิ่งสำหรับพรอมต์ที่กำกวมหรืออินพุตที่อยู่นอกการกระจาย
- ขึ้นอยู่กับคุณภาพของพรอมต์: คุณภาพของเอาต์พุตจะขึ้นอยู่กับความชัดเจนของพรอมต์ที่ป้อน ใช้พรอมต์ที่เฉพาะเจาะจงและมีโครงสร้างที่ดี
- ต้นทุนการประมวลผล: การเรียกใช้โมเดล โดยเฉพาะอย่างยิ่งเมื่อมีอินพุตวิดีโอหรือ
thinking_budgetสูง จะใช้ทรัพยากรการประมวลผลและทำให้เกิดค่าใช้จ่าย ดูรายละเอียดเพิ่มเติมได้ที่หน้าการคิด - ประเภทอินพุต: ดูรายละเอียดเกี่ยวกับข้อจำกัดของแต่ละโหมดได้ในหัวข้อต่อไปนี้
ประกาศเกี่ยวกับนโยบายความเป็นส่วนตัว
คุณรับทราบว่าโมเดลที่อ้างอิงในเอกสารนี้ ("โมเดลหุ่นยนต์") ใช้ประโยชน์จากข้อมูลวิดีโอและเสียงเพื่อใช้งานและเคลื่อนย้ายฮาร์ดแวร์ตามวิธีการของคุณ ดังนั้น คุณจึงอาจใช้งานโมเดลหุ่นยนต์ในลักษณะที่โมเดลหุ่นยนต์จะเก็บรวบรวมข้อมูลจากบุคคลที่ระบุตัวตนได้ เช่น ข้อมูลเสียง ภาพ และรูปลักษณ์ ("ข้อมูลส่วนตัว") หากคุณเลือกที่จะใช้งานโมเดลหุ่นยนต์ในลักษณะที่รวบรวมข้อมูลส่วนตัว คุณตกลงว่าจะไม่อนุญาตให้บุคคลที่ระบุตัวตนได้โต้ตอบกับโมเดลหุ่นยนต์หรืออยู่ในบริเวณรอบๆ โมเดลหุ่นยนต์ เว้นแต่และจนกว่าบุคคลที่ระบุตัวตนได้ดังกล่าวจะได้รับแจ้งอย่างเพียงพอและยินยอมให้ Google ได้รับและใช้ข้อมูลส่วนตัวของตนตามที่ระบุไว้ในข้อกำหนดในการให้บริการเพิ่มเติมของ Gemini API ที่ https://ai.google.dev/gemini-api/terms ("ข้อกำหนด") รวมถึงเป็นไปตามส่วนที่ชื่อว่า "วิธีที่ Google ใช้ข้อมูลของคุณ" คุณจะตรวจสอบว่าประกาศดังกล่าวอนุญาตให้มีการเก็บรวบรวมและใช้ข้อมูลส่วนตัวตามที่ระบุไว้ในข้อกำหนด และคุณจะใช้ความพยายามที่สมเหตุสมผลในเชิงพาณิชย์เพื่อลดการเก็บรวบรวมและการเผยแพร่ข้อมูลส่วนตัวโดยใช้เทคนิคต่างๆ เช่น การเบลอใบหน้าและการใช้งานโมเดลหุ่นยนต์ในพื้นที่ที่ไม่มีบุคคลที่ระบุตัวตนได้เท่าที่ทำได้
ราคา
ดูข้อมูลโดยละเอียดเกี่ยวกับราคาและภูมิภาคที่พร้อมให้บริการได้ที่หน้าราคา
ปลายทางของโมเดล
Gemini Robotics ER 2 เวอร์ชันตัวอย่าง
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสรุ่น | gemini-robotics-er-2-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| อัปเดตล่าสุด | กรกฎาคม 2569 |
| Model card | การ์ดโมเดล |
Gemini Robotics ER 2 Streaming Preview
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสรุ่น | gemini-robotics-er-2-streaming-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| อัปเดตล่าสุด | กรกฎาคม 2569 |
| Model card | การ์ดโมเดล |
Gemini Robotics ER 1.6 เวอร์ชันตัวอย่าง
| พร็อพเพอร์ตี้ | คำอธิบาย |
|---|---|
| รหัสรุ่น | gemini-robotics-er-1.6-preview |
| ประเภทข้อมูลที่รองรับ |
อินพุต ข้อความ รูปภาพ วิดีโอ เสียง เอาต์พุต ข้อความ |
| ขีดจำกัดโทเค็น[*] |
ขีดจำกัดโทเค็นอินพุต 131,072 ขีดจำกัดโทเค็นเอาต์พุต 65,536 |
| ความสามารถ | สิ่งที่ทำไม่ได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ การเชื่อมต่อแหล่งข้อมูลกับ Google Maps สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ การเชื่อมต่อแหล่งข้อมูลของ Search สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ สิ่งที่ทำได้ |
| ตัวเลือกการรับชม |
สิ่งที่ทำได้ สิ่งที่ทำไม่ได้ สิ่งที่ทำไม่ได้ |
| เวอร์ชัน |
|
| อัปเดตล่าสุด | ธันวาคม 2025 |
| การตัดข้อมูล | มกราคม 2025 |
ขั้นตอนถัดไป
- การให้เหตุผลเชิงพื้นที่ — การชี้ การติดตาม กรอบล้อมรอบ วิถี
- ความสามารถด้าน Agentic AI — การเรียกใช้โค้ด การอ่านเครื่องมือวัด คำอธิบายประกอบรูปภาพ
- การเรียบเรียงงาน — งานระยะยาวที่มี API หุ่นยนต์ที่กำหนดเอง
- วิทยาการหุ่นยนต์พร้อมการสตรีม - การสตรีมแบบ 2 ทิศทางแบบเรียลไทม์ (Gemini Robotics ER 2 เท่านั้น)
- ความเข้าใจวิดีโอ - การค้นหาช่วงเวลาและการจัดประเภทความคืบหน้า (Gemini Robotics ER 2 เท่านั้น)
- ความปลอดภัยของ Gemini Robotics — การวิจัยด้านความปลอดภัยเบื้องหลังโมเดลตระกูลนี้