

مدلهای Gemini Robotics ER (استدلال تجسمیافته) مدلهای بینایی-زبانی (VLM) هستند که به رباتها امکان میدهند دنیای فیزیکی را درک کنند و با آن تعامل داشته باشند. این مدلها دادههای دیداری را تفسیر میکنند، استدلال فضایی و زمانی انجام میدهند، تکالیف چندمرحلهای را برنامهریزی میکنند، و رباتها و ابزارها را هماهنگ میکنند.
مدلها
مدل Gemini Robotics ER 2 جدیدترین مدل در Gemini Robotics است. این مدل استدلالی بهروزشده ما است که به رباتها امکان میدهد محیط اطرافشان را بهطور دقیق درک کنند. این مدل در قابلیتهای استدلال تجسمیافته تخصص دارد، مانند هماهنگسازی عاملمحور رباتها (مثلاً بااستفاده از VLA)، درک ویدیو توسط ربات ازجمله درک پیشرفت و تشخیص موفقیت، خواندن ابزار، اشاره کردن، و استدلال فضایی.
مدل Gemini Robotics ER 2 دو نقطه پایانی مدل را معرفی میکند:
-
gemini-robotics-er-2-preview: مدل استاندارد ER 2. برپایه Gemini 3.5 Flash با استدلال فضایی بهبودیافته، یافتن لحظه ویدیو، طبقهبندی پیشرفت ویدیو، هماهنگسازی چندرباتی، و استفاده از ابزار چندمرحلهای ساخته شده است. gemini-robotics-er-2-streaming-preview: بهینهسازیشده برای جاریسازی همزمان بااستفاده از Live API. از این مدل برای عاملهای ربات با تأخیر کم که ورودیهای صوتی و تصویری پیوسته را پردازش میکنند استفاده کنید.
Gemini Robotics ER 1.6 در
۳۱ اوت ۲۰۲۶ منسوخ شد.
اگر هنوز از Gemini Robotics ER 1.6 استفاده میکنید، با جایگزین کردن model="gemini-robotics-er-1.6-preview" با model="gemini-robotics-er-2-preview" یا model="gemini-robotics-er-2-streaming-preview" در فراخوانیهای API خود، به Gemini Robotics ER 2 ارتقا دهید.
امتحان کردن Gemini Robotics ER 2 در Google AI Studio
قابلیتهای روباتیک
Gemini Robotics ER از طیفی از قابلیتهای استدلال تجسمیافته پشتیبانی میکند. برای کسب اطلاعات بیشتر، قابلیتی را انتخاب کنید:
| قابلیت | شرح | راهنما |
|---|---|---|
| استدلال فضایی | به اشیا اشاره کنید، آنها را در ویدیو ردیابی کنید، با کادرهای محدودکننده شناسایی کنید، مسیرها را برنامهریزی کنید. | استدلال فضایی |
| بینایی عاملگرا | از اجرای کد برای بهبود قابلیتهای دیگر با بهرهگیری از ابزارهای دستکاری تصویر استفاده کنید. | بینایی عاملگرا |
| سازماندهی تکلیف | استدلال فضایی را با میاناهای برنامهسازی کاربردی سفارشی ربات ترکیب کنید تا تکالیف چندگامی را تکمیل کنید. | سازماندهی تکلیف |
| جاریسازی (فقط نقطه پایان جاریسازی Gemini Robotics ER 2) | جاریسازی دوطرفه برای عاملهای ربات همزمان با فراخوانی تابع با تأخیر کم. | جاریسازی برای روباتیک |
| پیشرفت ویدیو (فقط Gemini Robotics ER 2) | یافتن لحظه و طبقهبندی پیشرفت از فیدهای ویدیویی پیوسته. | درک ویدیو |
قبلاز شروع
مدلهای Gemini Robotics ER ازطریق Gemini Developer API دردسترس هستند. برای شروع، یک کلید Gemini API از Google AI Studio یا کنسول Google Cloud ایجاد کنید و محیط خود را راهاندازی کنید.
برای جزئیات درباره انواع کلید، امنیت، و نحوه پیکربندی کلید در Python، JavaScript، و زبانهای دیگر، به استفاده از کلیدهای Gemini API مراجعه کنید.
درحال شروع کردن
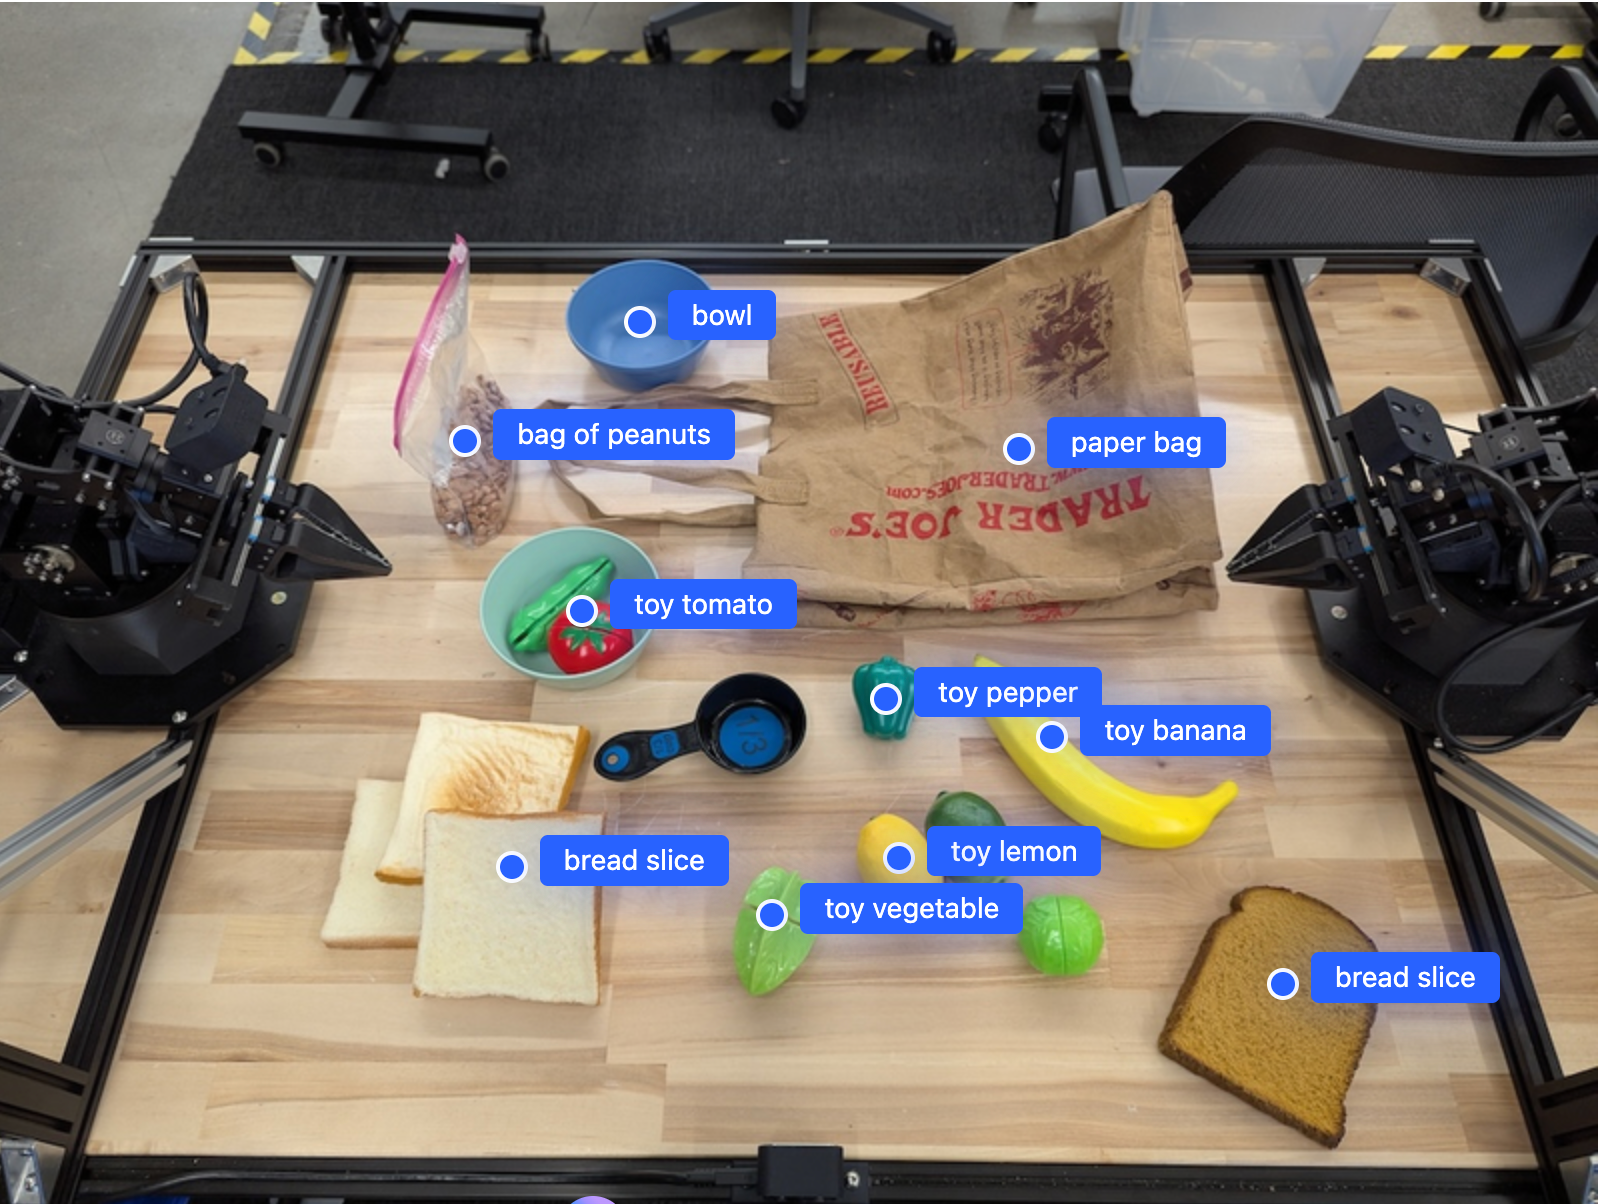
مثال زیر اشیاء را در تصویر پیدا میکند و برچسبها و مختصات دوبعدی نرمالشده آنها را برمیگرداند. میتوانید این خروجی را مستقیماً به یک میانای برنامهسازی کاربردی رباتیک یا یک مدل VLA ارسال کنید تا کنشهای ربات را تولید کند.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
جاوا
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
رفتن
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
استراحت
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
خروجی یک آرایه JSON حاوی اشیاء خواهد بود که هرکدام دارای یک point
(مختصات [y, x] نرمالشده) و یک label برای شناسایی شیء هستند.
(قالب) JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تصویر زیر نمونهای از نحوه نمایش این امتیازها است:
روش کار
Gemini Robotics ER ورودی تصویر، ویدیو، یا صدا را با پیاموارههای زبان طبیعی دریافت میکند. این مدل اشیا را شناسایی میکند، درباره بافت صحنه و روابط فضایی استدلال میکند، و خروجی ساختاریافتهای مانند مختصات یا جعبههای مرزی برمیگرداند.
Gemini Robotics ER همچنین عاملی است: تکالیف پیچیده را به تکالیف فرعی تقسیم میکند و آنها را با فراخوانی عملکردهای ربات شما یا اجرای کد تولیدشده اجرا میکند. برای مثال، «سیب را در کاسه بگذار» به توالیای از مراحل مکانیابی، گرفتن، و قرار دادن تبدیل میشود.
برای جزئیات بیشتر درباره نحوه اجرای فراخوانیهای ابزار توسط Gemini، به فراخوانی تابع مراجعه کنید.
ایمنی
درحالیکه Gemini Robotics ER با درنظر گرفتن ایمنی ساخته شده است، مسئولیت حفظ محیطی ایمن در اطراف ربات برعهده شما است. مدلهای هوش مصنوعی زایا ممکن است اشتباه کنند و رباتهای فیزیکی ممکن است باعث آسیب شوند. برای کسب اطلاعات بیشتر، به صفحه ایمنی Gemini Robotics مراجعه کنید.
روالهای مطلوب
از زبان ساده و طبیعی استفاده کنید. کاری را که میخواهید ربات انجام دهد بهگونهای توصیف کنید که انگار دارید با یک انسان صحبت میکنید. اگر عبارتی کار نمیکند، مترادف رایجی را امتحان کنید.
ورودی دیداری را بهینه کن. قبلاز ارسال تصویر، اشیای کوچک یا نامشخص را برش دهید یا روی آنها زومپیش کنید. نور و کنتراست رنگ پایین میتواند بر تشخیص تأثیر بگذارد.
تکالیف پیچیده را به چند مرحله تقسیم کنید. هر مرحله را بهعنوان پیاموارهای جداگانه ارسال کنید تا مدل متمرکز بماند و دقت بهبود یابد.
برای کارهای با دقت بالا، چندینبار پُرسمان کنید و نتایج را میانگین بگیرید. این رویکرد اجماعی، واریانس را در خروجیهای فضایی کاهش میدهد.
محدودیتها
هنگام توسعه با Gemini Robotics ER، محدودیتهای زیر را درنظر بگیرید:
- محدودیتهای کلید میانای برنامهسازی کاربردی: Gemini API درخواستهای ارسالشده از کلیدهای میانای برنامهسازی کاربردی بدون محدودیت را نمیپذیرد و خطای
403 Forbiddenبرمیگرداند. با افزودن محدودیت در AI Studio، کلید میانای برنامهسازی کاربردی خود را ایمن کنید. برای جزئیات، به ایمن کردن کلیدهای میانای برنامهسازی کاربردی نامحدود مراجعه کنید. - تأخیر درمقابل عملکرد: پُرسمانهای پیچیده، ورودیهای با وضوح بالا، یا سطوح تفکر بالا میتواند منجر به افزایش زمان پردازش شود. برای سطح اندیشیدن از «متوسط» برای ایجاد تعادل خوب بین تأخیر و عملکرد استفاده کنید.
- توهم: مانند همه مدلهای زبانی بزرگ، مدلهای Gemini Robotics ER ممکن است گاهیاوقات «توهم» داشته باشند یا اطلاعات نادرست ارائه دهند، بهویژه برای پیاموارههای مبهم یا ورودیهای خارج از توزیع.
- وابستگی به کیفیت پیامواره: کیفیت برونداد به وضوح پیامواره ورودی بستگی دارد. از پیاموارههای خاص و خوشساخت استفاده کنید.
- هزینه محاسباتی: اجرای مدل، بهویژه با ورودیهای ویدیویی یا
thinking_budgetبالا، منابع محاسباتی را مصرف میکند و هزینههایی را بههمراه دارد. برای جزئیات بیشتر، به صفحه تفکر مراجعه کنید. - انواع ورودی: برای جزئیات مربوط به محدودیتهای هر حالت، موضوعات زیر را ببینید.
اعلامیه حریم خصوصی
شما تأیید میکنید که مدلهای اشارهشده در این سند («مدلهای رباتیک») از دادههای ویدیویی و صوتی برای عملکرد و حرکت سختافزار شما مطابق با دستورالعملهای شما استفاده میکنند. بنابراین، ممکن است «مدلهای رباتیک» را بهگونهای بهکار بگیرید که دادههای افراد قابلشناسایی، مانند صدا، تصاویر، و دادههای شباهت («دادههای شخصی»)، توسط «مدلهای رباتیک» جمعآوری شود. اگر تصمیم بگیرید «مدلهای رباتیک» را بهگونهای بهکار بگیرید که «دادههای شخصی» جمعآوری کند، موافقت میکنید که به هیچ فرد قابلشناسایی اجازه ندهید با «مدلهای رباتیک» تعامل داشته باشد یا در محیط اطراف آن حضور داشته باشد، مگر اینکه و تا زمانی که به این افراد قابلشناسایی بهاندازه کافی اطلاع داده شده باشد و آنها رضایت داده باشند که «دادههای شخصی» آنها ممکن است به Google ارائه شود و توسط Google استفاده شود، همانطور که در «شرایط خدمات تکمیلی Gemini API» در https://ai.google.dev/gemini-api/terms («شرایط») ذکر شده است، ازجمله مطابق با بخش «نحوه استفاده Google از دادههای شما». شما تضمین خواهید کرد که چنین اعلامیهای اجازه جمعآوری و استفاده از «دادههای شخصی» را همانطور که در «شرایط» ذکر شده است میدهد، و از تلاشهای معقول تجاری برای بهحداقل رساندن جمعآوری و توزیع «دادههای شخصی» بااستفاده از تکنیکهایی مانند محو کردن چهره و بهکار انداختن «مدلهای رباتیک» در مناطقی که حاوی افراد قابلشناسایی نیستند تا حد امکان استفاده خواهید کرد.
قیمتگذاری
برای اطلاعات دقیق درباره قیمتگذاری و مناطق دردسترس، به صفحه قیمتگذاری مراجعه کنید.
نقطههای پایانی مدل
Gemini Robotics ER 2 Preview
| دارایی | شرح |
|---|---|
| کد مدل | gemini-robotics-er-2-preview |
| انواع دادههای پشتیبانیشده |
ورودیها نوشتار، تصویر، ویدیو، صدا خروجی نوشتار |
| محدودیتهای توکن[*] |
حد دادهواحد ورودی ۱۳۱,۰۷۲ محدودیت دادهواحد برونداد ۶۵۵۳۶ |
| قابلیتها | پشتیبانی نمیشود پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده |
| گزینههای مصرف |
پشتیبانیشده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| جدیدترین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
Gemini Robotics ER 2 Streaming Preview
| دارایی | شرح |
|---|---|
| کد مدل | gemini-robotics-er-2-streaming-preview |
| انواع دادههای پشتیبانیشده |
ورودیها نوشتار، تصویر، ویدیو، صدا خروجی نوشتار |
| محدودیتهای توکن[*] |
حد دادهواحد ورودی ۱۳۱,۰۷۲ محدودیت دادهواحد برونداد ۶۵۵۳۶ |
| قابلیتها | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانیشده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانیشده پشتیبانیشده پشتیبانی نمیشود پشتیبانیشده پشتیبانی نمیشود |
| گزینههای مصرف |
پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| جدیدترین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
Gemini Robotics ER 1.6 Preview
| دارایی | شرح |
|---|---|
| کد مدل | gemini-robotics-er-1.6-preview |
| انواع دادههای پشتیبانیشده |
ورودیها نوشتار، تصویر، ویدیو، صدا خروجی نوشتار |
| محدودیتهای توکن[*] |
حد دادهواحد ورودی ۱۳۱,۰۷۲ محدودیت دادهواحد برونداد ۶۵۵۳۶ |
| قابلیتها | پشتیبانی نمیشود پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانیشده پشتیبانیشده پشتیبانیشده پشتیبانیشده |
| گزینههای مصرف |
پشتیبانیشده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| جدیدترین بهروزرسانی | دسامبر ۲۰۲۵ |
| تاریخ برش دانش | ژانویه ۲۰۲۵ |
قدم بعدی چیست
- استدلال فضایی — اشاره کردن، ردیابی، چارگوشهای محصورکننده، مسیرها.
- قابلیتهای عاملگرا — اجرای کد، خواندن ابزار، حاشیهنویسی تصویر.
- سازماندهی تکلیف — تکالیف چندگامی با میاناهای برنامهسازی کاربردی ربات سفارشی.
- رباتیک با جاریسازی — جاریسازی دوطرفه همزمان (فقط Gemini Robotics ER 2).
- درک ویدیو — یافتن لحظه و طبقهبندی پیشرفت (فقط Gemini Robotics ER 2).
- ایمنی Gemini Robotics — پژوهشهای ایمنی پشت این خانواده مدل.