

Mô hình Gemini Robotics ER (lý luận hiện thân) là mô hình ngôn ngữ thị giác (VLM) giúp robot nhận thức và tương tác với thế giới vật lý. Các mô hình này diễn giải dữ liệu hình ảnh, thực hiện suy luận về không gian và thời gian, lập kế hoạch cho các nhiệm vụ nhiều bước, cũng như điều phối rô-bốt và công cụ.
Mô hình
Mô hình Gemini Robotics ER 2 là mô hình mới nhất trong Gemini Robotics. Đây là mô hình suy luận mới nhất của chúng tôi, giúp robot hiểu chính xác môi trường xung quanh. Mô hình này chuyên về các khả năng suy luận hiện thân, chẳng hạn như điều phối tác nhân của robot (ví dụ: sử dụng VLA), hiểu video của robot, bao gồm cả việc hiểu tiến trình và phát hiện thành công, đọc thiết bị, chỉ và suy luận không gian.
Mô hình Gemini Robotics ER 2 có hai điểm cuối mô hình:
gemini-robotics-er-2-preview: Mô hình ER 2 tiêu chuẩn. Được xây dựng dựa trên Gemini 3.5 Flash với khả năng suy luận không gian, tìm khoảnh khắc trong video, phân loại tiến trình video, điều phối nhiều robot và sử dụng công cụ nhiều bước được cải thiện.gemini-robotics-er-2-streaming-preview: Được tối ưu hoá cho hoạt động truyền trực tuyến theo thời gian thực bằng Live API. Sử dụng mô hình này cho các tác nhân robot có độ trễ thấp, xử lý dữ liệu đầu vào âm thanh và video liên tục.
Gemini Robotics ER 1.6 đã
ngừng hoạt động vào ngày 31 tháng 8 năm 2026.
Nếu bạn vẫn đang sử dụng Gemini Robotics ER 1.6, hãy nâng cấp lên Gemini Robotics ER 2
bằng cách thay thế model="gemini-robotics-er-1.6-preview" bằng
model="gemini-robotics-er-2-preview" hoặc
model="gemini-robotics-er-2-streaming-preview" trong các lệnh gọi API.
Dùng thử Gemini Robotics ER 2 trong Google AI Studio
Khả năng của người máy
Gemini Robotics ER hỗ trợ nhiều khả năng suy luận hiện thân. Chọn một chức năng để tìm hiểu thêm:
| Chức năng | Mô tả | Hướng dẫn |
|---|---|---|
| Suy luận không gian | Chỉ vào đối tượng, theo dõi đối tượng trong video, phát hiện bằng hộp giới hạn, lập kế hoạch quỹ đạo. | Tư duy không gian |
| Tầm nhìn của tác nhân | Sử dụng tính năng thực thi mã để nâng cao các chức năng khác bằng cách tận dụng các công cụ xử lý hình ảnh. | Tầm nhìn về tác nhân |
| Điều phối tác vụ | Kết hợp khả năng suy luận không gian với các API robot tuỳ chỉnh để hoàn thành các nhiệm vụ có phạm vi kéo dài. | Điều phối tác vụ |
| Phát trực tuyến (Chỉ dành cho điểm cuối phát trực tuyến Gemini Robotics ER 2) | Truyền trực tuyến hai chiều cho các tác nhân robot theo thời gian thực với lệnh gọi hàm có độ trễ thấp. | Truyền trực tuyến cho robot |
| Tiến trình video (chỉ dành cho Gemini Robotics ER 2) | Tìm khoảnh khắc và phân loại tiến trình từ nguồn cấp dữ liệu video liên tục. | Hiểu video |
Trước khi bắt đầu
Các mô hình ER của Gemini Robotics được cung cấp thông qua Gemini Developer API. Để bắt đầu, hãy tạo một khoá Gemini API từ Google AI Studio hoặc Google Cloud Console, rồi thiết lập môi trường của bạn.
Để biết thông tin chi tiết về các loại khoá, tính bảo mật và cách định cấu hình khoá API trong Python, JavaScript và các ngôn ngữ khác, hãy xem bài viết Sử dụng khoá Gemini API.
Bắt đầu
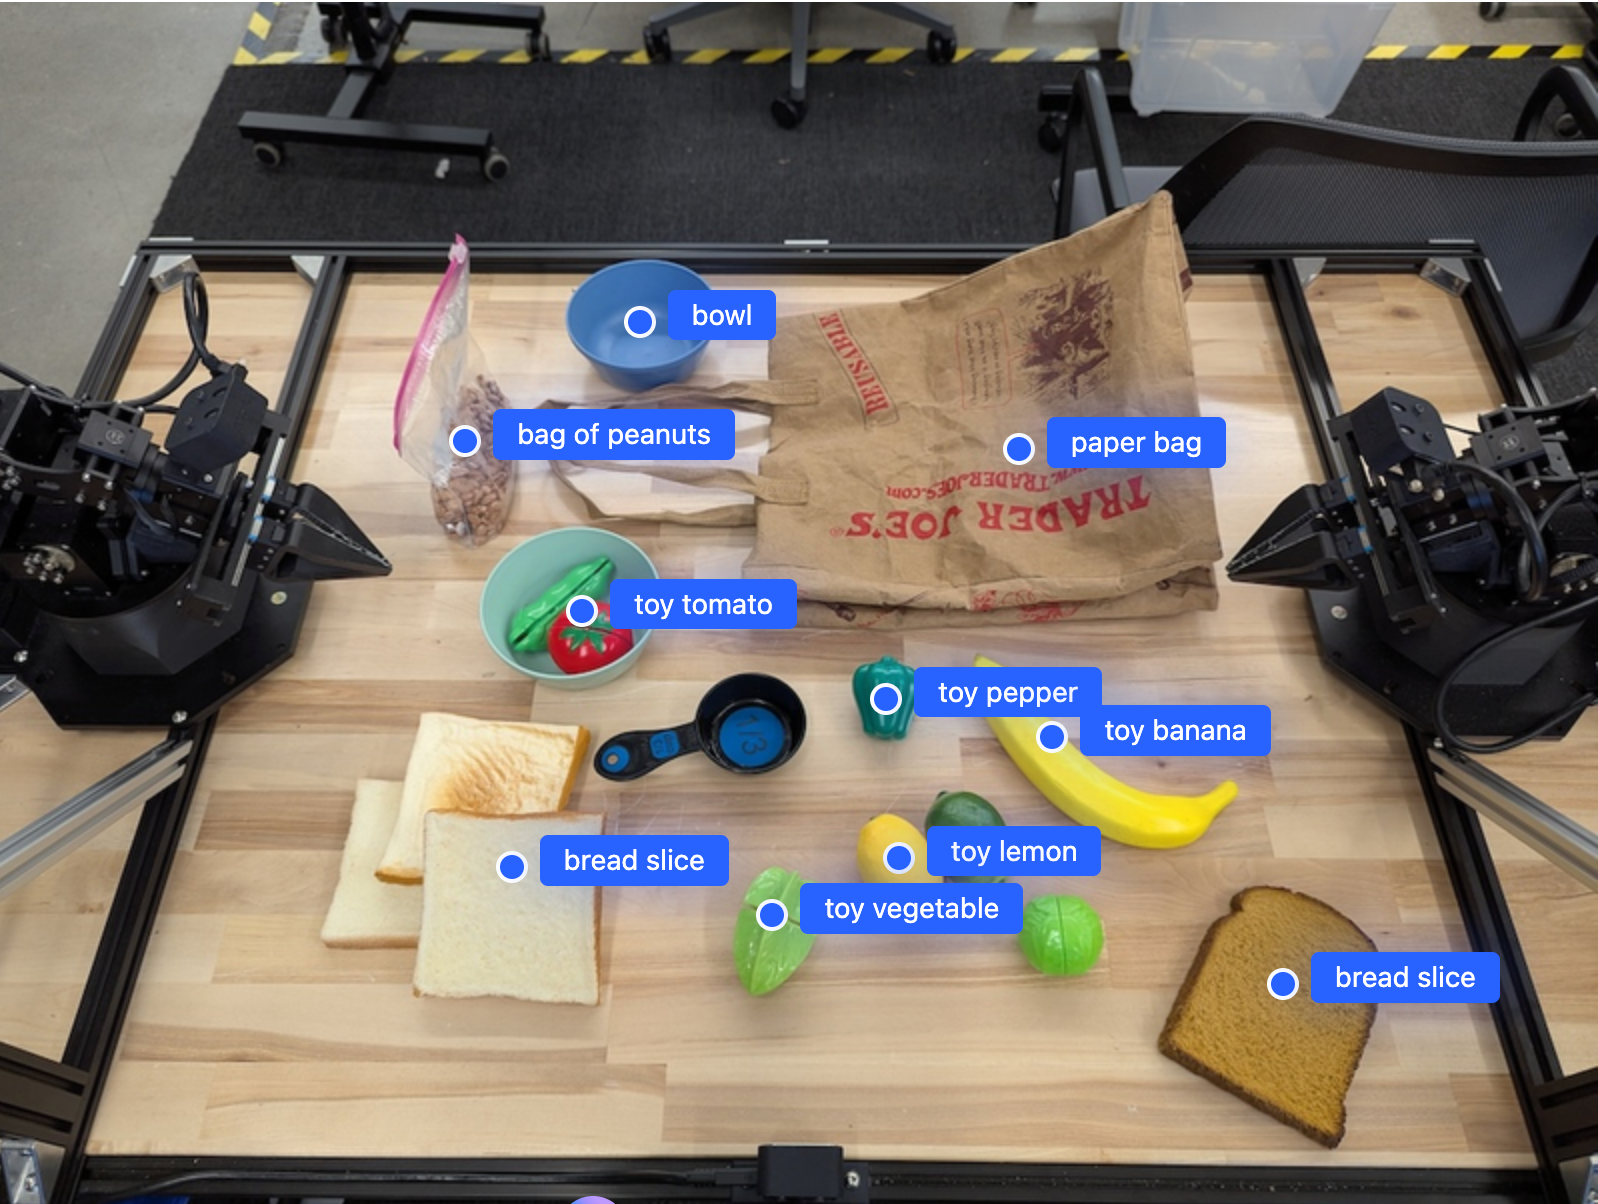
Ví dụ sau đây tìm các đối tượng trong một hình ảnh và trả về nhãn cũng như toạ độ 2D chuẩn hoá của các đối tượng đó. Bạn có thể truyền trực tiếp kết quả này đến một API robot hoặc một mô hình VLA để tạo hành động cho robot.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
Kết quả sẽ là một mảng JSON chứa các đối tượng, mỗi đối tượng có một point (toạ độ [y, x] chuẩn hoá) và một label xác định đối tượng.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Hình ảnh sau đây là ví dụ về cách hiển thị các điểm này:
Cách hoạt động
Gemini Robotics ER nhận dữ liệu đầu vào là hình ảnh, video hoặc âm thanh kèm theo câu lệnh bằng ngôn ngữ tự nhiên. Mô hình này xác định các đối tượng, suy luận về bối cảnh cảnh và mối quan hệ không gian, đồng thời trả về kết quả có cấu trúc như toạ độ hoặc hộp giới hạn.
Gemini Robotics ER cũng có khả năng hoạt động như tác nhân: mô hình này chia nhỏ các nhiệm vụ phức tạp thành các nhiệm vụ phụ và thực thi bằng cách gọi các hàm robot hoặc chạy mã được tạo. Ví dụ: "đặt quả táo vào bát" trở thành một chuỗi các bước xác định vị trí, nắm lấy và đặt.
Xem phần Gọi hàm để biết thông tin chi tiết về cách Gemini thực thi lệnh gọi công cụ.
An toàn
Mặc dù Gemini Robotics ER được xây dựng chú trọng đến sự an toàn, nhưng bạn có trách nhiệm duy trì một môi trường an toàn xung quanh robot. Các mô hình AI tạo sinh có thể mắc sai sót và robot vật lý có thể gây thiệt hại. Để tìm hiểu thêm, hãy truy cập vào trang an toàn của Gemini Robotics.
Các phương pháp hay nhất
Sử dụng ngôn ngữ đơn giản, tự nhiên. Mô tả những việc bạn muốn robot làm như khi bạn nói với một người. Nếu một cụm từ không hiệu quả, hãy thử dùng một từ đồng nghĩa phổ biến.
Tối ưu hoá dữ liệu hình ảnh đầu vào. Cắt hoặc phóng to các đối tượng nhỏ hoặc không rõ ràng trước khi gửi hình ảnh. Ánh sáng và độ tương phản màu thấp có thể ảnh hưởng đến khả năng phát hiện.
Chia nhỏ các việc phức tạp thành từng bước. Gửi từng bước dưới dạng một câu lệnh riêng biệt để mô hình luôn tập trung và cải thiện độ chính xác.
Truy vấn nhiều lần và lấy kết quả trung bình cho các nhiệm vụ có độ chính xác cao. Phương pháp đồng thuận này giúp giảm sự khác biệt về kết quả không gian.
Các điểm hạn chế
Hãy cân nhắc những hạn chế sau đây khi phát triển bằng Gemini Robotics ER:
- Các quy tắc hạn chế đối với khoá API: Gemini API không chấp nhận yêu cầu từ các khoá API không bị hạn chế và trả về lỗi
403 Forbidden. Bảo mật khoá API của bạn bằng cách thêm các quy tắc hạn chế trong AI Studio. Hãy xem bài viết Bảo mật khoá API không bị hạn chế để biết thông tin chi tiết. - Độ trễ so với hiệu suất: Các câu hỏi phức tạp, dữ liệu đầu vào có độ phân giải cao hoặc mức độ suy luận cao có thể làm tăng thời gian xử lý. Đối với cấp độ tư duy, hãy sử dụng mức trung bình để cân bằng giữa độ trễ và hiệu suất.
- Ảo tưởng: Giống như tất cả các mô hình ngôn ngữ lớn, các mô hình ER của Gemini Robotics đôi khi có thể "ảo tưởng" hoặc cung cấp thông tin không chính xác, đặc biệt là đối với các câu lệnh mơ hồ hoặc dữ liệu đầu vào nằm ngoài phạm vi phân phối.
- Phụ thuộc vào chất lượng câu lệnh: Chất lượng kết quả đầu ra phụ thuộc vào độ rõ ràng của câu lệnh đầu vào. Sử dụng câu lệnh cụ thể, có cấu trúc rõ ràng.
- Chi phí điện toán: Việc chạy mô hình, đặc biệt là với dữ liệu đầu vào dạng video hoặc
thinking_budgetcao, sẽ tiêu tốn tài nguyên điện toán và phát sinh chi phí. Hãy xem trang Tư duy để biết thêm thông tin chi tiết. - Loại dữ liệu đầu vào: Hãy xem các chủ đề sau để biết thông tin chi tiết về các giới hạn cho từng chế độ.
Thông báo về quyền riêng tư
Bạn xác nhận rằng các mô hình được đề cập trong tài liệu này ("Mô hình robot") sử dụng dữ liệu video và âm thanh để vận hành và di chuyển phần cứng theo hướng dẫn của bạn. Do đó, bạn có thể vận hành Mô hình robot theo cách mà dữ liệu của người có thể nhận dạng, chẳng hạn như dữ liệu về giọng nói, hình ảnh và chân dung ("Dữ liệu cá nhân"), sẽ được Mô hình robot thu thập. Nếu chọn vận hành Mô hình robot theo cách thu thập Dữ liệu cá nhân, bạn đồng ý rằng bạn sẽ không cho phép bất kỳ người có thể nhận dạng nào tương tác với hoặc có mặt trong khu vực xung quanh Mô hình robot, trừ phi và cho đến khi những người có thể nhận dạng đó đã được thông báo đầy đủ và đồng ý với việc Dữ liệu cá nhân của họ có thể được cung cấp cho Google và được Google sử dụng như nêu trong Điều khoản dịch vụ bổ sung của Gemini API tại https://ai.google.dev/gemini-api/terms ("Điều khoản"), bao gồm cả việc tuân thủ mục có tiêu đề "Cách Google sử dụng dữ liệu của bạn". Bạn sẽ đảm bảo rằng thông báo đó cho phép thu thập và sử dụng dữ liệu cá nhân như được nêu trong Điều khoản, đồng thời bạn sẽ nỗ lực hợp lý về phương diện thương mại để giảm thiểu việc thu thập và phân phối dữ liệu cá nhân bằng cách sử dụng các kỹ thuật như làm mờ khuôn mặt và vận hành Mô hình robot ở những khu vực không có người có thể nhận dạng trong phạm vi có thể thực hiện được.
Giá
Để biết thông tin chi tiết về giá và các khu vực được hỗ trợ, hãy tham khảo trang giá.
Điểm cuối của mô hình
Gemini Robotics ER 2 Preview
| Thuộc tính | Mô tả |
|---|---|
| Mã kiểu máy | gemini-robotics-er-2-preview |
| Các loại dữ liệu được hỗ trợ |
Thông tin đầu vào Văn bản, hình ảnh, video, âm thanh Kết quả Văn bản |
| Giới hạn về mã thông báo[*] |
Giới hạn về số lượng mã thông báo đầu vào 131.072 Giới hạn mã thông báo đầu ra 65.536 |
| Tính năng | Không được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Không được hỗ trợ Không được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ |
| Lựa chọn sử dụng |
Được hỗ trợ Không được hỗ trợ Không được hỗ trợ |
| phiên bản |
|
| Thông tin cập nhật mới nhất | Tháng 7 năm 2026 |
| Thẻ mô hình | Thẻ thông tin mô hình |
Gemini Robotics ER 2 Streaming Preview
| Thuộc tính | Mô tả |
|---|---|
| Mã kiểu máy | gemini-robotics-er-2-streaming-preview |
| Các loại dữ liệu được hỗ trợ |
Thông tin đầu vào Văn bản, hình ảnh, video, âm thanh Kết quả Văn bản |
| Giới hạn về mã thông báo[*] |
Giới hạn về số lượng mã thông báo đầu vào 131.072 Giới hạn mã thông báo đầu ra 65.536 |
| Tính năng | Không được hỗ trợ Không được hỗ trợ Không được hỗ trợ Không được hỗ trợ Không được hỗ trợ Được hỗ trợ Không được hỗ trợ Không được hỗ trợ Được hỗ trợ Được hỗ trợ Không được hỗ trợ Được hỗ trợ Không được hỗ trợ |
| Lựa chọn sử dụng |
Không được hỗ trợ Không được hỗ trợ Không được hỗ trợ |
| phiên bản |
|
| Thông tin cập nhật mới nhất | Tháng 7 năm 2026 |
| Thẻ mô hình | Thẻ thông tin mô hình |
Gemini Robotics ER 1.6 Preview
| Thuộc tính | Mô tả |
|---|---|
| Mã kiểu máy | gemini-robotics-er-1.6-preview |
| Các loại dữ liệu được hỗ trợ |
Thông tin đầu vào Văn bản, hình ảnh, video, âm thanh Kết quả Văn bản |
| Giới hạn về mã thông báo[*] |
Giới hạn về số lượng mã thông báo đầu vào 131.072 Giới hạn mã thông báo đầu ra 65.536 |
| Tính năng | Không được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Không được hỗ trợ Không được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ Được hỗ trợ |
| Lựa chọn sử dụng |
Được hỗ trợ Không được hỗ trợ Không được hỗ trợ |
| phiên bản |
|
| Thông tin cập nhật mới nhất | Tháng 12 năm 2025 |
| Điểm cắt kiến thức | Tháng 1 năm 2025 |
Bước tiếp theo
- Lý luận không gian – chỉ, theo dõi, hộp giới hạn, quỹ đạo.
- Khả năng của tác nhân AI – thực thi mã, đọc dữ liệu từ thiết bị, chú thích hình ảnh.
- Điều phối tác vụ – các tác vụ có phạm vi kéo dài bằng API robot tuỳ chỉnh.
- Robotics có tính năng truyền trực tuyến — truyền trực tuyến hai chiều theo thời gian thực (chỉ có trên Gemini Robotics ER 2).
- Hiểu video — tìm khoảnh khắc và phân loại tiến trình (chỉ có trên Gemini Robotics ER 2).
- An toàn trong Gemini Robotics – nghiên cứu về an toàn đằng sau nhóm mô hình này.