

Die Gemini API bietet Sicherheitseinstellungen, die Sie während der Prototyping-Phase anpassen können, um zu ermitteln, ob Ihre Anwendung eine mehr oder weniger restriktive Sicherheitskonfiguration erfordert. Sie können diese Einstellungen in verschiedenen Filterkategorien anpassen, um bestimmte Arten von Inhalten zuzulassen oder zu beschränken.
In diesem Leitfaden erfahren Sie, wie Sie Sicherheitseinstellungen für eine Interaktion festlegen, was passiert, wenn Inhalte blockiert werden, und welche Kategorien und Grenzwerte Sie verwenden können.
Sicherheitseinstellungen festlegen
Übergeben Sie beim Erstellen einer Interaktion eine Liste von safety_settings. Jede Einstellung verknüpft eine Kategorie schädlicher Inhalte (type) mit einem Grenzwert für die Blockierung (threshold).
Im folgenden Beispiel wird die Kategorie Hassrede (hate_speech) auf block_low_and_above festgelegt. Dadurch werden alle Inhalte blockiert, bei denen die Wahrscheinlichkeit, dass es sich um Hassrede handelt, gering oder höher ist:
Python
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Some potentially unsafe prompt.",
    safety_settings=[
        {
            "type": "hate_speech",
            "threshold": "block_low_and_above",
        }
    ],
)

print(interaction.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI({});

async function main() {
  const interaction = await ai.interactions.create({
    model: "gemini-3.8-flash",
    input: "Some potentially unsafe prompt.",
    safety_settings: [
      {
        type: "hate_speech",
        threshold: "block_low_and_above",
      },
    ],
  });
  console.log(interaction.output_text);
}

await main();
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.HarmCategory;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.SafetySetting;
import com.google.genai.gaos.models.interactions.Threshold;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import java.util.List;

Client client = new Client();

SafetySetting hateSpeechSafety =
    SafetySetting.builder()
        .type(HarmCategory.HATE_SPEECH)
        .threshold(Threshold.BLOCK_LOW_AND_ABOVE)
        .build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-3.8-flash"))
        .input(InteractionsInput.of("Some potentially unsafe prompt."))
        .safetySettings(List.of(hateSpeechSafety))
        .build();

Interaction interaction =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(interaction.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-3.8-flash"),
            Input: interactions.NewInteractionsInput("Some potentially unsafe prompt."),
            SafetySettings: []interactions.SafetySetting{
                {
                    Type:      interactions.HarmCategoryHateSpeech,
                    Threshold: interactions.ThresholdBlockLowAndAbove,
                },
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }

    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -H "Api-Revision: 2026-05-20" \
  -d '{
    "model": "gemini-3.8-flash",
    "input": "Some potentially unsafe prompt.",
    "safety_settings": [
      {"type": "hate_speech", "threshold": "block_low_and_above"}
    ]
  }'
Sie können eine Einstellung pro Kategorie festlegen. Für Kategorien, die Sie nicht festlegen, wird der Standardgrenzwert verwendet. Dieser ist für Gemini-Modelle der Version 2.5 und höher Aus.
Wenn Inhalte blockiert werden
Wenn ein Sicherheitsfilter die Eingabe oder die Antwort des Modells blockiert, schlägt die Interaktion mit einem HTTP-Fehler 400 fehl. Die blockierten Inhalte werden nicht zurückgegeben.
Der Fehler code gibt an, warum die Anfrage blockiert wurde:
safety: Die Eingabe oder Antwort wurde von einem Sicherheitsfilter blockiert.jailbreak,prohibited_contentoderblocklist: Die Eingabe wurde aus diesem Grund blockiert. Diemessagedes Fehlers beginnt mitInput blocked:.
Beispiel:
{
  "error": {
    "code": "safety",
    "message": "Request blocked due to safety violations (harmful content). Please modify your input and retry."
  }
}
Bei Hintergrundinteraktionen (background=true) wird der status auf
failed gesetzt und derselbe code und message werden in der Liste errors angezeigt.
Beim Streaming wird der Fehler als error-Ereignis gesendet.
Sicherheitsfilter
Die anpassbaren Sicherheitsfilter der Gemini API decken die folgenden Kategorien ab:
| Kategorie | Wert (API) | Beschreibung |
|---|---|---|
| Belästigung | harassment |
Missbräuchliche, bedrohliche oder Inhalte, die darauf abzielen, andere zu mobben, zu quälen oder lächerlich zu machen. |
| Hassrede | hate_speech |
Inhalte, die Gewalt fördern oder Hass gegen Einzelpersonen oder Gruppen aufgrund bestimmter Attribute schüren. |
| Sexuell explizite Inhalte | sexually_explicit |
Inhalte, die sexuell explizites Material enthalten. |
| Gefährlich | dangerous_content |
Inhalte, die gefährliche Aktivitäten fördern, erleichtern oder ermöglichen. |
| Jailbreak | jailbreak |
Prompts, die darauf ausgelegt sind, Sicherheitsfilter zu umgehen. |
Sie können diese Filter verwenden, um die für Ihren Anwendungsfall passenden Einstellungen vorzunehmen. Wenn Sie beispielsweise Dialoge für Videospiele erstellen, halten Sie es aufgrund der Art des Spiels möglicherweise für akzeptabel, mehr Inhalte zuzulassen, die als Gefährlich eingestuft wurden.
Neben den anpassbaren Sicherheitsfiltern bietet die Gemini API integrierte Schutzmaßnahmen gegen grundlegend schädliche Inhalte, wie solche, die die Sicherheit von Kindern gefährden. Diese Arten von schädlichen Inhalten werden immer blockiert und können nicht angepasst werden.
Grenzwerte für die Blockierung
Aufgrund der inhärenten Sicherheit des Modells sind zusätzliche Filter standardmäßig Aus. Das Standardverhalten des Modells deckt die meisten Anwendungsfälle ab. Passen Sie diese Einstellungen also nur an, wenn dies durchgehend für Ihre Anwendung erforderlich ist.
In der folgenden Tabelle werden die Grenzwerte beschrieben, die Sie für jede Kategorie festlegen können. Wenn Sie beispielsweise Hassrede auf Wenige blockieren (block_only_high) setzen, werden Inhalte mit einer hohen Wahrscheinlichkeit, dass es sich um Hassrede handelt, blockiert. Inhalte mit einer geringeren Wahrscheinlichkeit werden zugelassen.
| Grenzwert (Google AI Studio) | Grenzwert (API) | Beschreibung |
|---|---|---|
| Aus | off |
Sicherheitsfilter deaktivieren |
| Wenige blockieren | block_only_high |
Blockieren, wenn eine hohe Wahrscheinlichkeit für unsichere Inhalte besteht |
| Einige blockieren | block_medium_and_above |
Blockieren, wenn eine mittlere oder hohe Wahrscheinlichkeit für unsichere Inhalte besteht |
| Meiste blockieren | block_low_and_above |
Blockieren, wenn eine geringe, mittlere oder hohe Wahrscheinlichkeit für unsichere Inhalte besteht |
Wahrscheinlichkeit im Vergleich zum Schweregrad
Die Gemini API bewertet die Wahrscheinlichkeit, dass Inhalte unsicher sind, als hoch, mittel, gering oder vernachlässigbar. Inhalte werden basierend auf dieser Wahrscheinlichkeit blockiert, nicht auf dem Schweregrad des Schadens. Bei einigen Inhalten kann die Wahrscheinlichkeit, dass sie unsicher sind, gering sein, obwohl der Schaden schwerwiegend sein könnte. Vergleichen Sie beispielsweise diese Sätze:
- Der Roboter hat mich geboxt.
- Der Roboter hat mich in Stücke geschnitten.
Beim ersten Satz ist die Wahrscheinlichkeit, dass er unsicher ist, möglicherweise höher, aber der zweite Satz ist möglicherweise schwerwiegender. Führen Sie sorgfältige Tests durch, um das Maß an Blockierungen zu finden, das Ihren Anwendungsfall unterstützt und gleichzeitig den Schaden für Endnutzer minimiert.
Sicherheitseinstellungen in Google AI Studio anpassen
Klicken Sie im Bereich Ausführungseinstellungen unter Erweiterte Einstellungen auf Sicherheitseinstellungen , um das Modalfenster Sicherheitseinstellungen ausführen zu öffnen. Im Modalfenster können Sie mit den Schiebereglern die Stufe der Inhaltsfilterung pro Sicherheitskategorie anpassen:
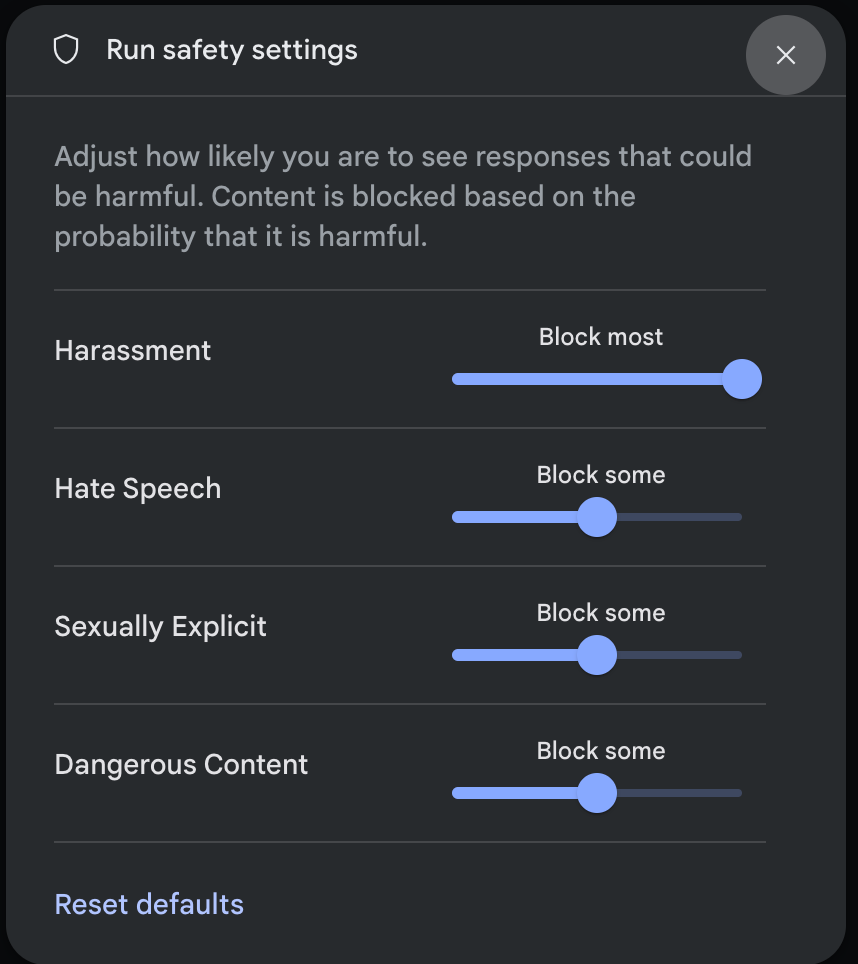
Wenn Sie eine Anfrage senden (z. B. indem Sie dem Modell eine Frage stellen), wird die Inhalte blockiert angezeigt, wenn die Inhalte der Anfrage blockiert werden. Wenn Sie weitere Details sehen möchten, bewegen Sie den Mauszeiger auf den Text Inhalte blockiert. Dort werden die Kategorie und die Wahrscheinlichkeit der Klassifizierung schädlicher Inhalte angezeigt.
Nächste Schritte
- Weitere Informationen zur vollständigen API finden Sie in der Interactions API-Referenz.
- In den Sicherheitshinweisen finden Sie allgemeine Informationen zu Sicherheits aspekten bei der Entwicklung mit LLMs.
- Weitere Informationen zur Bewertung von Wahrscheinlichkeit und Schweregrad finden Sie im Blog des Jigsaw Teams.
- Weitere Informationen zu den Produkten, die zu Sicherheitslösungen wie der Perspective API beitragen