

La API de Gemini Live permite conversaciones de voz bidireccionales en tiempo real con los modelos de Gemini.
Los modelos de voz estándar funcionan bien para los diálogos inmediatos. Le hablas al modelo y este genera una respuesta hablada de inmediato. Sin embargo, cuando una solicitud requiere planificación, análisis complejos o herramientas externas, las respuestas directas alcanzan un límite. El modelo debe responder sin razonar o pausarse en silencio mientras espera que las herramientas terminen.
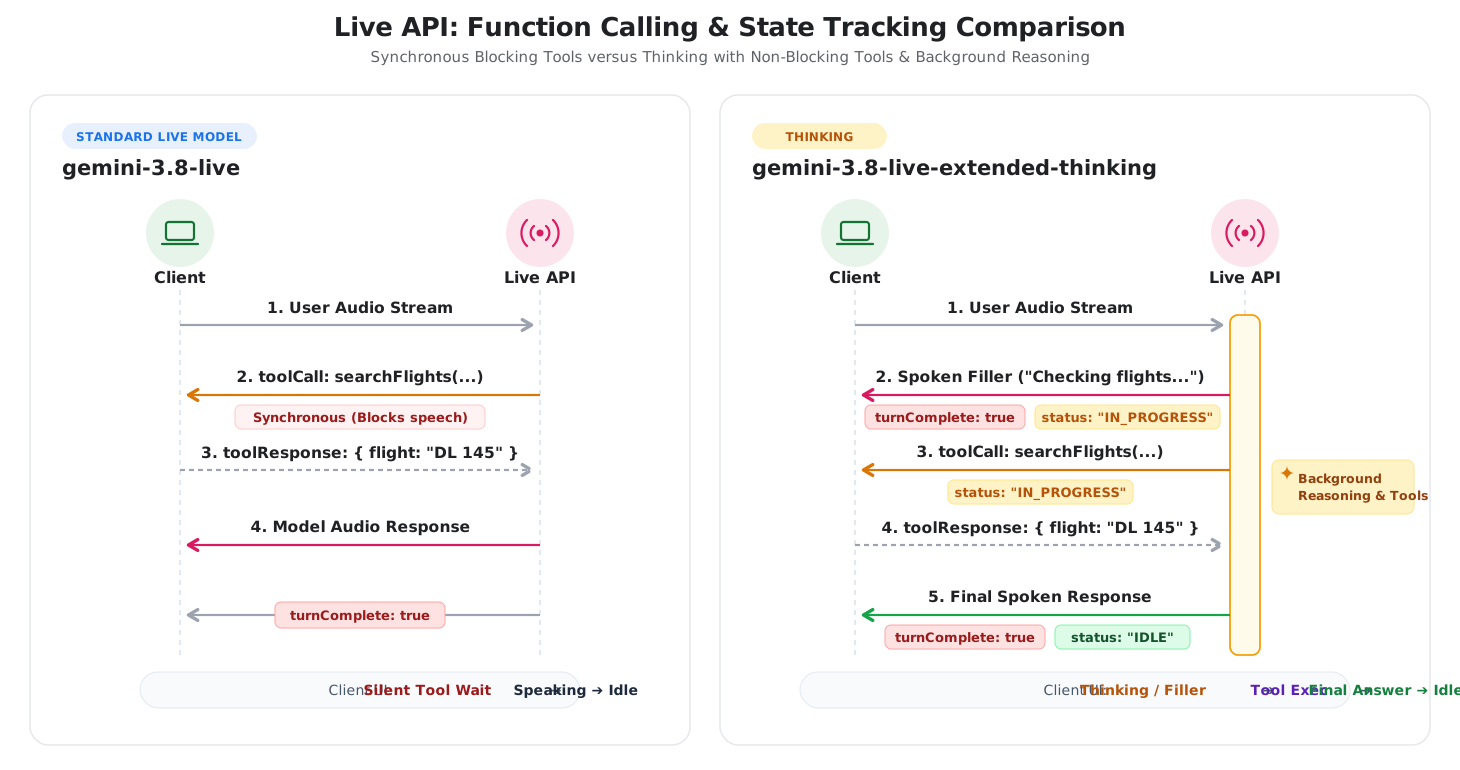
La función Thinking in the Live API (gemini-3.8-live-extended-thinking) agrega razonamiento en segundo plano a las sesiones de voz en tiempo real. El modelo planifica y llama a herramientas asíncronas en segundo plano mientras habla con expresiones de relleno naturales para mantener activa la interacción.
Esta arquitectura cambia el ciclo de vida de la conversación de dos maneras clave:
- Rellenos conversacionales: El modelo dice actualizaciones intermedias (como "Ahora estoy verificando las opciones de vuelos") mientras ejecuta herramientas en segundo plano.
- Seguimiento del estado de la interacción: Debido a que el modelo puede hablar varias veces durante una sola solicitud, el servidor emite
interaction_status: "IN_PROGRESS"durante el procesamiento en segundo plano yinteraction_status: "IDLE"cuando se completa la tarea general.
En el siguiente diagrama, se comparan los ciclos de vida de la interacción entre las sesiones de voz en vivo estándar y la función Pensar con razonamiento en segundo plano:
Cómo elegir el modelo adecuado
Cuando decidas entre gemini-3.8-live y gemini-3.8-live-extended-thinking, ten en cuenta tres consideraciones principales: la latencia de respuesta, la complejidad de la tarea y el control del estado del cliente.
Cuándo usar Gemini 3.8 Live
Usa gemini-3.8-live para agentes de voz conversacionales de baja latencia en los que es esencial el intercambio inmediato de turnos y las tareas son directas.
- Asistentes de voz conversacionales: Clasificación de la atención al cliente, práctica de idiomas, búsqueda por voz y narración interactiva.
- Ejecución rápida de herramientas: Flujos de trabajo en los que las herramientas externas responden en milisegundos (por ejemplo, leer valores de sensores o controlar dispositivos inteligentes).
- Lógica del cliente simple: Aplicaciones en las que cada turno del usuario recibe una sola respuesta del modelo y
turnComplete: trueindica de manera confiable cuando la sesión está inactiva.
Cuándo usar Gemini 3.8 Live Extended Thinking
Usa gemini-3.8-live-extended-thinking cuando tu agente deba evaluar datos complejos, planificar varios pasos o controlar herramientas que tardan varios segundos en ejecutarse.
- Diagnóstico y asistencia de varios pasos: Los agentes de asistencia técnica diagnostican problemas del sistema en varios registros, códigos de error y verificaciones de configuración.
- Recuperación de datos coordinada: Agentes de viajes y reservas que buscan vuelos, consultan hoteles y comparan precios en llamadas a la API paralelas
- Tutoría de STEM y programación: Agentes educativos que verifican fórmulas, depuran código o trabajan con lógica de varios pasos antes de dar una explicación.
- Latencia de la herramienta de enmascaramiento: Experiencias de voz en las que las funciones de larga duración crearían un silencio incómodo para el usuario.
Resumen de las diferencias clave
En la siguiente tabla, se resumen las diferencias técnicas entre ambos modelos:
| Función | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Casos de uso principales | Agentes de voz de baja latencia, comandos directos y herramientas rápidas | Resolución de problemas de varios pasos, planificación compleja, flujos de trabajo con múltiples herramientas |
| Extremo del modelo | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Arquitectura de razonamiento | Razonamiento intercalado con perfil de latencia fijo (no se admite thinking_level) |
Razonamiento en segundo plano configurable (thinking_level: low, medium, high; MINIMAL no admitido) |
| Límites de giros | turnComplete: true cierra el turno y vuelve al estado de inactividad |
turnComplete: true finaliza una expresión; interaction_status controla el ciclo de vida de la sesión |
| Rellenos conversacionales | El modelo espera la ejecución de la herramienta antes de hablar | El modelo transmite las palabras de relleno conversacionales intermedias mientras procesa la información. |
| Ejecución de la herramienta | Admite herramientas síncronas (BLOCKING) y asíncronas (NON_BLOCKING). |
Requiere declaraciones de herramientas asíncronas (NON_BLOCKING) |
Rutas de integración y migración
Sigue estos pasos para actualizar las aplicaciones de voz existentes o integrar Thinking en tus sesiones de la API de Live.
Actualización de Gemini 3.1 Flash Live
En el caso de las aplicaciones de voz existentes que usan gemini-3.1-flash-live-preview, la actualización a gemini-3.8-live requiere que se actualice la cadena del modelo y se omita thinking_level (o thinking_config) de la configuración, ya que thinking_level no es compatible con gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
El ciclo de vida del turno y los indicadores de turnComplete siguen siendo idénticos.
Adopting Thinking
Para adoptar gemini-3.8-live-extended-thinking, actualiza tres puntos de integración:
Seguimiento de
interaction_statusen lugar deturnComplete: En las sesiones de Thinking, el modelo puede emitir marcadores de conversación intermedios mientras razona. Inspecciona el campointeraction_statusen los mensajes entrantes del servidor para administrar el estado de la IU. Solo vuelve al estado de inactividad cuandointeraction_statusesIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Declara funciones que no bloqueen: Establece
"behavior": "NON_BLOCKING"en todas las declaraciones de funciones. Los modelos de pensamiento ejecutan herramientas de forma asíncrona en segundo plano mientras transmiten actualizaciones verbales. Las herramientas de bloqueo síncrono devuelven un error.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Configura la profundidad del razonamiento: Establece
thinking_configen la configuración de tu sesión para ajustar los niveles de razonamiento (low,mediumohigh;MINIMALno admitido).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Comparación de protocolos en paralelo
En esta sección, se comparan los mensajes de WebSocket que se intercambian durante cada fase de una sesión de la API de Live.
Paso 1: Configuración de la sesión
Ambos modelos se conectan al mismo extremo de WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Idéntica: URL de WebSocket y autenticación de clave de API.
- Cadena del modelo:
gemini-3.8-liveen comparación congemini-3.8-live-extended-thinking. - Configuración de pensamiento: Thinking agrega
thinkingConfigpara ajustar la profundidad del razonamiento. Comportamiento de la herramienta: Thinking requiere
"behavior": "NON_BLOCKING"en las declaraciones de funciones.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Ambos modelos reciben la misma confirmación del servidor al conectarse:
{
  "setupComplete": {}
}
Paso 2: Entrada de audio del usuario
La transmisión de audio es idéntica en ambos modelos. Los fragmentos de audio PCM sin procesar de 16 kHz en tiempo real se transmiten con realtimeInput de la siguiente manera:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Paso 3: Ciclo de vida de la respuesta y el estado del modelo
Ambos modelos transmiten fragmentos de audio PCM de 24 kHz en serverContent.modelTurn. Sin embargo, la administración del ciclo de vida difiere en los siguientes aspectos:
Flujo de respuesta de Gemini 3.8 Live
- El servidor transmite fragmentos de audio para el turno.
- El servidor envía
turnComplete: true, lo que indica que el modelo terminó de hablar y que la sesión está inactiva.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Flujo de respuesta de Gemini 3.8 Live Extended Thinking
- Relleno hablado: El modelo emite voz intermedia (como "Verificando vuelos a Seattle…") con
turnComplete: trueyinteractionStatus: "IN_PROGRESS". - Llamada a herramienta asíncrona: El servidor emite la llamada a herramienta mientras
interactionStatuspermanece como"IN_PROGRESS", lo que indica que el servidor está procesando activamente el turno de varios pasos y esperando la respuesta de la herramienta. - Respuesta de la herramienta: El cliente ejecuta la función y devuelve el resultado.
- Respuesta final: El servidor entrega la respuesta completa con
turnComplete: trueyinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Ejemplos de implementación del SDK
En los siguientes ejemplos, se muestra cómo configurar Thinking y controlar interaction_status con el SDK de GenAI de Google.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
¿Qué sigue?
- Lee las páginas de los modelos Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking.
- Consulta la tabla de comparación de modelos para obtener comparaciones detalladas de las funciones en todos los modelos de la API de Live.
- Obtén más información sobre la llamada a función en la guía de uso de la herramienta de API en vivo.
- Revisa la administración de sesiones para controlar la reanudación de sesiones y el ciclo de vida del contexto.