

API Gemini Live обеспечивает двустороннюю голосовую связь в режиме реального времени с моделями Gemini.
Стандартные голосовые модели хорошо подходят для мгновенного диалога. Вы говорите модели, и она сразу же генерирует голосовой ответ. Но когда запрос требует планирования, сложного анализа или использования внешних инструментов, прямые ответы достигают предела. Модель должна либо отвечать без объяснений, либо молча ждать завершения работы инструментов.
Функция Thinking in the Live API ( gemini-3.8-live-extended-thinking ) добавляет фоновое логическое мышление к голосовым сессиям в реальном времени. Модель планирует и вызывает асинхронные инструменты в фоновом режиме, одновременно произнося естественные разговорные фразы-паразиты, чтобы поддерживать активное взаимодействие.
Эта архитектура изменяет жизненный цикл диалога двумя ключевыми способами:
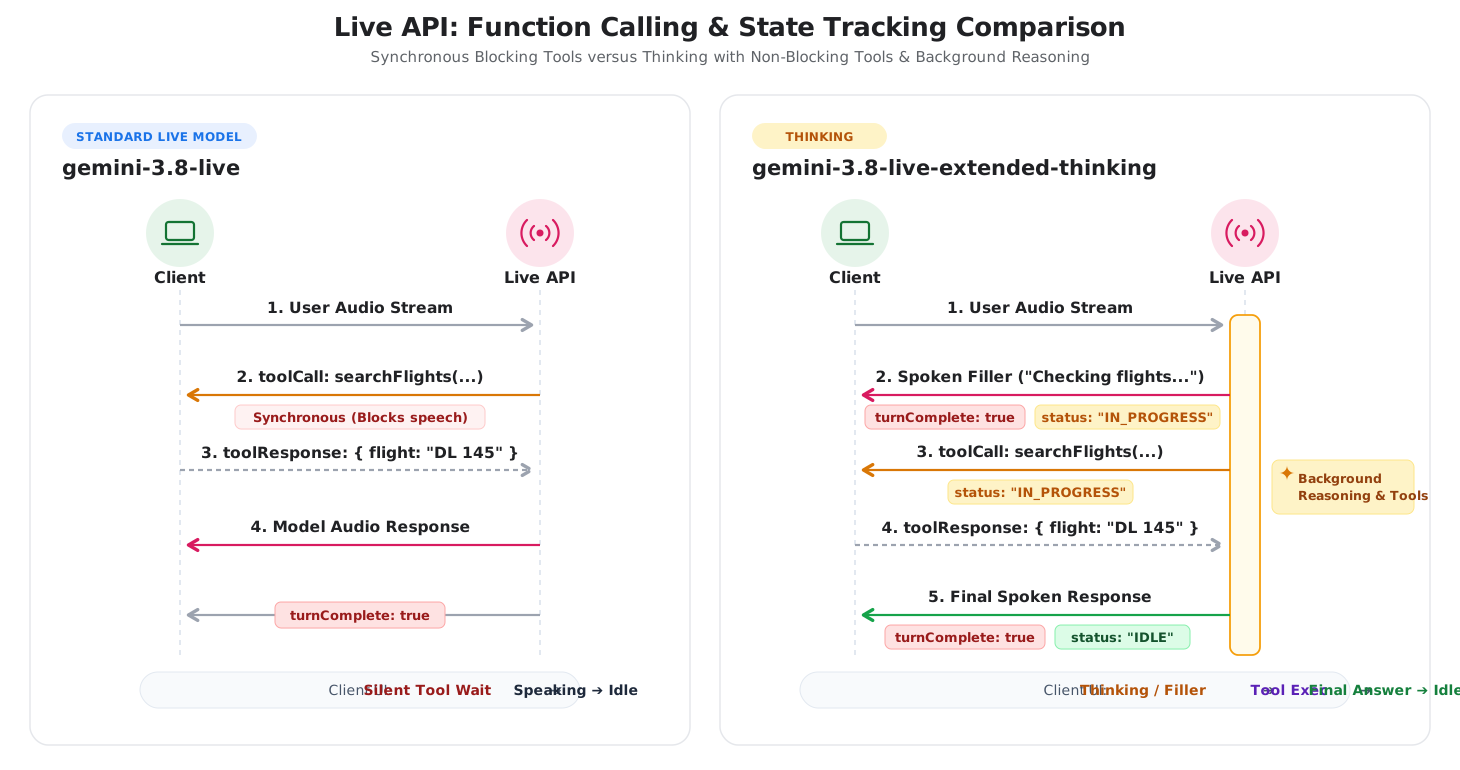
- Вводные фразы в диалогах : Модель озвучивает промежуточные обновления (например, "Проверяю варианты рейсов"), одновременно выполняя инструменты в фоновом режиме.
- Отслеживание статуса взаимодействия : Поскольку модель может произносить несколько раз за один запрос, сервер отправляет
interaction_status: "IN_PROGRESS"во время фоновой обработки иinteraction_status: "IDLE"после завершения всей задачи.
На следующей диаграмме сравниваются циклы взаимодействия между стандартными сеансами голосовой связи в реальном времени и сеансами, основанными на логическом мышлении:
Выбор подходящей модели
При выборе между gemini-3.8-live и gemini-3.8-live-extended-thinking следует учитывать три основных фактора: задержку ответа, сложность задачи и обработку состояния клиента.
Когда использовать Gemini 3.8 Live?
Используйте gemini-3.8-live для голосовых агентов с низкой задержкой, где важна немедленная смена реплик и задачи выполняются напрямую.
- Разговорные голосовые помощники : сортировка обращений клиентов, языковая практика, голосовой поиск и интерактивное повествование.
- Быстрое выполнение инструментов : рабочие процессы, в которых внешние инструменты возвращают результат в течение миллисекунд (например, считывание показаний датчиков или управление интеллектуальными устройствами).
- Простая клиентская логика : приложения, в которых каждый ход пользователя получает один ответ от модели, а
turnComplete: trueнадежно сигнализирует о том, что сессия неактивна.
Когда использовать Gemini 3.8 Live Extended Thinking
Используйте gemini-3.8-live-extended-thinking когда вашему агенту необходимо оценить сложные данные, спланировать несколько шагов или работать с инструментами, выполнение которых занимает несколько секунд.
- Многоэтапная диагностика и поддержка : специалисты технической поддержки диагностируют проблемы системы на основе анализа множества журналов, кодов ошибок и проверок конфигурации.
- Скоординированный поиск данных : туристические и бронирующие агенты, которые ищут авиабилеты, запрашивают информацию об отелях и сравнивают цены с помощью параллельных вызовов API.
- Обучение STEM-дисциплинам и программированию : образовательные агенты, которые проверяют формулы, отлаживают код или разбирают многоэтапную логику, прежде чем дать объяснение.
- Задержка инструмента маскировки : В случаях, когда длительно работающие функции создают неловкую тишину для слушателя.
Краткое описание ключевых различий
В следующей таблице приведены технические различия между обеими моделями:
| Особенность | Gemini 3.8 Live | Близнецы 3.8 Живи расширенным мышлением |
|---|---|---|
| Основные варианты использования | Голосовые агенты с низкой задержкой, прямые команды, быстрые инструменты. | Многоэтапное решение проблем, комплексное планирование, многоинструментальные рабочие процессы. |
| Конечная точка модели | gemini-3.8-live | gemini-3.8-live-extended-thinking |
| Архитектура рассуждений | Чередование рассуждений с фиксированным профилем задержки ( thinking_level не поддерживается) | Настраиваемый уровень фонового анализа ( thinking_level : low , medium , high ; MINIMAL не поддерживается) |
| Границы поворота | turnComplete: true завершает поворот и возвращается в режим ожидания. | turnComplete: true завершает реплику; interaction_status управляет жизненным циклом сессии. |
| Разговорные слова-паразиты | Модель ожидает выполнения инструмента, прежде чем начать говорить. | Модель обрабатывает промежуточные диалоговые реплики в процессе выполнения. |
| Выполнение инструмента | Поддерживает синхронные ( BLOCKING ) и асинхронные ( NON_BLOCKING ) инструменты. | Требуется объявление асинхронных ( NON_BLOCKING ) инструментов. |
Пути миграции и интеграции
Выполните следующие шаги, чтобы обновить существующие голосовые приложения или интегрировать Thinking в ваши сеансы Live API.
Обновление с Gemini 3.1 Flash Live
Для существующих голосовых приложений, использующих gemini-3.1-flash-live-preview , обновление до gemini-3.8-live требует обновления строки модели и исключения thinking_level (или thinking_config ) из конфигурации настройки, поскольку thinking_level не поддерживается для gemini-3.8-live :
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Сигналы "жизненный цикл поворота" и turnComplete остаются идентичными.
Принятие мышления
Для внедрения gemini-3.8-live-extended-thinking необходимо обновить три точки интеграции:
Отслеживайте
interaction_statusвместоturnComplete: в сессиях мышления модель может генерировать промежуточные диалоговые вставки во время рассуждений. Проверяйте полеinteraction_statusво входящих сообщениях сервера для управления состоянием пользовательского интерфейса. Возвращайтесь в состояние ожидания только тогда, когдаinteraction_statusимеет значениеIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Объявление неблокирующих функций : установите
"behavior": "NON_BLOCKING"для всех объявлений функций. Модели мышления запускают инструменты асинхронно в фоновом режиме, одновременно передавая словесные обновления. Синхронные блокирующие инструменты возвращают ошибку.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Настройка глубины рассуждений : установите
thinking_configв конфигурации сессии, чтобы отрегулировать уровни рассуждений (low,mediumилиhigh;MINIMALне поддерживается).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Сравнительный анализ протоколов
В этом разделе сравниваются сообщения WebSocket, которыми обмениваются на каждом этапе сеанса работы с Live API.
Шаг 1: Настройка сессии
Обе модели подключаются к одной и той же точке доступа WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Идентичные параметры : аутентификация по URL-адресу WebSocket и ключу API.
- Строка модели :
gemini-3.8-liveversusgemini-3.8-live-extended-thinking. - Настройка мышления : Функция ThinkingConfig добавляет
thinkingConfigдля регулировки глубины рассуждений. Поведение инструмента : Для мышления требуется
"behavior": "NON_BLOCKING"при объявлении функций.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Близнецы 3.8 Живи расширенным мышлением
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Обе модели получают одинаковое подтверждение от сервера при подключении:
{
  "setupComplete": {}
}
Шаг 2: Ввод аудиоданных пользователем
Потоковая передача аудиосигнала одинакова для обеих моделей. Передача аудиофрагментов PCM в реальном времени с частотой 16 кГц осуществляется с помощью realtimeInput :
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Шаг 3: Моделирование отклика и жизненного цикла состояний
Обе модели передают аудиофрагменты PCM с частотой 24 кГц в serverContent.modelTurn . Однако управление жизненным циклом различается:
Gemini 3.8 Последовательность обработки ответов в реальном времени
- Сервер транслирует аудиофрагменты для каждого хода.
- Сервер отправляет сообщение
turnComplete: true, указывающее на то, что модель закончила говорить и сессия находится в режиме ожидания.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Gemini 3.8 Live Extended Thinking response flow
- Вставка в речь : Модель произносит промежуточные фразы (например, "Проверка рейсов в Сиэтл..." ) с
turnComplete: trueиinteractionStatus: "IN_PROGRESS". - Асинхронный вызов инструмента : Сервер отправляет вызов инструмента, пока
interactionStatusостается"IN_PROGRESS", указывая на то, что сервер активно обрабатывает многошаговый процесс и ожидает ответа от инструмента. - Ответ инструмента : Клиент выполняет функцию и возвращает результат.
- Окончательный ответ : Сервер выдает полный ответ с
turnComplete: trueиinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
примеры реализации SDK
В следующих примерах показано, как настроить Thinking и обрабатывать interaction_status с помощью SDK Google GenAI.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Что дальше?
- Ознакомьтесь со страницами, посвященными модели Gemini 3.8 Live и модели расширенного мышления Gemini 3.8 Live .
- Для получения подробной информации о сравнении функций всех моделей Live API ознакомьтесь с таблицей сравнения моделей .
- Подробнее о вызове функций можно узнать в руководстве по использованию инструмента Live API .
- Пересмотрите управление сессиями для обеспечения возможности возобновления сессии и управления жизненным циклом контекста.