

L'API Gemini Live permet des conversations vocales bidirectionnelles en temps réel avec les modèles Gemini.
Les modèles vocaux standards fonctionnent bien pour les dialogues immédiats. Vous parlez au modèle, et il génère immédiatement une réponse vocale. Toutefois, lorsque la demande nécessite une planification, une analyse complexe ou des outils externes, les réponses directes atteignent une limite. Le modèle doit répondre sans raisonnement ou faire une pause silencieuse en attendant que les outils se terminent.
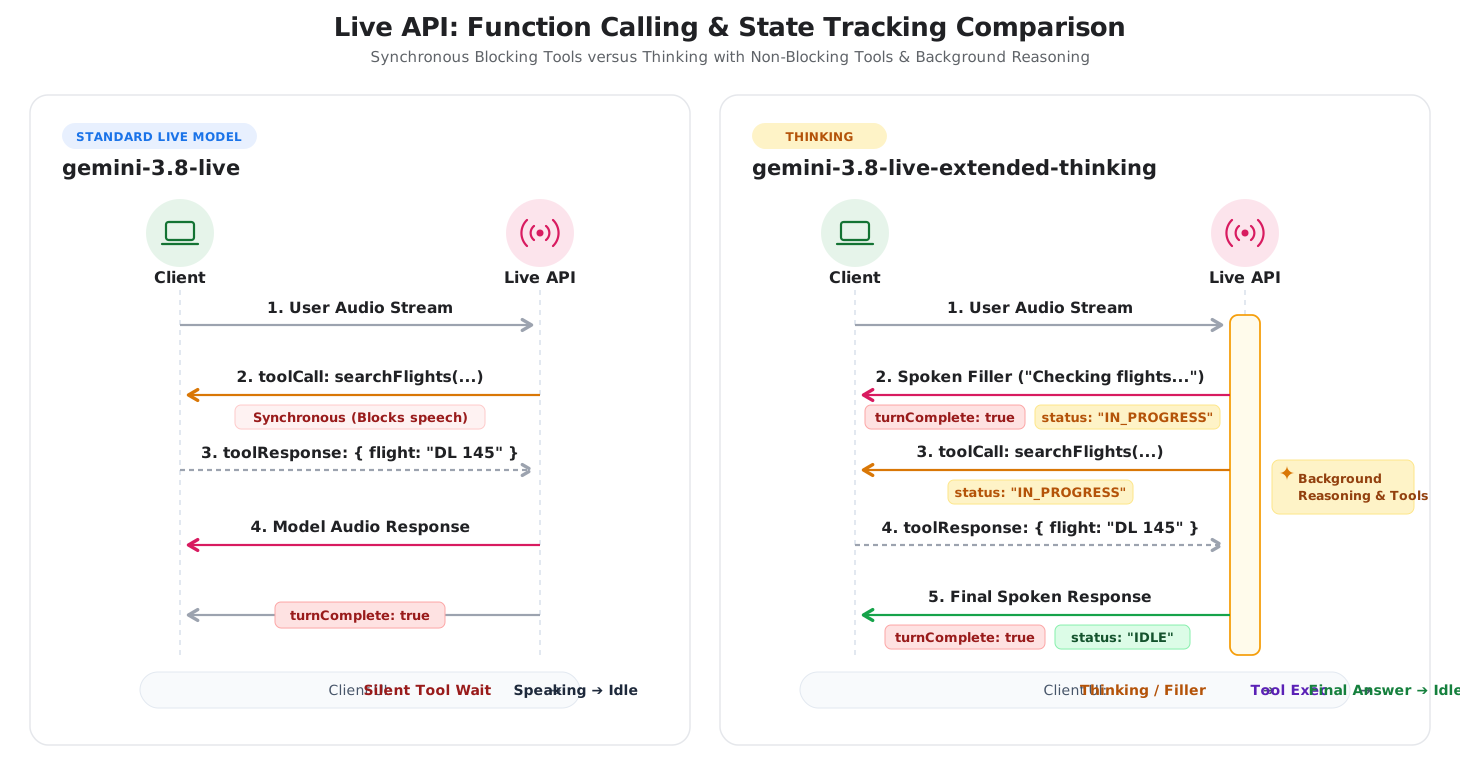
La fonctionnalité Thinking in the Live API (gemini-3.8-live-extended-thinking) ajoute un raisonnement en arrière-plan aux sessions vocales en temps réel. Le modèle planifie et appelle des outils asynchrones en arrière-plan tout en utilisant des expressions de remplissage naturelles pour maintenir l'interaction active.
Cette architecture modifie le cycle de vie conversationnel de deux manières principales :
- Remplisseurs conversationnels : le modèle fournit des informations intermédiaires (par exemple, "Recherche des options de vol en cours") lorsqu'il exécute des outils en arrière-plan.
- Suivi de l'état de l'interaction : étant donné que le modèle peut parler plusieurs fois au cours d'une même requête, le serveur émet
interaction_status: "IN_PROGRESS"lors du traitement en arrière-plan etinteraction_status: "IDLE"lorsque la tâche globale est terminée.
Le diagramme suivant compare les cycles de vie des interactions entre les sessions vocales Live standards et la fonctionnalité Réflexion avec raisonnement en arrière-plan :
Choisir le bon modèle
Lorsque vous choisissez entre gemini-3.8-live et gemini-3.8-live-extended-thinking, tenez compte de trois principaux facteurs : la latence de réponse, la complexité de la tâche et la gestion de l'état du client.
Quand utiliser Gemini 3.8 Live
Utilisez gemini-3.8-live pour les agents vocaux conversationnels à faible latence où l'alternance immédiate est essentielle et les tâches directes.
- Assistants vocaux conversationnels : triage du service client, entraînement linguistique, recherche vocale et storytelling interactif.
- Exécution rapide des outils : workflows dans lesquels les outils externes renvoient des résultats en quelques millisecondes (par exemple, lecture des valeurs des capteurs ou contrôle des appareils connectés).
- Logique client simple : applications dans lesquelles chaque tour d'utilisateur reçoit une seule réponse du modèle et où
turnComplete: truesignale de manière fiable quand la session est inactive.
Quand utiliser Gemini 3.8 Live Extended Thinking
Utilisez gemini-3.8-live-extended-thinking lorsque votre agent doit évaluer des données complexes, planifier plusieurs étapes ou gérer des outils qui mettent plusieurs secondes à s'exécuter.
- Diagnostics et assistance en plusieurs étapes : agents de l'assistance technique diagnostiquant les problèmes système dans plusieurs journaux, codes d'erreur et vérifications de configuration.
- Récupération coordonnée des données : agents de voyage et de réservation qui recherchent des vols, interrogent des hôtels et comparent les prix lors d'appels d'API parallèles.
- Tutorat en STEM et en programmation : agents pédagogiques qui vérifient les formules, déboguent le code ou suivent une logique en plusieurs étapes avant de fournir une explication.
- Latence de l'outil de masquage : expériences vocales dans lesquelles les fonctions à longue durée d'exécution créeraient autrement un silence gênant pour l'auditeur.
Récapitulatif des principales différences
Le tableau suivant résume les différences techniques entre les deux modèles :
| Fonctionnalité | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Principaux cas d'utilisation | Agents vocaux à faible latence, commandes directes, outils rapides | Résolution de problèmes en plusieurs étapes, planification complexe, workflows multi-outils |
| Point de terminaison du modèle | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Architecture de raisonnement | Raisonnement entrelacé avec profil de latence fixe (thinking_level non accepté) |
Raisonnement en arrière-plan configurable (thinking_level : low, medium, high ; MINIMAL non pris en charge) |
| Définir des limites | turnComplete: true ferme le tour et revient à l'état inactif |
turnComplete: true termine une énonciation ; interaction_status contrôle le cycle de vie de la session |
| Mots de remplissage | Le modèle attend l'exécution de l'outil avant de parler | Le modèle diffuse des mots de remplissage intermédiaires pendant le traitement |
| Exécution d'outils | Compatible avec les outils synchrones (BLOCKING) et asynchrones (NON_BLOCKING) |
Nécessite des déclarations d'outils asynchrones (NON_BLOCKING) |
Chemins de migration et d'intégration
Suivez ces étapes pour mettre à niveau les applications vocales existantes ou intégrer Thinking à vos sessions Live API.
Passer de Gemini 3.1 Flash Live
Pour les applications vocales existantes utilisant gemini-3.1-flash-live-preview, la mise à niveau vers gemini-3.8-live nécessite de mettre à jour la chaîne de modèle et d'omettre thinking_level (ou thinking_config) de votre configuration, car thinking_level n'est pas compatible avec gemini-3.8-live :
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Le cycle de vie des tours et les signaux turnComplete restent identiques.
Adopter la pensée
Pour adopter gemini-3.8-live-extended-thinking, mettez à jour trois points d'intégration :
Suivi de
interaction_statusau lieu deturnComplete: dans les sessions de réflexion, le modèle peut émettre des mots de remplissage conversationnels intermédiaires pendant le raisonnement. Inspectez le champinteraction_statusdans les messages serveur entrants pour gérer l'état de l'UI. Ne revenir à l'état inactif que lorsqueinteraction_statusest défini surIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Déclarer des fonctions non bloquantes : définissez
"behavior": "NON_BLOCKING"sur toutes les déclarations de fonctions. Les modèles de réflexion exécutent les outils de manière asynchrone en arrière-plan tout en diffusant des mises à jour verbales. Les outils de blocage synchrone renvoient une erreur.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Configurer la profondeur du raisonnement : définissez
thinking_configdans la configuration de votre session pour ajuster les niveaux de raisonnement (low,mediumouhigh;MINIMALn'est pas pris en charge).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Comparaison côte à côte des protocoles
Cette section compare les messages WebSocket échangés lors de chaque phase d'une session Live API.
Étape 1 : Configuration de la session
Les deux modèles se connectent au même point de terminaison WebSocket :
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identique : URL WebSocket et authentification par clé API.
- Chaîne de modèle :
gemini-3.8-livecontregemini-3.8-live-extended-thinking. - Configuration de la réflexion : la réflexion ajoute
thinkingConfigpour ajuster la profondeur du raisonnement. Comportement de l'outil : la réflexion nécessite
"behavior": "NON_BLOCKING"sur les déclarations de fonctions.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Les deux modèles reçoivent le même accusé de réception du serveur lors de la connexion :
{
  "setupComplete": {}
}
Étape 2 : Saisie audio de l'utilisateur
Le streaming audio est identique sur les deux modèles. Les blocs audio PCM bruts de 16 kHz en temps réel sont diffusés en streaming à l'aide de realtimeInput :
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Étape 3 : Réponse du modèle et cycle de vie de l'état
Les deux modèles diffusent des blocs audio PCM à 24 kHz au format serverContent.modelTurn. Toutefois, la gestion du cycle de vie est différente :
Flux de réponse Gemini 3.8 Live
- Le serveur diffuse des blocs audio pour le tour.
- Le serveur envoie
turnComplete: true, ce qui indique que le modèle a fini de parler et que la session est inactive.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Flux de réponse Gemini 3.8 Live Extended Thinking
- Remplissage vocal : le modèle émet un discours intermédiaire (par exemple, "Recherche de vols pour Seattle…") avec
turnComplete: trueetinteractionStatus: "IN_PROGRESS". - Appel d'outil asynchrone : le serveur émet l'appel d'outil tandis que
interactionStatusreste"IN_PROGRESS", ce qui indique que le serveur traite activement le tour en plusieurs étapes et attend la réponse de l'outil. - Réponse de l'outil : le client exécute la fonction et renvoie le résultat.
- Réponse finale : le serveur fournit la réponse complète avec
turnComplete: trueetinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Exemples d'implémentation du SDK
Les exemples suivants montrent comment configurer la réflexion et gérer interaction_status à l'aide du SDK Google GenAI.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Étape suivante
- Consultez les pages des modèles Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking.
- Consultez le tableau Comparaison des modèles pour comparer en détail les fonctionnalités de tous les modèles de l'API Live.
- Pour en savoir plus sur l'appel de fonction, consultez le guide Utilisation de l'outil API Live.
- Consultez la section Gestion des sessions pour gérer la reprise de session et le cycle de vie du contexte.