

L'API Gemini Live consente conversazioni vocali bidirezionali in tempo reale con i modelli Gemini.
I modelli vocali standard sono ideali per dialoghi immediati. Parli con il modello, che genera subito una risposta vocale. Tuttavia, quando una richiesta richiede pianificazione, analisi complesse o strumenti esterni, le risposte dirette raggiungono un limite. Il modello deve rispondere senza ragionamento o mettere in pausa silenziosamente in attesa del completamento degli strumenti.
La funzionalità Pensa in Live API (gemini-3.8-live-extended-thinking) aggiunge un ragionamento
di base alle sessioni vocali in tempo reale. Il modello pianifica e chiama strumenti asincroni in background mentre pronuncia riempitivi conversazionali naturali per mantenere attiva l'interazione.
Questa architettura modifica il ciclo di vita conversazionale in due modi principali:
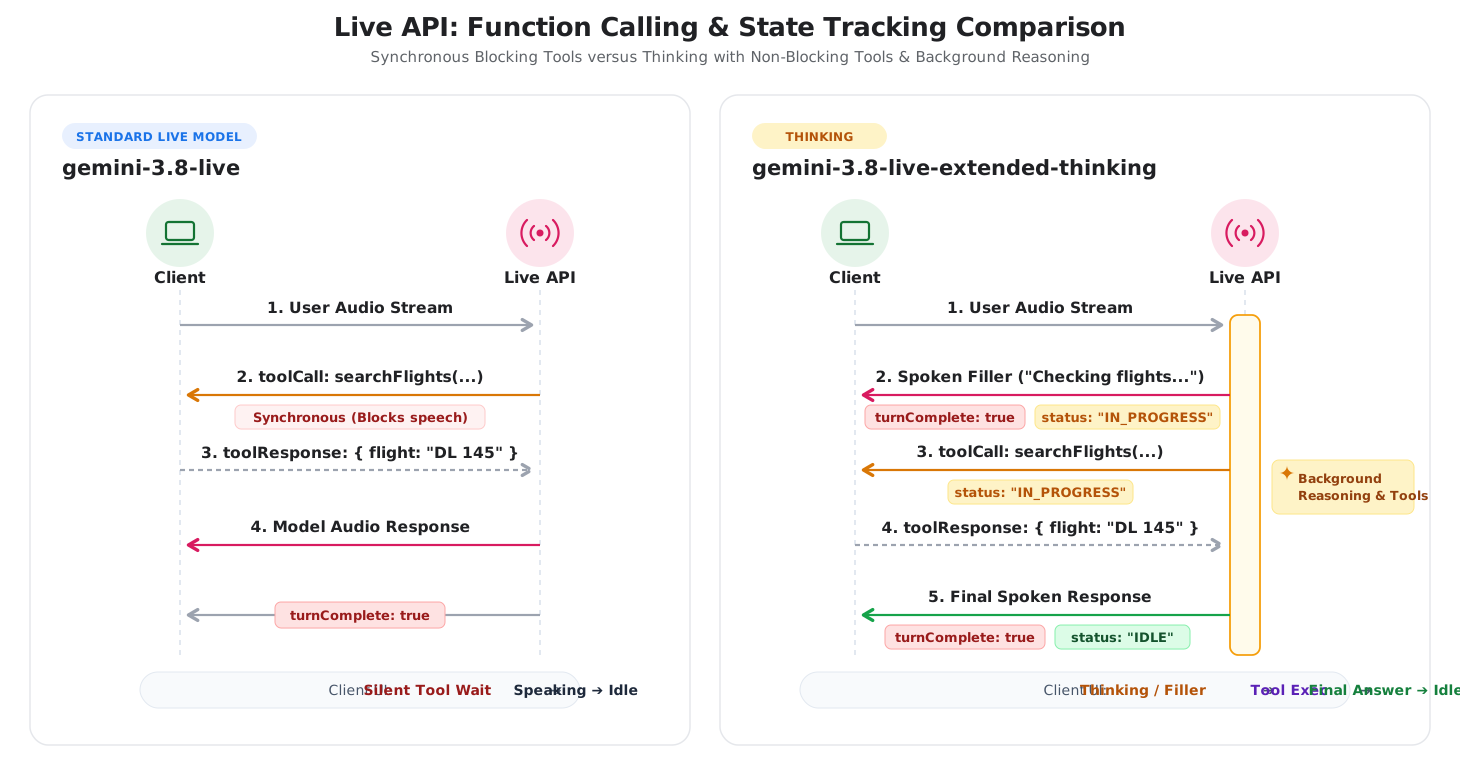
- Riempitivi conversazionali: il modello pronuncia aggiornamenti intermedi (ad esempio "Controllo delle opzioni di volo in corso") mentre esegue gli strumenti in background.
- Monitoraggio dello stato dell'interazione: poiché il modello può parlare più volte
durante una singola richiesta, il server emette
interaction_status: "IN_PROGRESS"durante l'elaborazione in background einteraction_status: "IDLE"al termine dell'attività complessiva.
Il seguente diagramma confronta i cicli di vita dell'interazione tra le sessioni vocali standard di Live e Thinking con il ragionamento in background:
Scegliere il modello giusto
Quando scegli tra gemini-3.8-live e gemini-3.8-live-extended-thinking, valuta tre aspetti principali: latenza di risposta, complessità dell'attività e gestione dello stato del client.
Quando utilizzare Gemini 3.8 Live
Utilizza gemini-3.8-live per gli agenti vocali conversazionali a bassa latenza in cui
l'alternanza immediata è essenziale e le attività sono dirette.
- Assistenti vocali conversazionali: triage dell'assistenza clienti, pratica linguistica, ricerca vocale e narrazione interattiva.
- Esecuzione rapida degli strumenti: flussi di lavoro in cui gli strumenti esterni vengono restituiti in millisecondi (ad esempio la lettura dei valori dei sensori o il controllo dei dispositivi smart).
- Logica client semplice: applicazioni in cui ogni turno dell'utente riceve una singola risposta del modello e
turnComplete: truesegnala in modo affidabile quando la sessione è inattiva.
Quando utilizzare Gemini 3.8 Live Extended Thinking
Utilizza gemini-3.8-live-extended-thinking quando l'agente deve valutare dati complessi, pianificare più passaggi o gestire strumenti che richiedono diversi secondi per l'esecuzione.
- Diagnostica e assistenza in più fasi: gli agenti dell'assistenza tecnica diagnosticano problemi di sistema in più log, codici di errore e controlli di configurazione.
- Recupero coordinato dei dati: agenti di viaggi e prenotazioni che cercano voli, interrogano gli hotel e confrontano i prezzi in chiamate API parallele.
- Tutoraggio di materie STEM e programmazione: agenti didattici che verificano formule, eseguono il debug del codice o lavorano su una logica in più passaggi prima di fornire una spiegazione.
- Latenza dello strumento di mascheramento: esperienze vocali in cui le funzioni di lunga durata altrimenti creerebbero un silenzio imbarazzante per l'ascoltatore.
Riepilogo delle differenze principali
La seguente tabella riassume le differenze tecniche tra i due modelli:
| Funzionalità | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Casi d'uso principali | Agenti vocali a bassa latenza, comandi diretti, strumenti veloci | Risoluzione di problemi in più fasi, pianificazione complessa, workflow multi-strumento |
| Endpoint del modello | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Architettura di ragionamento | Ragionamento intercalato con profilo di latenza fissa (thinking_level non supportato) |
Ragionamento in background configurabile (thinking_level: low, medium, high; MINIMAL non supportato) |
| Attivare i confini | turnComplete: true chiude il turno e torna inattivo |
turnComplete: true termina un'espressione; interaction_status controlla il ciclo di vita della sessione |
| Riempitivi conversazionali | Il modello attende l'esecuzione dello strumento prima di parlare | Il modello riproduce i riempitivi conversazionali intermedi durante l'elaborazione |
| Esecuzione dello strumento | Supporta strumenti sincroni (BLOCKING) e asincroni (NON_BLOCKING) |
Richiede dichiarazioni asincrone (NON_BLOCKING) degli strumenti |
Percorsi di migrazione e integrazione
Segui questi passaggi per eseguire l'upgrade delle applicazioni vocali esistenti o integrare Thinking nelle sessioni dell'API Live.
Eseguire l'upgrade da Gemini 3.1 Flash Live
Per le applicazioni vocali esistenti che utilizzano gemini-3.1-flash-live-preview, l'upgrade
a gemini-3.8-live richiede l'aggiornamento della stringa del modello e l'omissione
di thinking_level (o thinking_config) dalla configurazione, in quanto
thinking_level non è supportato per gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Il ciclo di vita del turno e gli indicatori turnComplete rimangono identici.
Adopting Thinking
Per adottare gemini-3.8-live-extended-thinking, aggiorna tre punti di integrazione:
Traccia
interaction_statusanzichéturnComplete: durante le sessioni di Thinking, il modello può emettere riempitivi conversazionali intermedi durante il ragionamento. Ispeziona il campointeraction_statusnei messaggi del server in entrata per gestire lo stato dell'interfaccia utente. Torna inattivo solo quandointeraction_statusèIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Dichiara funzioni non bloccanti: imposta
"behavior": "NON_BLOCKING"su tutte le dichiarazioni di funzioni. I modelli di pensiero eseguono gli strumenti in modo asincrono in background durante lo streaming degli aggiornamenti verbali. Gli strumenti di blocco sincrono restituiscono un errore.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Configura la profondità del ragionamento: imposta
thinking_confignella configurazione della sessione per regolare i livelli di ragionamento (low,mediumohigh;MINIMALnon è supportato).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Confronto fianco a fianco dei protocolli
Questa sezione confronta i messaggi WebSocket scambiati durante ogni fase di una sessione dell'API Live.
Passaggio 1: configurazione della sessione
Entrambi i modelli si connettono allo stesso endpoint WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identico: autenticazione tramite URL WebSocket e chiave API.
- Stringa del modello:
gemini-3.8-liverispetto agemini-3.8-live-extended-thinking. - Configurazione del ragionamento: il ragionamento aggiunge
thinkingConfigper regolare la profondità del ragionamento. Comportamento dello strumento: il pensiero richiede
"behavior": "NON_BLOCKING"nelle dichiarazioni di funzioni.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Entrambi i modelli ricevono lo stesso riconoscimento del server al momento della connessione:
{
  "setupComplete": {}
}
Passaggio 2: input audio dell'utente
Lo streaming audio è identico su entrambi i modelli. I blocchi audio PCM grezzi a 16 kHz in tempo reale
vengono trasmessi in streaming utilizzando realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Passaggio 3: ciclo di vita della risposta e dello stato del modello
Entrambi i modelli trasmettono in streaming blocchi audio PCM a 24 kHz in serverContent.modelTurn. Tuttavia,
la gestione del ciclo di vita è diversa:
Flusso di risposta live di Gemini 3.8
- Il server trasmette in streaming i blocchi audio per il turno.
- Il server invia
turnComplete: true, indicando che il modello ha finito di parlare e la sessione è inattiva.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Flusso di risposta di Gemini 3.8 Live Extended Thinking
- Riempitivo parlato: il modello emette un discorso intermedio (ad esempio
"Controllo dei voli per Seattle…") con
turnComplete: trueeinteractionStatus: "IN_PROGRESS". - Chiamata allo strumento asincrona: il server emette la chiamata allo strumento mentre
interactionStatusrimane"IN_PROGRESS", a indicare che il server sta elaborando attivamente il turno in più passaggi e attende la risposta dello strumento. - Risposta dello strumento: il client esegue la funzione e restituisce l'output.
- Risposta finale: il server fornisce la risposta completa con
turnComplete: trueeinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Esempi di implementazione dell'SDK
Gli esempi seguenti mostrano come configurare Thinking e gestire
interaction_status utilizzando l'SDK Google GenAI.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Passaggi successivi
- Leggi le pagine dei modelli Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking.
- Consulta la tabella Confronto modelli per confronti dettagliati delle funzionalità tra tutti i modelli dell'API Live.
- Scopri di più sulla chiamata di funzione nella guida all'utilizzo dello strumento API live.
- Consulta Gestione delle sessioni per gestire la ripresa della sessione e il ciclo di vita del contesto.