

Gemini Live API memungkinkan percakapan suara dua arah secara real-time dengan model Gemini.
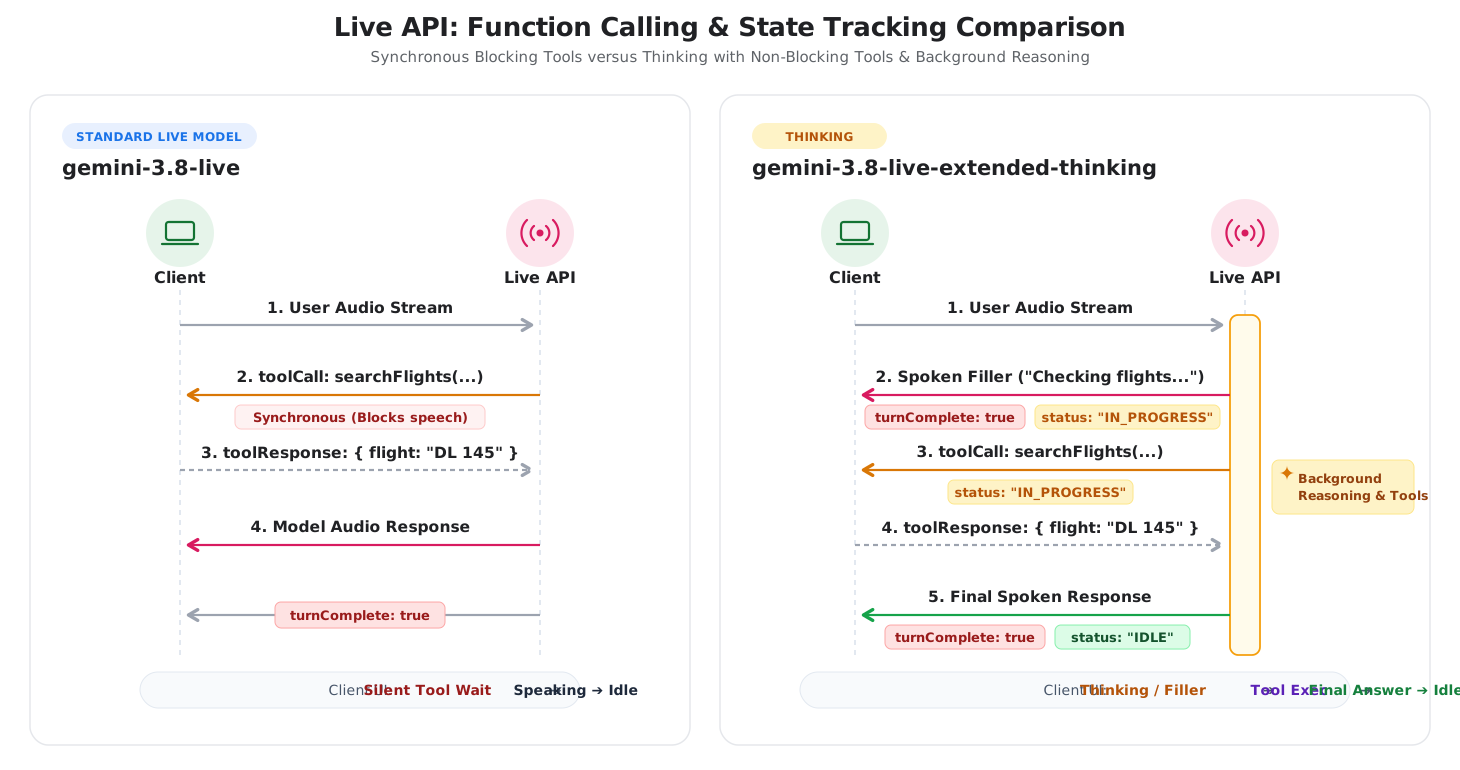
Model suara standar berfungsi dengan baik untuk dialog bolak-balik langsung. Anda berbicara kepada model, dan model akan langsung menghasilkan respons lisan. Namun, saat permintaan memerlukan perencanaan, analisis yang kompleks, atau alat eksternal, respons langsung akan mencapai batasnya. Model harus menjawab tanpa memberikan penalaran atau berhenti sejenak tanpa bersuara sambil menunggu alat selesai.
Berpikir di Live API (gemini-3.8-live-extended-thinking) menambahkan penalaran
latar belakang ke sesi suara real-time. Model ini merencanakan dan memanggil alat asinkron di latar belakang sambil mengucapkan pengisi percakapan alami untuk menjaga interaksi tetap aktif.
Arsitektur ini mengubah siklus proses percakapan dalam dua cara utama:
- Pengisi percakapan: Model mengucapkan pembaruan sementara (seperti "Sedang memeriksa opsi penerbangan") saat menjalankan alat di latar belakang.
- Pelacakan status interaksi: Karena model dapat berbicara beberapa kali
selama satu permintaan, server memancarkan
interaction_status: "IN_PROGRESS"selama pemrosesan di latar belakang daninteraction_status: "IDLE"saat tugas keseluruhan selesai.
Diagram berikut membandingkan siklus proses interaksi antara sesi Live Voice standar dan Berpikir dengan penalaran latar belakang:
Memilih model yang tepat
Saat memutuskan antara gemini-3.8-live dan gemini-3.8-live-extended-thinking,
pertimbangkan tiga hal utama: latensi respons, kompleksitas tugas, dan penanganan status klien.
Kapan menggunakan Gemini 3.8 Live
Gunakan gemini-3.8-live untuk agen suara percakapan latensi rendah yang memerlukan pergantian giliran secara langsung dan tugas yang jelas.
- Asisten suara percakapan: Triase layanan pelanggan, latihan bahasa, penelusuran suara, dan bercerita interaktif.
- Eksekusi alat yang cepat: Alur kerja saat alat eksternal ditampilkan dalam milidetik (seperti membaca nilai sensor atau mengontrol perangkat smart).
- Logika klien sederhana: Aplikasi yang setiap giliran pengguna menerima satu respons model, dan
turnComplete: truememberi sinyal yang andal saat sesi tidak aktif.
Kapan menggunakan Gemini 3.8 Live Extended Thinking
Gunakan gemini-3.8-live-extended-thinking saat agen Anda harus mengevaluasi data yang kompleks, merencanakan beberapa langkah, atau menangani alat yang memerlukan waktu beberapa detik untuk dijalankan.
- Diagnostik dan dukungan multi-langkah: Agen dukungan teknis mendiagnosis masalah sistem di beberapa log, kode error, dan pemeriksaan konfigurasi.
- Pengambilan data yang terkoordinasi: Agen perjalanan dan pemesanan yang menelusuri penerbangan, mengkueri hotel, dan membandingkan harga di seluruh panggilan API paralel.
- Bimbingan STEM dan coding: Agen pendidikan yang memverifikasi formula, men-debug kode, atau memproses logika multi-langkah sebelum memberikan penjelasan.
- Latensi alat masking: Pengalaman suara yang fungsi jangka panjangnya akan menciptakan keheningan yang canggung bagi pendengar.
Ringkasan perbedaan utama
Tabel berikut merangkum perbedaan teknis antara kedua model:
| Fitur | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Kasus penggunaan utama | Agen suara latensi rendah, perintah langsung, alat cepat | Pemecahan masalah multi-langkah, perencanaan kompleks, alur kerja multialat |
| Endpoint model | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Arsitektur penalaran | Penalaran berselang-seling dengan profil latensi tetap (thinking_level tidak didukung) |
Alasan latar belakang yang dapat dikonfigurasi (thinking_level: low, medium, high; MINIMAL tidak didukung) |
| Belokan batas | turnComplete: true menutup giliran dan kembali ke status tidak ada aktivitas |
turnComplete: true menyelesaikan ucapan; interaction_status mengontrol siklus proses sesi |
| Pengisi percakapan | Model menunggu eksekusi alat sebelum berbicara | Model mengalirkan pengisi percakapan sementara saat memproses |
| Eksekusi alat | Mendukung alat sinkron (BLOCKING) dan asinkron (NON_BLOCKING) |
Memerlukan deklarasi alat asinkron (NON_BLOCKING) |
Jalur migrasi dan integrasi
Ikuti langkah-langkah berikut untuk mengupgrade aplikasi suara yang ada atau mengintegrasikan Thinking ke sesi Live API Anda.
Mengupgrade dari Gemini 3.1 Flash Live
Untuk aplikasi suara yang sudah ada yang menggunakan gemini-3.1-flash-live-preview, mengupgrade
ke gemini-3.8-live memerlukan pembaruan string model dan penghapusan
thinking_level (atau thinking_config) dari konfigurasi penyiapan Anda, karena
thinking_level tidak didukung untuk gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Siklus proses belokan dan sinyal turnComplete tetap identik.
Mengadopsi Pemikiran
Untuk menerapkan gemini-3.8-live-extended-thinking, perbarui tiga titik integrasi:
Melacak
interaction_status, bukanturnComplete: Dalam sesi Berpikir, model dapat mengeluarkan pengisi percakapan perantara saat melakukan penalaran. Periksa kolominteraction_statuspada pesan server masuk untuk mengelola status UI. Hanya kembali ke status tidak ada aktivitas saatinteraction_statusadalahIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Mendeklarasikan fungsi non-blocking: Tetapkan
"behavior": "NON_BLOCKING"pada semua deklarasi fungsi. Model pemikiran menjalankan alat secara asinkron di latar belakang sambil melakukan streaming pembaruan verbal. Alat pemblokiran sinkron menampilkan error.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Mengonfigurasi kedalaman penalaran: Tetapkan
thinking_configdi konfigurasi sesi Anda untuk menyesuaikan tingkat penalaran (low,medium, atauhigh;MINIMALtidak didukung).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Perbandingan protokol berdampingan
Bagian ini membandingkan pesan WebSocket yang dipertukarkan selama setiap fase sesi Live API.
Langkah 1: Penyiapan sesi
Kedua model terhubung ke endpoint WebSocket yang sama:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identik: Autentikasi URL WebSocket dan kunci API.
- String model:
gemini-3.8-liveversusgemini-3.8-live-extended-thinking. - Konfigurasi penalaran: Penalaran menambahkan
thinkingConfiguntuk menyesuaikan kedalaman penalaran. Perilaku alat: Pemikiran memerlukan
"behavior": "NON_BLOCKING"pada deklarasi fungsi.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Kedua model menerima pengakuan server yang sama saat terhubung:
{
  "setupComplete": {}
}
Langkah 2: Input audio pengguna
Streaming audio identik di kedua model. Chunk audio PCM mentah 16 kHz real-time
di-streaming menggunakan realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Langkah 3: Respons model dan siklus proses status
Kedua model ini melakukan streaming potongan audio PCM 24 kHz dalam serverContent.modelTurn. Namun, pengelolaan siklus proses berbeda:
Alur respons Gemini 3.8 Live
- Server melakukan streaming potongan audio untuk giliran.
- Server mengirim
turnComplete: true, yang menunjukkan bahwa model telah selesai berbicara dan sesi tidak aktif.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Alur respons Penalaran yang Diperluas Gemini 3.8 Live
- Pengisi lisan: Model mengeluarkan ucapan perantara (seperti
"Memeriksa penerbangan ke Seattle...") dengan
turnComplete: truedaninteractionStatus: "IN_PROGRESS". - Panggilan alat asinkron: Server memancarkan panggilan alat saat
interactionStatustetap"IN_PROGRESS", yang menunjukkan bahwa server secara aktif memproses giliran multi-langkah dan menunggu respons alat. - Respons alat: Klien menjalankan fungsi dan menampilkan output.
- Respons akhir: Server memberikan jawaban lengkap dengan
turnComplete: truedaninteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Contoh penerapan SDK
Contoh berikut menunjukkan cara mengonfigurasi Pemikiran dan menangani
interaction_status menggunakan Google GenAI SDK.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Langkah berikutnya
- Baca halaman model Gemini 3.8 Live dan Gemini 3.8 Live Extended Thinking.
- Periksa tabel Perbandingan model untuk mengetahui perbandingan fitur mendetail di semua model Live API.
- Pelajari lebih lanjut panggilan fungsi dalam panduan penggunaan Alat API Langsung.
- Tinjau Pengelolaan sesi untuk menangani kelanjutan sesi dan siklus proses konteks.