

Gemini Live API는 Gemini 모델과의 실시간 양방향 음성 대화를 지원합니다.
표준 음성 모델은 즉각적인 대화에 적합합니다. 모델에 말을 걸면 모델이 즉시 음성 답장을 생성합니다. 하지만 요청에 계획, 복잡한 분석 또는 외부 도구가 필요한 경우 직접 응답에는 한계가 있습니다. 모델은 추론 없이 대답하거나 도구가 완료될 때까지 조용히 일시중지해야 합니다.
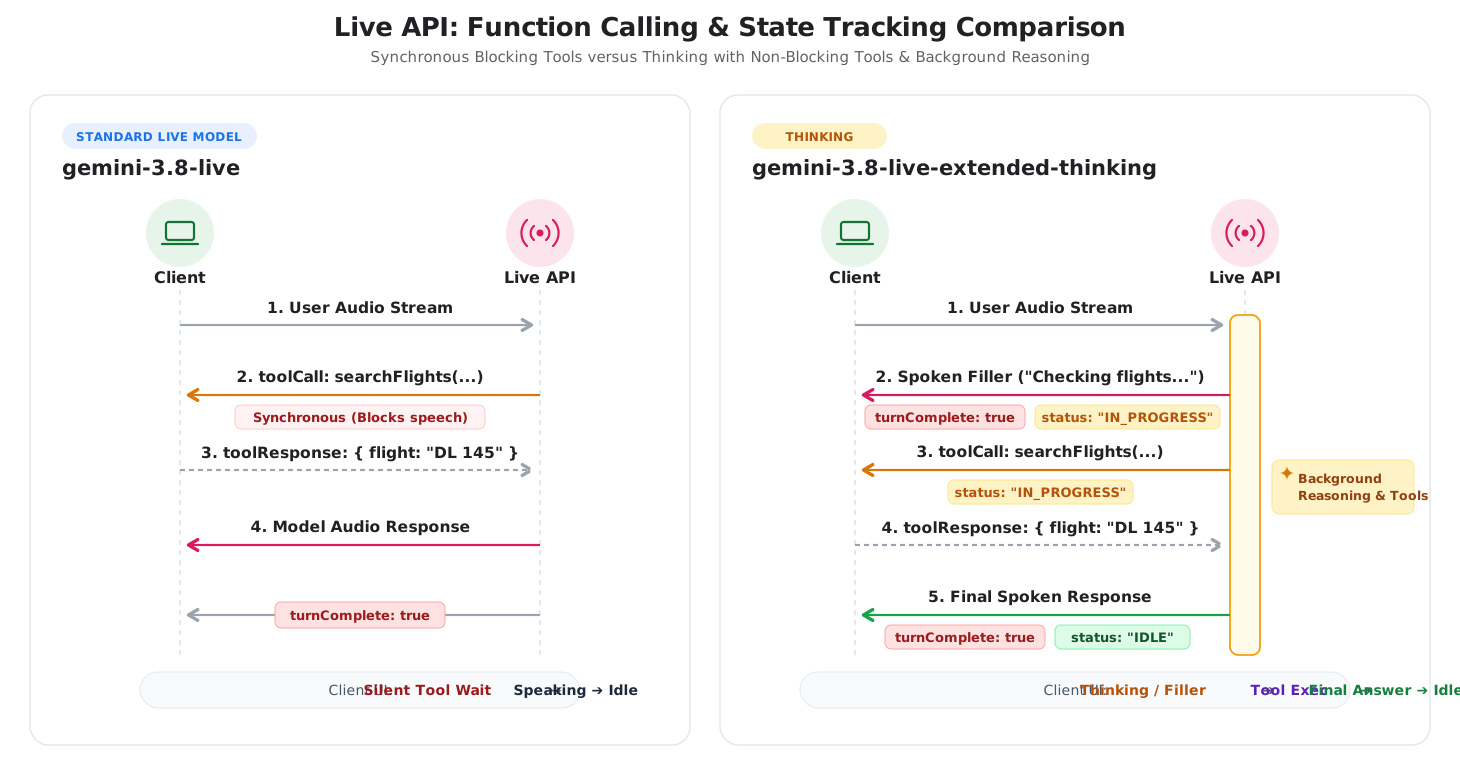
Live API (gemini-3.8-live-extended-thinking)를 사용하면 실시간 음성 세션에 백그라운드 추론이 추가됩니다. 모델은 상호작용을 활성 상태로 유지하기 위해 자연스러운 대화형 필러를 말하는 동안 백그라운드에서 비동기 도구를 계획하고 호출합니다.
이 아키텍처는 다음과 같은 두 가지 주요 방식으로 대화 수명 주기를 변경합니다.
- 대화형 필러: 모델이 백그라운드에서 도구를 실행하는 동안 중간 업데이트('항공편 옵션을 확인하는 중입니다' 등)를 말합니다.
- 상호작용 상태 추적: 모델은 단일 요청 중에 여러 번 말할 수 있으므로 서버는 백그라운드 처리 중에
interaction_status: "IN_PROGRESS"를 내보내고 전체 작업이 완료되면interaction_status: "IDLE"를 내보냅니다.
다음 다이어그램은 표준 Live 음성 세션과 백그라운드 추론을 사용한 생각하기 간의 상호작용 수명 주기를 비교합니다.
적절한 모델 선택
gemini-3.8-live와 gemini-3.8-live-extended-thinking 중에서 선택할 때는 응답 지연 시간, 작업 복잡성, 클라이언트 상태 처리라는 세 가지 주요 고려사항을 고려하세요.
Gemini 3.8 Live를 사용해야 하는 경우
즉각적인 턴 테이킹이 필수이고 작업이 직접적인 지연 시간이 짧은 대화형 음성 에이전트에는 gemini-3.8-live를 사용하세요.
- 대화형 음성 어시스턴트: 고객 서비스 분류, 언어 연습, 음성 검색, 대화형 스토리텔링
- 빠른 도구 실행: 외부 도구가 밀리초 내에 반환되는 워크플로 (예: 센서 값 읽기 또는 스마트 기기 제어)
- 간단한 클라이언트 로직: 각 사용자 턴에서 단일 모델 응답을 수신하고
turnComplete: true가 세션이 유휴 상태일 때 안정적으로 신호를 보내는 애플리케이션
Gemini 3.8 Live Extended Thinking을 사용해야 하는 경우
에이전트가 복잡한 데이터를 평가하거나, 여러 단계를 계획하거나, 실행하는 데 몇 초가 걸리는 도구를 처리해야 하는 경우 gemini-3.8-live-extended-thinking를 사용하세요.
- 다단계 진단 및 지원: 기술 지원 상담사가 여러 로그, 오류 코드, 구성 확인을 통해 시스템 문제를 진단합니다.
- 조정된 데이터 검색: 항공편을 검색하고, 호텔을 쿼리하고, 병렬 API 호출 전반에서 가격을 비교하는 여행 및 예약 에이전트
- STEM 및 코드 튜터링: 공식을 확인하거나, 코드를 디버그하거나, 다단계 로직을 실행한 후 설명을 말하는 교육 에이전트
- 마스킹 도구 지연 시간: 장기 실행 함수로 인해 청취자에게 어색한 침묵이 발생하는 음성 환경
주요 차이점 요약
다음 표에는 두 모델의 기술적 차이점이 요약되어 있습니다.
| 기능 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| 주된 사용 사례 | 지연 시간이 짧은 음성 에이전트, 직접 명령, 빠른 도구 | 다단계 문제 해결, 복잡한 계획, 멀티 도구 워크플로 |
| 모델 엔드포인트 | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| 추론 아키텍처 | 고정 지연 시간 프로필을 사용한 인터리브 추론 (thinking_level 지원되지 않음) |
구성 가능한 백그라운드 추론 (thinking_level: low, medium, high; MINIMAL 지원되지 않음) |
| 경계 켜기 | turnComplete: true는 턴을 닫고 유휴 상태로 돌아갑니다. |
turnComplete: true: 발화를 종료합니다. interaction_status: 세션 수명 주기를 제어합니다. |
| 대화형 필러 | 모델이 말하기 전에 도구 실행을 기다림 | 모델이 처리하는 동안 중간 대화형 필러를 스트리밍합니다. |
| 도구 실행 | 동기 (BLOCKING) 및 비동기 (NON_BLOCKING) 도구 지원 |
비동기 (NON_BLOCKING) 도구 선언 필요 |
마이그레이션 및 통합 경로
다음 단계에 따라 기존 음성 애플리케이션을 업그레이드하거나 Thinking을 Live API 세션에 통합하세요.
Gemini 3.1 Flash Live에서 업그레이드
gemini-3.1-flash-live-preview를 사용하는 기존 음성 애플리케이션의 경우 gemini-3.8-live로 업그레이드하려면 모델 문자열을 업데이트하고 설정 구성에서 thinking_level (또는 thinking_config)를 생략해야 합니다. thinking_level는 gemini-3.8-live에서 지원되지 않기 때문입니다.
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
턴 수명 주기와 turnComplete 신호는 동일하게 유지됩니다.
사고 채택
gemini-3.8-live-extended-thinking을 채택하려면 다음 세 가지 통합 지점을 업데이트하세요.
turnComplete대신interaction_status추적: 사고 세션에서 모델은 추론하는 동안 중간 대화형 필러를 내보낼 수 있습니다. 수신 서버 메시지의interaction_status필드를 검사하여 UI 상태를 관리합니다.interaction_status이IDLE인 경우에만 유휴 상태로 돌아갑니다.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
자바스크립트
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
차단되지 않는 함수 선언: 모든 함수 선언에서
"behavior": "NON_BLOCKING"를 설정합니다. 사고 모델은 언어 업데이트를 스트리밍하는 동안 백그라운드에서 비동기식으로 도구를 실행합니다. 동기 차단 도구는 오류를 반환합니다.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
자바스크립트
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
추론 깊이 구성: 세션 구성에서
thinking_config를 설정하여 추론 수준 (low,medium또는high,MINIMAL는 지원되지 않음)을 조정합니다.Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
자바스크립트
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
프로토콜 나란히 비교
이 섹션에서는 Live API 세션의 각 단계에서 교환되는 WebSocket 메시지를 비교합니다.
1단계: 세션 설정
두 모델 모두 동일한 WebSocket 엔드포인트에 연결됩니다.
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- 동일: WebSocket URL 및 API 키 인증입니다.
- 모델 문자열:
gemini-3.8-live대gemini-3.8-live-extended-thinking - 사고 구성: 사고 모델은
thinkingConfig를 추가하여 추론 깊이를 조정합니다. 도구 동작: 생각하려면 함수 선언에
"behavior": "NON_BLOCKING"이 필요합니다.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
두 모델 모두 연결 시 동일한 서버 확인을 수신합니다.
{
  "setupComplete": {}
}
2단계: 사용자 오디오 입력
오디오 스트리밍은 두 모델 모두 동일합니다. 실시간 16kHz 원시 PCM 오디오 청크는 realtimeInput를 사용하여 스트리밍됩니다.
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
3단계: 모델 응답 및 상태 수명 주기
두 모델 모두 serverContent.modelTurn에서 24kHz PCM 오디오 청크를 스트리밍합니다. 하지만 수명 주기 관리는 다음과 같이 다릅니다.
Gemini 3.8 실시간 대답 흐름
- 서버는 턴의 오디오 청크를 스트리밍합니다.
- 서버는 모델의 음성 출력이 완료되었고 세션이 유휴 상태임을 나타내는
turnComplete: true를 전송합니다.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Gemini 3.8 Live Extended Thinking 대답 흐름
- 구어체 필러: 모델이
turnComplete: true및interactionStatus: "IN_PROGRESS"를 사용하여 중간 음성 (예: '시애틀행 항공편을 확인하는 중입니다…')을 내보냅니다. - 비동기 도구 호출: 서버가
interactionStatus이"IN_PROGRESS"로 유지되는 동안 도구 호출을 내보냅니다. 이는 서버가 다단계 턴을 적극적으로 처리하고 도구 응답을 기다리고 있음을 나타냅니다. - 도구 응답: 클라이언트가 함수를 실행하고 출력을 반환합니다.
- 최종 응답: 서버가
turnComplete: true및interactionStatus: "IDLE"로 완전한 답변을 제공합니다.
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
SDK 구현 예
다음 예시에서는 Google 생성형 AI SDK를 사용하여 사고를 구성하고 interaction_status을 처리하는 방법을 보여줍니다.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
자바스크립트
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
다음 단계
- Gemini 3.8 Live 및 Gemini 3.8 Live Extended Thinking 모델 페이지를 읽습니다.
- 모델 비교 표에서 모든 Live API 모델의 자세한 기능 비교를 확인하세요.
- Live API 도구 사용 가이드에서 함수 호출에 대해 자세히 알아보세요.
- 세션 관리를 검토하여 세션 재개 및 컨텍스트 수명 주기를 처리합니다.