

Gemini Live API を使用すると、Gemini モデルとリアルタイムで双方向の音声会話を行うことができます。
標準音声モデルは、即時のやり取りに適しています。モデルに話しかけると、すぐに音声で返信が生成されます。ただし、リクエストに計画、複雑な分析、外部ツールが必要な場合は、直接的な回答には限界があります。モデルは、推論なしで回答するか、ツールが完了するのを待機しながら無音で一時停止する必要があります。
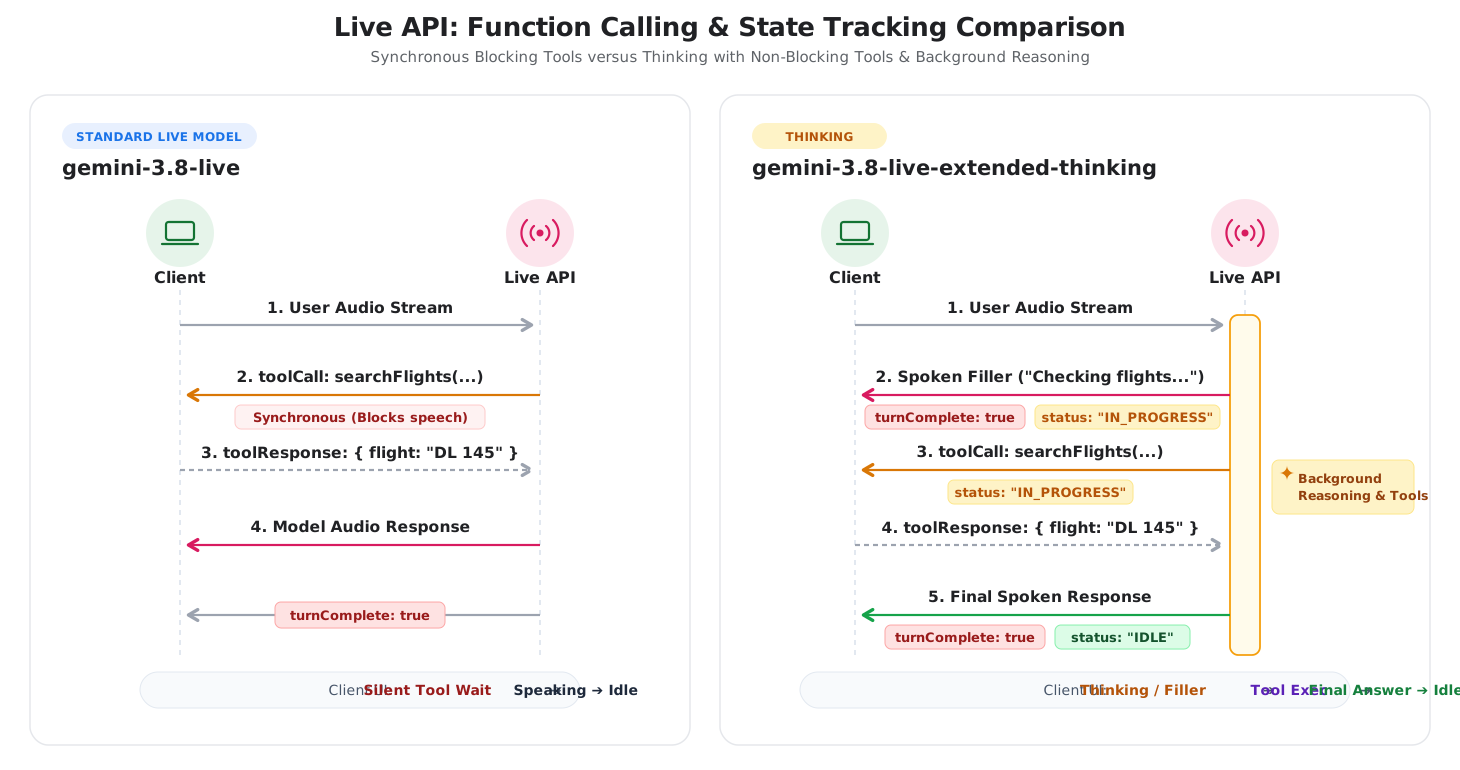
Live API(gemini-3.8-live-extended-thinking)で思考すると、リアルタイム音声セッションにバックグラウンド推論が追加されます。モデルは、自然な会話のフィラーを話しながら、バックグラウンドで非同期ツールを計画して呼び出し、インタラクションをアクティブに保ちます。
このアーキテクチャは、会話のライフサイクルを次の 2 つの点で変更します。
- 会話のつなぎ言葉: モデルは、バックグラウンドでツールを実行しながら、中間的な更新(「フライトのオプションを確認しています」など)を話します。
- インタラクション ステータスのトラッキング: モデルは 1 回のリクエストで複数回発話できるため、サーバーはバックグラウンド処理中に
interaction_status: "IN_PROGRESS"を、タスク全体が完了したときにinteraction_status: "IDLE"を出力します。
次の図は、標準のライブ音声セッションとバックグラウンド推論による思考のインタラクション ライフサイクルを比較したものです。
適切なモデルを選択する
gemini-3.8-live と gemini-3.8-live-extended-thinking のどちらを選択するかを決定する際は、応答レイテンシ、タスクの複雑さ、クライアントの状態処理という 3 つの主な考慮事項を検討します。
Gemini 3.8 Live を使用する場面
gemini-3.8-live は、すぐにターンを交代する必要があり、タスクが直接的な低レイテンシの会話型音声エージェントに使用します。
- 会話型音声アシスタント: カスタマー サービスのトリアージ、言語学習、音声検索、インタラクティブなストーリーテリング。
- 高速なツール実行: 外部ツールがミリ秒単位で戻るワークフロー(センサー値の読み取りやスマート デバイスの制御など)。
- シンプルなクライアント ロジック: 各ユーザーのターンで単一のモデル レスポンスを受け取り、セッションがアイドル状態になったときに
turnComplete: trueが確実にシグナルを送信するアプリケーション。
Gemini 3.8 Live Extended Thinking を使用するタイミング
エージェントが複雑なデータを評価したり、複数のステップを計画したり、実行に数秒かかるツールを処理したりする必要がある場合は、gemini-3.8-live-extended-thinking を使用します。
- 複数ステップの診断とサポート: 複数のログ、エラーコード、構成チェックにわたってシステムの問題を診断するテクニカル サポート エージェント。
- 調整されたデータ取得: フライトの検索、ホテルのクエリ、並列 API 呼び出しでの料金の比較を行う旅行エージェントと予約エージェント。
- STEM とコードのチューター: 数式の検証、コードのデバッグ、複数ステップのロジックの処理を行ってから説明を行う教育エージェント。
- マスキング ツールのレイテンシ: 長時間実行関数がリスナーに不自然な沈黙を生じさせる音声エクスペリエンス。
主な違いの概要
次の表に、両方のモデルの技術的な違いをまとめます。
| 機能 | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| 主なユースケース | 低レイテンシの音声エージェント、直接コマンド、高速ツール | マルチステップの問題解決、複雑な計画、マルチツール ワークフロー |
| モデル エンドポイント | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| 推論アーキテクチャ | 固定レイテンシ プロファイルを使用したインターリーブ推論(thinking_level はサポートされていません) |
構成可能なバックグラウンド推論(thinking_level: low、medium、high。MINIMAL は対象外) |
| 曲がり角の境界 | turnComplete: true はターンを終了してアイドル状態に戻ります |
turnComplete: true は発話を終了します。interaction_status はセッションのライフサイクルを制御します |
| 会話のフィラー | モデルはツール実行を待ってから発話する | 処理中に会話の中間的なフィラーをモデル化する |
| ツールの実行 | 同期(BLOCKING)ツールと非同期(NON_BLOCKING)ツールをサポート |
非同期(NON_BLOCKING)ツールの宣言が必要 |
移行と統合のパス
既存の音声アプリケーションをアップグレードするか、Thinking を Live API セッションに統合する手順は次のとおりです。
Gemini 3.1 Flash Live からのアップグレード
gemini-3.1-flash-live-preview を使用する既存の音声アプリの場合、gemini-3.8-live にアップグレードするには、モデル文字列を更新し、thinking_level が gemini-3.8-live で対象外であるため、設定構成から thinking_level(または thinking_config)を省略する必要があります。
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
ターンのライフサイクルと turnComplete シグナルは同じままです。
思考の採用
gemini-3.8-live-extended-thinking を採用するには、3 つの統合ポイントを更新します。
turnCompleteではなくinteraction_statusを追跡: 思考セッションでは、モデルは推論中に会話の中間的なフィラーを生成できます。受信したサーバー メッセージのinteraction_statusフィールドを検査して、UI の状態を管理します。interaction_statusがIDLEの場合にのみアイドル状態に戻ります。Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') { // Ready for user input setUiState('listening'); } else if (message.interactionStatus === 'IN_PROGRESS') { // Reasoning or executing tools setUiState('thinking'); }ノンブロッキング関数を宣言する: すべての関数宣言で
"behavior": "NON_BLOCKING"を設定します。思考モデルは、言葉による最新情報をストリーミングしながら、バックグラウンドでツールを非同期で実行します。同期ブロッキング ツールはエラーを返します。Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = { name: 'search_flights', description: 'Searches for available flights.', behavior: 'NON_BLOCKING', parameters: { type: 'OBJECT', properties: { destination: { type: 'STRING' }, }, required: ['destination'], }, };推論の深さを構成する: セッション構成で
thinking_configを設定して、推論レベル(low、medium、high。MINIMALはサポートされていません)を調整します。Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
プロトコルの並列比較
このセクションでは、Live API セッションの各フェーズで交換される WebSocket メッセージを比較します。
ステップ 1: セッションの設定
両方のモデルが同じ WebSocket エンドポイントに接続します。
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- 同一: WebSocket URL と API キーの認証。
- モデル文字列:
gemini-3.8-liveとgemini-3.8-live-extended-thinking。 - 思考モードの構成: 思考モードでは、推論の深さを調整するために
thinkingConfigが追加されます。 ツールの動作: 思考には関数宣言の
"behavior": "NON_BLOCKING"が必要です。
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
両方のモデルは、接続時に同じサーバー確認応答を受け取ります。
{
  "setupComplete": {}
}
ステップ 2: ユーザーの音声入力
オーディオ ストリーミングは両方のモデルで同じです。リアルタイムの 16 kHz の RAW PCM 音声チャンクは、realtimeInput を使用してストリーミングされます。
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
ステップ 3: モデルのレスポンスと状態のライフサイクル
どちらのモデルも、serverContent.modelTurn で 24 kHz の PCM 音声チャンクをストリーミングします。ただし、ライフサイクル管理は異なります。
Gemini 3.8 Live の回答フロー
- サーバーはターンの音声チャンクをストリーミングします。
- サーバーは
turnComplete: trueを送信します。これは、モデルが発話を終了し、セッションがアイドル状態であることを示します。
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Gemini 3.8 Live Extended Thinking の回答フロー
- 発話のつなぎ言葉: モデルは、
turnComplete: trueとinteractionStatus: "IN_PROGRESS"を使用して、中間的な発話(「シアトル行きのフライトを確認しています...」など)を出力します。 - 非同期ツール呼び出し: サーバーは
interactionStatusが"IN_PROGRESS"のままの状態でツール呼び出しを発行します。これは、サーバーがマルチステップ ターンをアクティブに処理し、ツールのレスポンスを待機していることを示します。 - ツール レスポンス: クライアントが関数を実行して出力を返します。
- 最終的なレスポンス: サーバーは
turnComplete: trueとinteractionStatus: "IDLE"を含む完全な回答を配信します。
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
SDK 実装の例
次の例は、Google GenAI SDK を使用して思考を構成し、interaction_status を処理する方法を示しています。
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
次のステップ
- Gemini 3.8 Live モデルページと Gemini 3.8 Live Extended Thinking モデルページをご覧ください。
- すべての Live API モデルの機能の詳細な比較については、モデル比較表をご覧ください。
- 関数呼び出しの詳細については、Live API ツールの使用ガイドをご覧ください。
- セッションの再開とコンテキストのライフサイクルを処理するには、セッション管理を確認してください。