

A API Gemini Live permite conversas de voz bidirecionais em tempo real com os modelos do Gemini.
Os modelos de voz padrão funcionam bem para diálogos imediatos. Você fala com o modelo, e ele gera uma resposta falada imediatamente. Mas quando uma solicitação exige planejamento, análise complexa ou ferramentas externas, as respostas diretas atingem um limite. O modelo precisa responder sem raciocínio ou pausar silenciosamente enquanto espera que as ferramentas terminem.
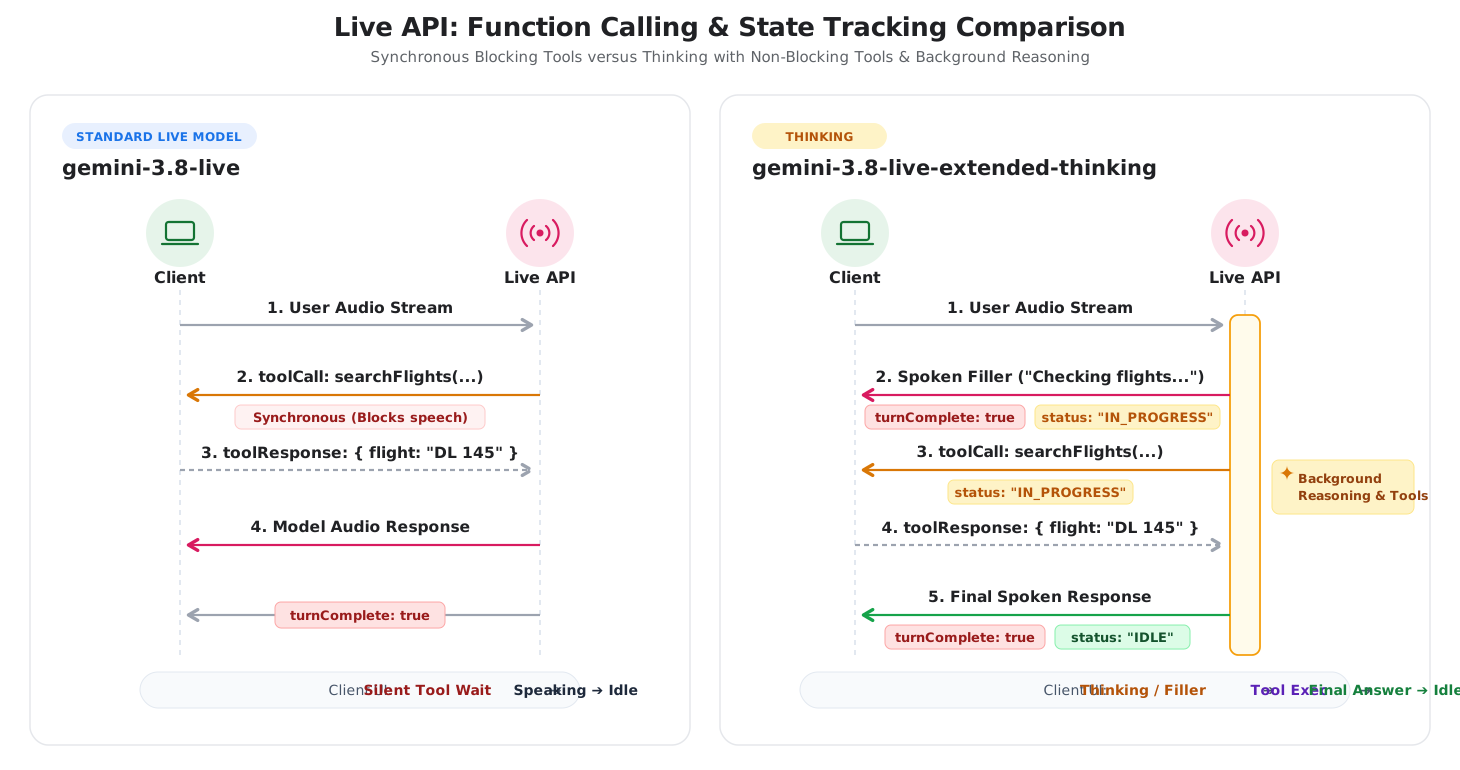
O recurso Pensando na API Live (gemini-3.8-live-extended-thinking) adiciona raciocínio em segundo plano às sessões de voz em tempo real. O modelo planeja e chama ferramentas assíncronas em segundo plano enquanto fala com marcadores de conversa naturais para manter a interação ativa.
Essa arquitetura muda o ciclo de vida da conversa de duas maneiras principais:
- Marcadores de conversa: o modelo fala atualizações intermediárias (como "Verificando opções de voo agora") enquanto executa ferramentas em segundo plano.
- Rastreamento do status da interação: como o modelo pode falar várias vezes
durante uma única solicitação, o servidor emite
interaction_status: "IN_PROGRESS"durante o processamento em segundo plano einteraction_status: "IDLE"quando a tarefa geral é concluída.
O diagrama a seguir compara os ciclos de vida de interação entre as sessões de voz padrão do Live e o recurso "Pensar com raciocínio em segundo plano":
Como escolher o modelo certo
Ao decidir entre gemini-3.8-live e gemini-3.8-live-extended-thinking, considere três fatores principais: latência de resposta, complexidade da tarefa e tratamento do estado do cliente.
Quando usar o Gemini 3.8 Live
Use gemini-3.8-live para agentes de voz conversacionais de baixa latência em que
a troca imediata de turnos é essencial e as tarefas são diretas.
- Assistentes de voz conversacionais: triagem de atendimento ao cliente, prática de idiomas, pesquisa por voz e narrativa interativa.
- Execução rápida de ferramentas: fluxos de trabalho em que ferramentas externas retornam em milissegundos (como leitura de valores de sensores ou controle de dispositivos inteligentes).
- Lógica simples do cliente: aplicativos em que cada vez que o usuário fala, ele recebe uma única resposta do modelo, e o
turnComplete: truesinaliza de forma confiável quando a sessão está inativa.
Quando usar o Gemini 3.8 Live com raciocínio estendido
Use gemini-3.8-live-extended-thinking quando o agente precisar avaliar dados complexos, planejar várias etapas ou lidar com ferramentas que levam vários segundos para serem executadas.
- Diagnóstico e suporte em várias etapas: agentes de suporte técnico diagnosticando problemas do sistema em vários registros, códigos de erro e verificações de configuração.
- Recuperação de dados coordenada: agentes de viagens e reservas que pesquisam voos, consultam hotéis e comparam preços em chamadas de API paralelas.
- Tutoria de STEM e programação: agentes educacionais que verificam fórmulas, depuram código ou trabalham com lógica de várias etapas antes de dar uma explicação.
- Latência da ferramenta de mascaramento: experiências de voz em que funções de longa duração criariam um silêncio constrangedor para o ouvinte.
Resumo das principais diferenças
A tabela a seguir resume as diferenças técnicas entre os dois modelos:
| Recurso | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Principais casos de uso | Agentes de voz de baixa latência, comandos diretos, ferramentas rápidas | Solução de problemas em várias etapas, planejamento complexo, fluxos de trabalho com várias ferramentas |
| Endpoint do modelo | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Arquitetura de raciocínio | Raciocínio intercalado com perfil de latência fixa (thinking_level indisponível) |
Raciocínio em segundo plano configurável (thinking_level: low, medium, high; MINIMAL indisponível) |
| Limites de turnos | turnComplete: true encerra o turno e volta ao estado inativo |
turnComplete: true termina uma declaração; interaction_status controla o ciclo de vida da sessão |
| Marcadores de discurso | O modelo aguarda a execução da ferramenta antes de falar | O modelo transmite preenchimentos conversacionais intermediários durante o processamento |
| Execução da ferramenta | Compatível com ferramentas síncronas (BLOCKING) e assíncronas (NON_BLOCKING) |
Requer declarações de ferramentas assíncronas (NON_BLOCKING) |
Caminhos de migração e integração
Siga estas etapas para fazer upgrade dos aplicativos de voz atuais ou integrar o Thinking às suas sessões da API Live.
Fazer upgrade do Gemini 3.1 Flash Live
Para aplicativos de voz atuais que usam gemini-3.1-flash-live-preview, a atualização
para gemini-3.8-live exige a atualização da string do modelo e a omissão de
thinking_level (ou thinking_config) da configuração, já que
thinking_level não é compatível com gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
O ciclo de vida da interação e os indicadores do turnComplete permanecem idênticos.
Adotando o Thinking
Para adotar gemini-3.8-live-extended-thinking, atualize três pontos de integração:
Acompanhe
interaction_statusem vez deturnComplete: nas sessões de pensamento, o modelo pode emitir preenchimentos de conversa intermediários enquanto raciocina. Inspecione o campointeraction_statusnas mensagens do servidor recebidas para gerenciar o estado da interface. Só retorne ao estado ocioso quandointeraction_statusforIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Declare funções não bloqueadoras: defina
"behavior": "NON_BLOCKING"em todas as declarações de função. Os modelos de pensamento executam ferramentas de forma assíncrona em segundo plano enquanto transmitem atualizações verbais. As ferramentas de bloqueio síncrono retornam um erro.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Configurar a profundidade do raciocínio: defina
thinking_configna configuração da sessão para ajustar os níveis de raciocínio (low,mediumouhigh;MINIMALnão é compatível).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Comparação lado a lado de protocolos
Esta seção compara as mensagens do WebSocket trocadas durante cada fase de uma sessão da API Live.
Etapa 1: configuração da sessão
Os dois modelos se conectam ao mesmo endpoint WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Idêntico: URL do WebSocket e autenticação da chave de API.
- String do modelo:
gemini-3.8-livexgemini-3.8-live-extended-thinking. - Configuração de raciocínio: o raciocínio adiciona
thinkingConfigpara ajustar a profundidade do raciocínio. Comportamento da ferramenta: o pensamento exige
"behavior": "NON_BLOCKING"em declarações de função.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Ambos os modelos recebem o mesmo reconhecimento do servidor ao se conectarem:
{
  "setupComplete": {}
}
Etapa 2: entrada de áudio do usuário
O streaming de áudio é idêntico nos dois modelos. Os blocos de áudio PCM bruto de 16 kHz em tempo real são transmitidos usando realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Etapa 3: ciclo de vida da resposta e do estado do modelo
Os dois modelos transmitem blocos de áudio PCM de 24 kHz em serverContent.modelTurn. No entanto, o gerenciamento do ciclo de vida é diferente:
Fluxo de resposta do Gemini 3.8 Live
- O servidor transmite partes de áudio para o turno.
- O servidor envia
turnComplete: true, indicando que o modelo terminou de falar e que a sessão está inativa.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Fluxo de resposta do raciocínio estendido do Gemini 3.8 Live
- Marcador de discurso: o modelo emite fala intermediária (como
"Verificando voos para Seattle...") com
turnComplete: trueeinteractionStatus: "IN_PROGRESS". - Chamada de ferramenta assíncrona: o servidor emite a chamada de ferramenta enquanto
interactionStatuspermanece"IN_PROGRESS", indicando que o servidor está processando ativamente o turno de várias etapas e aguardando a resposta da ferramenta. - Resposta da ferramenta: o cliente executa a função e retorna a saída.
- Resposta final: o servidor entrega a resposta completa com
turnComplete: trueeinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Exemplos de implementação do SDK
Os exemplos a seguir mostram como configurar o Thinking e processar
interaction_status usando o SDK do Google GenAI.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
A seguir
- Leia as páginas dos modelos Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking.
- Consulte a tabela Comparação de modelos para ver comparações detalhadas de recursos em todos os modelos da API Live.
- Saiba mais sobre a chamada de função no guia Uso da ferramenta de API ativa.
- Revise o Gerenciamento de sessões para lidar com a retomada de sessões e o ciclo de vida do contexto.