

Mit der Stimmreplikation können Sie die stimmlichen Merkmale eines Sprechers anhand einer kurzen Audio-Stichprobe mit dem Gemini API-Endpunkt „Voices“ (POST /v1beta/voices) replizieren. Sowohl Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) als auch Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) unterstützen die Stimmreplikation.
Die schnellste Möglichkeit, eine replizierte Stimme zu replizieren, die Einwilligung zu bestätigen und die replizierte Stimme zu testen, ist die interaktive Stimmreplizierung in Google AI Studio. Sie können Referenz- und Einwilligungsvideos direkt im Browser aufzeichnen oder hochladen, eine Vorschau der Stimme ansehen und die resultierende voice_...-ID direkt in den Code Ihrer Anwendung kopieren.
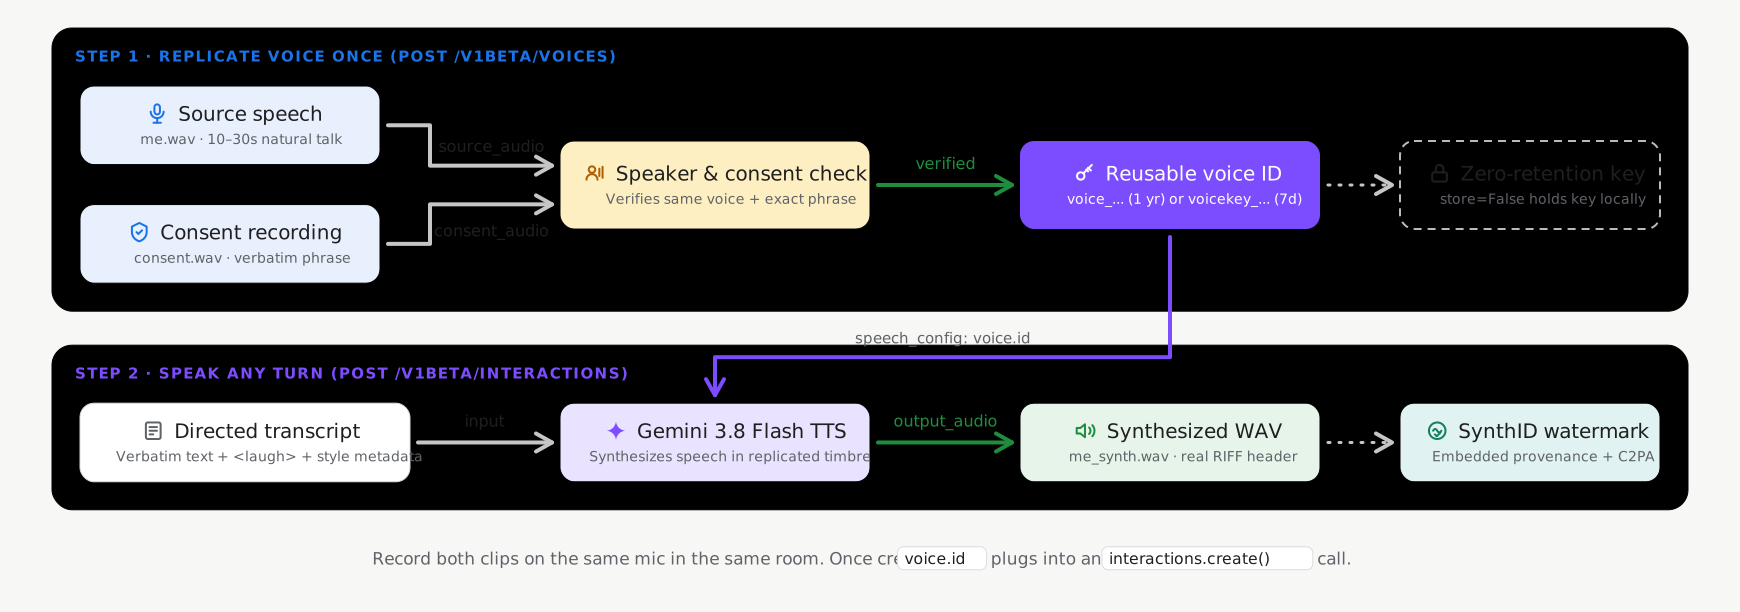
Zustandsorientierte und zustandslose Speichermodi
Die Sprachreplikation unterstützt zwei Speichermodi beim Aufrufen von voices.create (POST /v1beta/voices). Der zustandsbehaftete Speicher ist standardmäßig aktiviert:
- Zustandsbehafteter Speicher (
store=True, empfohlene Standardeinstellung): Google speichert Ihr bestätigtes Sprachprofil in Ihrem Projekt und gibt ein einfaches, dauerhaftesvoice_id(replicated_voice.id, z. B.voice_abc123...) zurück. Sie können diesesvoice_idfür Anfragen übergeben und mitvoices.list(),voices.get()undvoices.delete()verwalten. - Zustandslose vom Client verwaltete Schlüssel (
store=False, optional): Legen Sie für Arbeitslasten, bei denen keine serverseitige Speicherung biometrischer Sprachprofile erforderlich ist,store=Falsefest. Die API gibt ein verschlüsseltes, in sich geschlossenesvoice_key(replicated_voice.key, beginnend mitvoicekey_...) zurück, das Ihre Anwendung lokal speichert und direkt in Syntheseanfragen übergibt.
| Speichermodus | ID | Projektlimit | Aufbewahrung (TTL) |
|---|---|---|---|
Zustandsorientierte Stimmen (store=True) |
voice_... |
200 Stimmen pro Projekt (gemeinsam für angeforderte und replizierte Stimmen) | 1 Jahr |
Zustandslose Stimmschlüssel (store=False) |
voicekey_... |
Kundenverwaltet | 7 Tage |
Audio- und Einwilligungsanforderungen
Für jede CreateVoice-Replikationsanfrage sind zwei Audioaufnahmen von echten Menschen vom gleichen erwachsenen Sprecher erforderlich (24 kHz, Mono, 16 Bit, WAV wird empfohlen):
- Referenz-Audio (
source_audio): Ein 10–30 Sekunden langer Clip mit sauberer, natürlicher Sprache des Sprechers, dessen Stimme Sie replizieren möchten. - Audio mit Einwilligungserklärung (
consent_audio): Eine Aufnahme derselben Person, die die obligatorische Einwilligungserklärung deutlich in einer der unterstützten Sprachen vorliest (z. B. auf Deutsch): > „Ich bin der Eigentümer dieser Stimme und erkläre mich damit einverstanden, dass Google ein Sprachsynthesemodell mit dieser Stimme erstellt.“
Replizierte Stimme erstellen (zustandsbehafteter Standard)
Verwenden Sie das Google GenAI SDK (google-genai 2.25.0+ / @google/genai 2.24.0+) oder die REST API mit store=True, um ein repliziertes Sprachprofil in Ihrem Projekt zu erstellen und zu speichern:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Sprache mit Ihrer replizierten Stimme synthetisieren
Übergeben Sie das zurückgegebene id (voice_...) in Ihrer Syntheseanfrage:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Gespeicherte replizierte Stimmen verwalten
Wenn Sie mit store=True erstellt wurden, können Ihre replizierten Stimmen über die Voices API aufgelistet, gefiltert, geprüft und gelöscht werden. Weitere Informationen
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Option: Statuslose, vom Client verwaltete Sprachschlüssel (store=False)
Wenn für Ihre Anwendung keine serverseitige Speicherung von Sprachprofilen erforderlich ist, legen Sie beim Erstellen der replizierten Stimme store=False fest. Die API gibt ein verschlüsseltes voice_key (replicated_voice.key, beginnend mit voicekey_...) zurück, das Sie clientseitig speichern und direkt überall dort übergeben, wo eine voice-ID akzeptiert wird:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Unterstützte Einwilligungsformulierungen nach Sprache
Im Audio zur Einwilligung muss die genaue Erklärung in einer der 30 unterstützten Sprachen deutlich vorgelesen werden:
| Sprache | Sprache (lang_id) |
Wortwörtliche Einwilligungserklärung |
|---|---|---|
| Arabisch | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| Bengalisch | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| Chinesisch (vereinfacht) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| Niederländisch | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| English (US) | en-US |
I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model. |
| English (UK) | en-GB |
I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model. |
| Englisch (Indien) | en-IN |
I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model. |
| Englisch (Australien) | en-AU |
I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model. |
| French (France) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Französisch (Kanada) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| Deutsch | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| Gujarati | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| Hindi | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| Indonesisch | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| Italienisch | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| Japanisch | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Kannada | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| Koreanisch | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| Malayalam | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| Marathi | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| Polnisch | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| Portugiesisch (Brasilien) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| Russisch | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| Spanish (Spain) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| Spanisch (USA) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| Tamil | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| Telugu | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| Thailändisch | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| Türkisch | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| Vietnamesisch | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
Best Practices für die Aufnahme von Referenz-Audio
- In einer ruhigen Umgebung aufnehmen:Minimieren Sie Raumhall, Hintergrundgeräusche, Musik und sich überschneidende Stimmen.
- Aufnahmebedingungen abstimmen:Nehmen Sie sowohl
source_audioals auchconsent_audiomit demselben Mikrofon in derselben akustischen Umgebung auf, damit die Sprecherüberprüfung zuverlässig funktioniert. - In 24 kHz-Mono-WAV konvertieren:Für optimale Ergebnisse sollten Sie das Eingabeaudio vor der Codierung in 24 kHz-Mono-16-Bit-PCM-WAV umwandeln.
Nächste Schritte
- Weitere Informationen zum Erstellen benutzerdefinierter Identitäten aus Textbeschreibungen
- Weitere Informationen zu Stil auf Turn-Ebene, Inline-Tags und Dialogen mit mehreren Sprechern finden Sie im Leitfaden zur Sprachsynthese.