

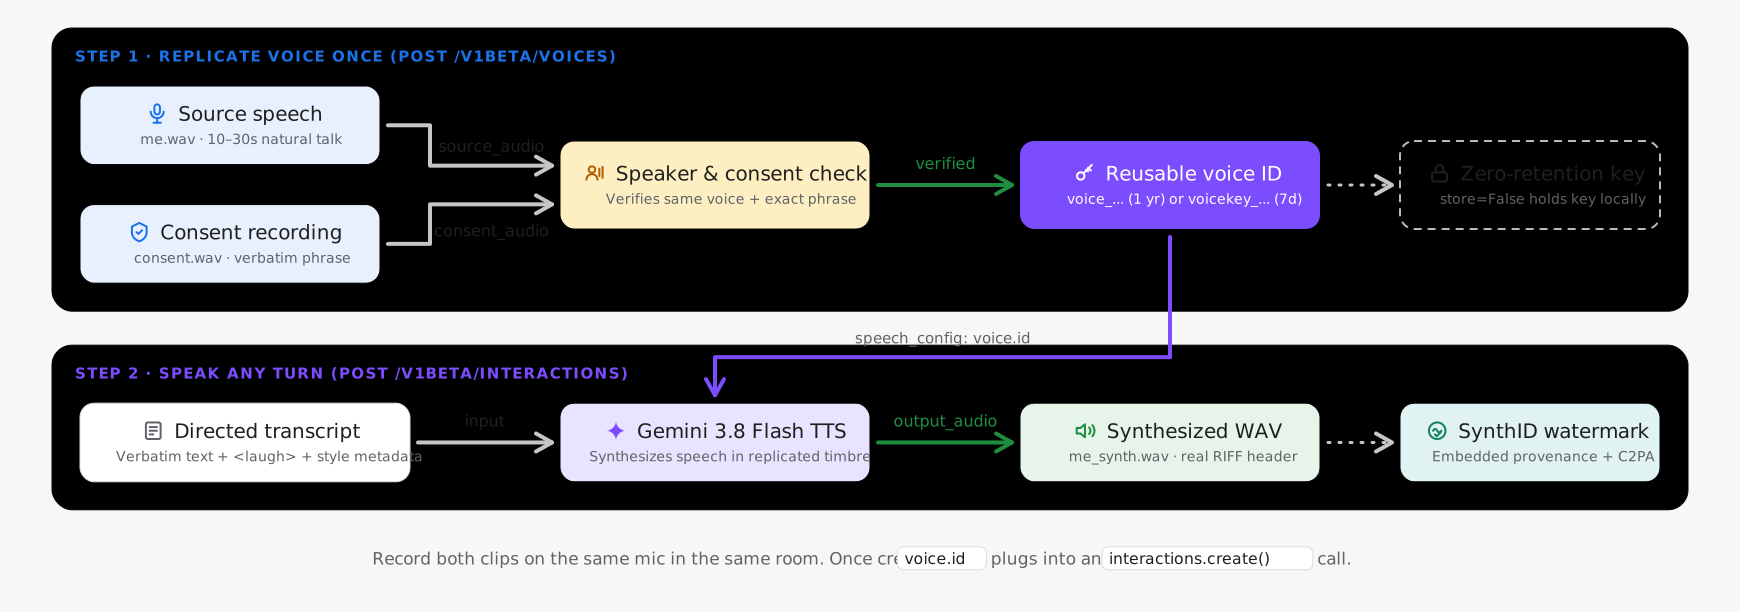
การจำลองเสียงช่วยให้คุณจำลองลักษณะเสียงร้องของลำโพงจากตัวอย่างเสียงสั้นๆ โดยใช้ปลายทางเสียงของ Gemini API (POST /v1beta/voices)
ทั้ง TTS ของ Gemini 3.8 Flash
(gemini-3.8-flash-tts) และ
TTS ของ Gemini 3.8 Flash-Lite
(gemini-3.8-flash-lite-tts) รองรับการจำลองเสียง
วิธีที่เร็วที่สุดในการจำลอง ยืนยันความยินยอม และทดสอบเสียงที่จำลองคือ
การใช้ประสบการณ์การจำลองเสียงแบบอินเทอร์แอกทีฟใน
Google AI Studio คุณสามารถบันทึก
หรืออัปโหลดคลิปอ้างอิงและคลิปความยินยอมในเบราว์เซอร์ได้โดยตรง แสดงตัวอย่าง
เสียง และคัดลอกvoice_...รหัสที่ได้ลงในโค้ดแอปพลิเคชัน
โดยตรง
โหมดพื้นที่เก็บข้อมูลแบบมีสถานะเทียบกับแบบไม่มีสถานะ
การจำลองเสียงรองรับโหมดพื้นที่เก็บข้อมูล 2 โหมดเมื่อโทร voices.create
(POST /v1beta/voices) โดยจะเปิดใช้พื้นที่เก็บข้อมูลแบบมีสถานะโดยค่าเริ่มต้น
- ที่เก็บข้อมูลแบบมีสถานะ (
store=Trueค่าเริ่มต้นที่แนะนำ): Google จะจัดเก็บโปรไฟล์เสียงที่ยืนยันแล้ว ในโปรเจ็กต์ของคุณและแสดงผลvoice_idแบบถาวรที่มีขนาดเล็ก (replicated_voice.idเช่นvoice_abc123...) คุณสามารถส่งvoice_idนี้ในคำขอต่างๆ และจัดการได้ด้วยvoices.list(),voices.get()และvoices.delete() - คีย์ที่ลูกค้าจัดการแบบไม่เก็บสถานะ (
store=Falseไม่บังคับ): สำหรับภาระงาน ที่ต้องไม่มีการคงอยู่ฝั่งเซิร์ฟเวอร์ของโปรไฟล์เสียงไบโอเมตริก ให้ตั้งค่าstore=FalseAPI จะแสดงvoice_key(replicated_voice.keyซึ่งเริ่มต้นด้วยvoicekey_...) ที่เข้ารหัสและมีข้อมูลครบถ้วน ซึ่งแอปพลิเคชันของคุณ จัดเก็บไว้ในเครื่องและส่งในคำขอการสังเคราะห์โดยตรง
| โหมดพื้นที่เก็บข้อมูล | ตัวระบุ | ขีดจำกัดของโปรเจ็กต์ | การเก็บรักษา (TTL) |
|---|---|---|---|
เสียงที่มีสถานะ (store=True) |
voice_... |
เสียง 200 เสียงต่อโปรเจ็กต์ (ใช้ร่วมกันในเสียงที่พรอมต์และจำลอง) | 1 ปี |
คีย์เสียงแบบไม่เก็บสถานะ (store=False) |
voicekey_... |
จัดการโดยไคลเอ็นต์ | 7 วัน |
ข้อกำหนดด้านเสียงและความยินยอม
CreateVoiceคำขอจำลองทุกรายการต้องมีการบันทึกเสียงจากมนุษย์จริง 2 รายการ
จากผู้พูดที่เป็นผู้ใหญ่คนเดียวกัน (แนะนำให้ใช้ WAV 16 บิตแบบโมโน 24 kHz)
- เสียงอ้างอิง (
source_audio): คลิปเสียงพูดที่ชัดเจนและเป็นธรรมชาติ จากผู้พูดที่คุณต้องการจำลองเสียง ความยาว 10-30 วินาที - เสียงความยินยอม (
consent_audio): บันทึกเสียงของบุคคลเดียวกันที่พูด ข้อความความยินยอมที่จำเป็นอย่างชัดเจนในภาษาใดภาษาหนึ่งที่ รองรับ (เช่น ภาษาอังกฤษ) > "ฉันเป็นเจ้าของเสียงนี้และยินยอมให้ Google ใช้เสียงนี้เพื่อ > สร้างรูปแบบเสียงสังเคราะห์"
สร้างเสียงที่จำลอง (ค่าเริ่มต้นแบบมีสถานะ)
ใช้ Google GenAI SDK (google-genai 2.25.0 ขึ้นไป / @google/genai 2.24.0 ขึ้นไป) หรือ REST API
กับ store=True เพื่อสร้างและบันทึกโปรไฟล์เสียงที่จำลองไว้ในโปรเจ็กต์
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
สังเคราะห์เสียงด้วยเสียงที่จำลอง
ส่ง id (voice_...) ที่ส่งคืนมาในคำขอการสังเคราะห์
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
จัดการเสียงที่จำลองแบบที่จัดเก็บไว้
เมื่อสร้างด้วย store=True คุณจะแสดง กรอง ตรวจสอบ และลบเสียงที่จำลองได้ผ่าน Voices API (ดูคลังเสียงและการกรองเพิ่มเติม
สำหรับพารามิเตอร์ตัวกรองทั้งหมด)
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
ตัวเลือก: คีย์เสียงที่จัดการโดยไคลเอ็นต์แบบไม่เก็บสถานะ (store=False)
หากแอปพลิเคชันของคุณไม่ต้องการให้มีการคงอยู่ของโปรไฟล์เสียงฝั่งเซิร์ฟเวอร์ ให้ตั้งค่า
store=False เมื่อสร้างเสียงที่จำลอง API จะแสดงvoice_keyที่เข้ารหัส (replicated_voice.key ซึ่งขึ้นต้นด้วย voicekey_...) ซึ่งคุณ
จัดเก็บไว้ฝั่งไคลเอ็นต์และส่งโดยตรงไปยังที่ใดก็ตามที่ยอมรับรหัส voice
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
วลีความยินยอมที่รองรับตามภาษา
เสียงที่บันทึกความยินยอมต้องอ่านข้อความที่แน่นอนอย่างชัดเจนในภาษาใดภาษาหนึ่งจาก 30 ภาษาที่รองรับ
| ภาษา | ภาษา (lang_id) |
ข้อความความยินยอมที่ตรงกัน |
|---|---|---|
| อาหรับ | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| เบงกาลี | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| จีน (ตัวย่อ) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| ดัตช์ | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| อังกฤษ (สหรัฐอเมริกา) | en-US |
ฉันเป็นเจ้าของเสียงนี้และยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างรูปแบบเสียงสังเคราะห์ |
| อังกฤษ (สหราชอาณาจักร) | en-GB |
ฉันเป็นเจ้าของเสียงนี้และยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างรูปแบบเสียงสังเคราะห์ |
| อังกฤษ (อินเดีย) | en-IN |
ฉันเป็นเจ้าของเสียงนี้และยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างรูปแบบเสียงสังเคราะห์ |
| อังกฤษ (ออสเตรเลีย) | en-AU |
ฉันเป็นเจ้าของเสียงนี้และยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างรูปแบบเสียงสังเคราะห์ |
| ฝรั่งเศส (ฝรั่งเศส) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| ฝรั่งเศส (แคนาดา) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| เยอรมัน | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| คุชราต | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| ฮินดี | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| อินโดนีเซีย | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| อิตาลี | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| ญี่ปุ่น | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| กันนาดา | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| เกาหลี | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| มาลายาลัม | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| มราฐี | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| โปแลนด์ | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| โปรตุเกส (บราซิล) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| รัสเซีย | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| สเปน (สเปน) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| สเปน (สหรัฐอเมริกา) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| ทมิฬ | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| เตลูกู | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| ไทย | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| ตุรกี | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| เวียดนาม | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
แนวทางปฏิบัติแนะนำในการบันทึกเสียงอ้างอิง
- บันทึกในสภาพแวดล้อมที่เงียบ: ลดเสียงสะท้อนในห้อง เสียงรบกวนรอบข้าง เพลง และเสียงพูดที่ทับซ้อนกัน
- เงื่อนไขการบันทึกที่ตรงกัน: บันทึกทั้ง
source_audioและconsent_audioในไมโครโฟนเดียวกันในการตั้งค่าเสียงเดียวกันเพื่อให้การตรวจสอบการยืนยันตัวตนของผู้พูดสำเร็จอย่างสม่ำเสมอ - แปลงเป็น WAV โมโน 24kHz: เพื่อให้ได้ผลลัพธ์ที่ดีที่สุด ให้ทำการสุ่มตัวอย่างเสียงอินพุตใหม่เป็น WAV แบบ PCM 16 บิต โมโน 24kHz ก่อนทำการเข้ารหัส
ขั้นตอนถัดไป
- ดูวิธีสร้างลักษณะตัวตนที่กำหนดเองจากคำอธิบายข้อความในการออกแบบเสียง
- ดูข้อมูลเกี่ยวกับการจัดรูปแบบระดับคำ การใช้แท็กในบรรทัด และบทสนทนาแบบหลายผู้พูดได้ในคู่มือ Text-to-Speech