

Функция воспроизведения голоса позволяет воспроизвести голосовые характеристики говорящего по короткому аудиофрагменту с помощью конечной точки Gemini API Voices ( POST /v1beta/voices ). Воспроизведение голоса поддерживается как Gemini 3.8 Flash TTS ( gemini-3.8-flash-tts ), так и Gemini 3.8 Flash-Lite TTS ( gemini-3.8-flash-lite-tts ).
Самый быстрый способ воспроизвести, проверить согласие и прослушать воспроизведенный голос — это использовать интерактивный инструмент «Воспроизведение голоса» в Google AI Studio . Вы можете записать или загрузить эталонные и полученные в результате записи аудиофрагменты непосредственно в браузере, прослушать голос и скопировать полученный идентификатор voice_... непосредственно в код вашего приложения.
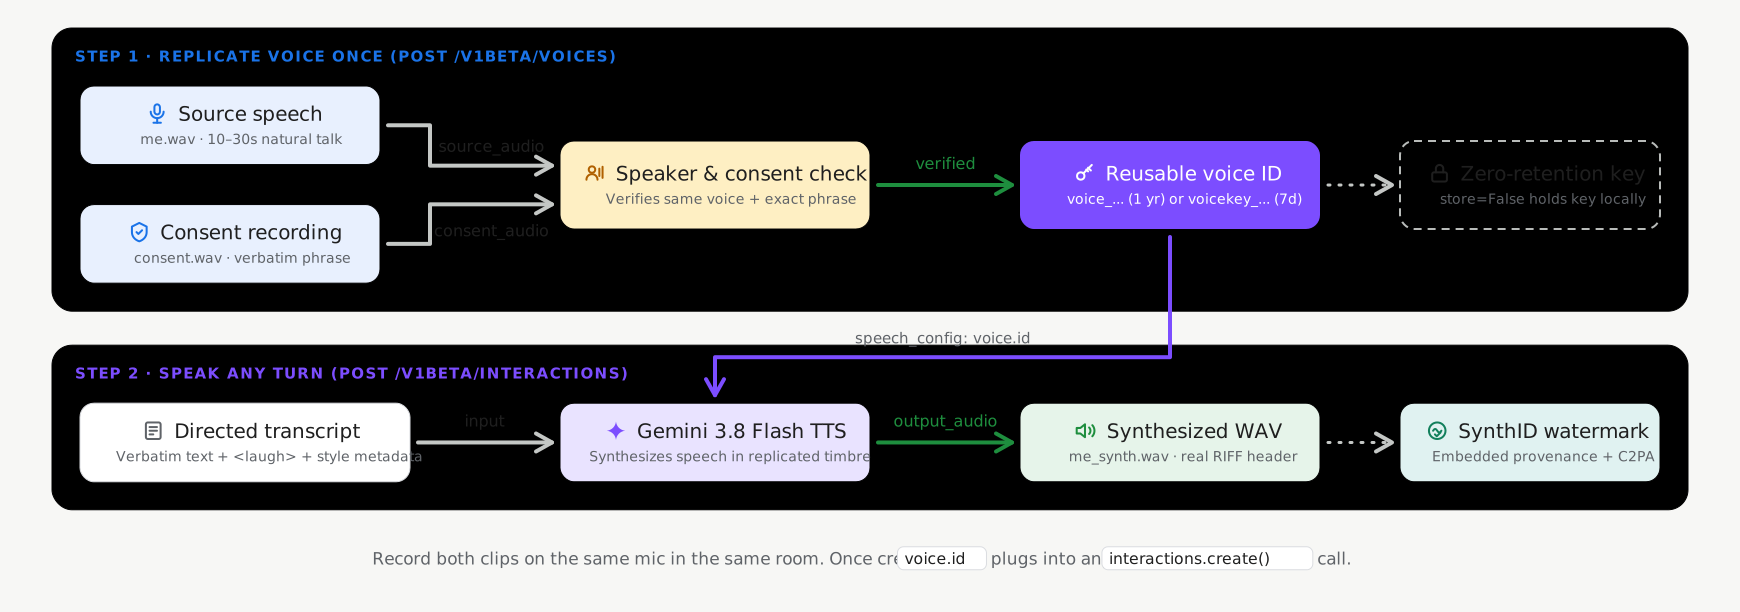
Режимы хранения с сохранением состояния и без сохранения состояния
При вызове метода voices.create ( POST /v1beta/voices ) репликация голосовых данных поддерживает два режима хранения, при этом по умолчанию включено хранение с сохранением состояния:
- Хранилище с сохранением состояния (
store=True, рекомендуемое значение по умолчанию): Google сохраняет ваш подтвержденный голосовой профиль в вашем проекте и возвращает легковесный, постоянныйvoice_id(replicated_voice.id, напримерvoice_abc123...). Вы можете передавать этотvoice_idмежду запросами и управлять им с помощьюvoices.list(),voices.get()иvoices.delete(). - Ключи, управляемые клиентом без сохранения состояния (
store=False, необязательно): Для рабочих нагрузок, требующих нулевого сохранения биометрических голосовых профилей на стороне сервера, установитеstore=False. API возвращает зашифрованный, самодостаточныйvoice_key(replicated_voice.key, начинающийся сvoicekey_...), который ваше приложение хранит локально и передает непосредственно в запросах синтеза.
| Режим хранения | Идентификатор | Ограничение проекта | Время хранения (TTL) |
|---|---|---|---|
Stateful voices ( store=True ) | voice_... | 200 голосов на проект (обмениваются между предложенными и повторяющимися голосами). | 1 год |
Бессостоятельные голосовые ключи ( store=False ) | voicekey_... | Управление осуществляется клиентом | 7 дней |
Требования к аудиозаписи и согласию
Для каждого запроса на воспроизведение через CreateVoice требуется две реальные аудиозаписи одного и того же взрослого человека (рекомендуется монофонический 16-битный WAV-файл с частотой 24 кГц):
- Эталонный аудиофайл (
source_audio): фрагмент чистой, естественной речи продолжительностью 10–30 секунд от говорящего, чей голос вы хотите воспроизвести. - Аудиозапись согласия (
consent_audio): Запись, на которой тот же говорящий четко произносит обязательное заявление о согласии на одном из поддерживаемых языков (например, на английском): > «Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для > создания модели синтетического голоса».
Создать реплицированный голос (по умолчанию с сохранением состояния).
Используйте SDK Google GenAI ( google-genai 2.25.0+ / @google/genai 2.24.0+) или REST API с store=True для создания и сохранения реплицированного голосового профиля в вашем проекте:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
ОТДЫХ
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Синтезируйте речь с помощью своего воспроизводимого голоса.
Передайте возвращенный id ( voice_... ) в запросе на синтез:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
ОТДЫХ
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Управление сохраненными реплицированными голосами
При создании с store=True ваши реплицированные голоса можно перечислять, фильтровать, проверять и удалять через API голосов (см. Расширенную библиотеку голосов и фильтрацию для получения информации обо всех параметрах фильтра):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
ОТДЫХ
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Опция: Управляемые клиентом голосовые ключи без сохранения состояния ( store=False )
Если вашему приложению не требуется сохранение голосовых профилей на стороне сервера, установите store=False при создании реплицированного голоса. API возвращает зашифрованный voice_key ( replicated_voice.key , начинающийся с voicekey_... ), который вы сохраняете на стороне клиента и передаете напрямую везде, где принимается идентификатор voice :
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
ОТДЫХ
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Фразы согласия, подкрепленные языковыми особенностями.
Аудиозапись согласия должна четко и точно воспроизводить данное утверждение на одном из 30 поддерживаемых языков:
| Язык | Локаль ( lang_id ) | Дословное заявление о согласии |
|---|---|---|
| арабский | ar-XA | Он сказал, что хочет получить информацию о Google. اصطناعي. |
| бенгальский | bn-IN | আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক Вы можете найти и использовать Google-এর সাথে সম্মতি দিচ্ছি। |
| Китайский (упрощенный) | zh-CN | 我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| Голландский | nl-NL | Я знаю, как это сделать, и мне нравится Google, чтобы оценить, как этот ствол можно создать и создать синтетическую модель ствола. |
| Английский (США) | en-US | Я являюсь владельцем этого голоса и даю согласие на использование компанией Google этого голоса для создания модели синтезированного голоса. |
| Английский (Великобритания) | en-GB | Я являюсь владельцем этого голоса и даю согласие на использование компанией Google этого голоса для создания модели синтезированного голоса. |
| Английский (Индия) | en-IN | Я являюсь владельцем этого голоса и даю согласие на использование компанией Google этого голоса для создания модели синтезированного голоса. |
| Английский (Австралия) | en-AU | Я являюсь владельцем этого голоса и даю согласие на использование компанией Google этого голоса для создания модели синтезированного голоса. |
| Французский (Франция) | fr-FR | Я являюсь владельцем этого голоса и авторизую Google, чтобы использовать этот голос, чтобы создать модель синтезированного голоса. |
| Французский (Канада) | fr-CA | Я являюсь владельцем этого голоса и авторизую Google, чтобы использовать этот голос, чтобы создать модель синтезированного голоса. |
| немецкий | de-DE | Ich bin der Eigentümer dieser Stimme und bin damit einversstanden, dass Google diese Stimme zur Erstellung eines Synthetischen Stimmmodels verwendet. |
| гуджарати | gu-IN | Он и его сын и его сын Используйте приложение Google и Google. в સંમતિ આપું છું |
| хинди | hi-IN | Он и Джон Джонс и Мэн Сэнсэй. Его персонаж Джон Блин Кейл и Google, а также его коллега. करने की Сэнсэй देता हूं |
| индонезийский | id-ID | Saya pemilik suara ini dansaya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| итальянского | it-IT | Это владелец этого голоса и согласие, которое Google использовал для создания синтетической модели голоса. |
| японский | ja-JP | 私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Каннада | kn-IN | ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ Он сказал: |
| корейский | ko-KR | 나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| Малаялам | ml-IN | В штате Нью-Йорк, США വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ и Приложение работает на Google-сервере. |
| маратхи | mr-IN | Он и Дэниел Джонс и Сан-Франциско. Митчелл и Кэрри Кейнс и Вэньчжэнь Уиллс в Google ला संमती देतो |
| польский | pl-PL | Йестем использует этот голос и ищет способы его использования, чтобы перейти к Google с целью создания синтетической модели звука. |
| Португальский (Бразилия) | pt-BR | Вы являетесь владельцем голоса и авторизованы Google в США, чтобы создать синтетическую модель голоса. |
| Русский | ru-RU | Я являюсь представителем этих голосов и даю согласие Google на использование этих голосов для создания моделей синтетических голосов. |
| Испанский (Испания) | es-ES | Я дал владельцу этого голоса свое согласие на использование Google для создания синтетической модели голоса. |
| Испанский (США) | es-US | Я дал владельцу этого голоса свое согласие на использование Google для создания синтетической модели голоса. |
| тамильский | ta-IN | நான் இந்த குரலின் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| телугу | te-IN | నేను и వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి Google నేను సమ్మతిస్తున్నాను. |
| Тайский | th-TH | Информация о Google Новости Новости |
| турецкий | tr-TR | Но все это хорошо, а Google'ын - это кулланарак, который содержит модели, которые являются неверными. |
| вьетнамский | vi-VN | Это то, что вы делаете, и что Google говорит, что это не так. |
Рекомендации по записи эталонного звука.
- Записывайте в тихой обстановке: сведите к минимуму эхо в помещении, фоновый шум, музыку и наложение голосов.
- Соответствие условиям записи: Записывайте
source_audioи аудиофайлconsent_audioна один и тот же микрофон в одних и тех же акустических условиях, чтобы проверка подлинности говорящего прошла успешно. - Преобразование в монофонический WAV-файл с частотой 24 кГц: Для достижения наилучших результатов перед кодированием передискретизируйте входной аудиосигнал в монофонический 16-битный PCM WAV-файл с частотой 24 кГц.
Что дальше?
- Узнайте, как создавать пользовательские портреты пользователей на основе текстовых описаний в Voice Design .
- Изучите стилизацию уровней реплик, встроенные теги и диалоги с участием нескольких говорящих в руководстве по преобразованию текста в речь .