

आवाज़ की नकल करने की सुविधा की मदद से, Gemini API के Voices एंडपॉइंट (POST /v1beta/voices) का इस्तेमाल करके, किसी स्पीकर के छोटे ऑडियो सैंपल से उसकी आवाज़ की नकल की जा सकती है. Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) और Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts), दोनों में आवाज़ की नकल करने की सुविधा काम करती है.
Google AI Studio में आवाज़ की नकल की इंटरैक्टिव सुविधा का इस्तेमाल करके, आवाज़ की नकल बनाने, सहमति की पुष्टि करने, और नकल की गई आवाज़ को आज़माने का काम तेज़ी से किया जा सकता है. रेफ़रंस और सहमति वाली क्लिप को सीधे ब्राउज़र में रिकॉर्ड या अपलोड किया जा सकता है. साथ ही, आवाज़ की झलक देखी जा सकती है. इसके अलावा, नतीजे के तौर पर मिले voice_... आईडी को सीधे अपने ऐप्लिकेशन कोड में कॉपी किया जा सकता है.
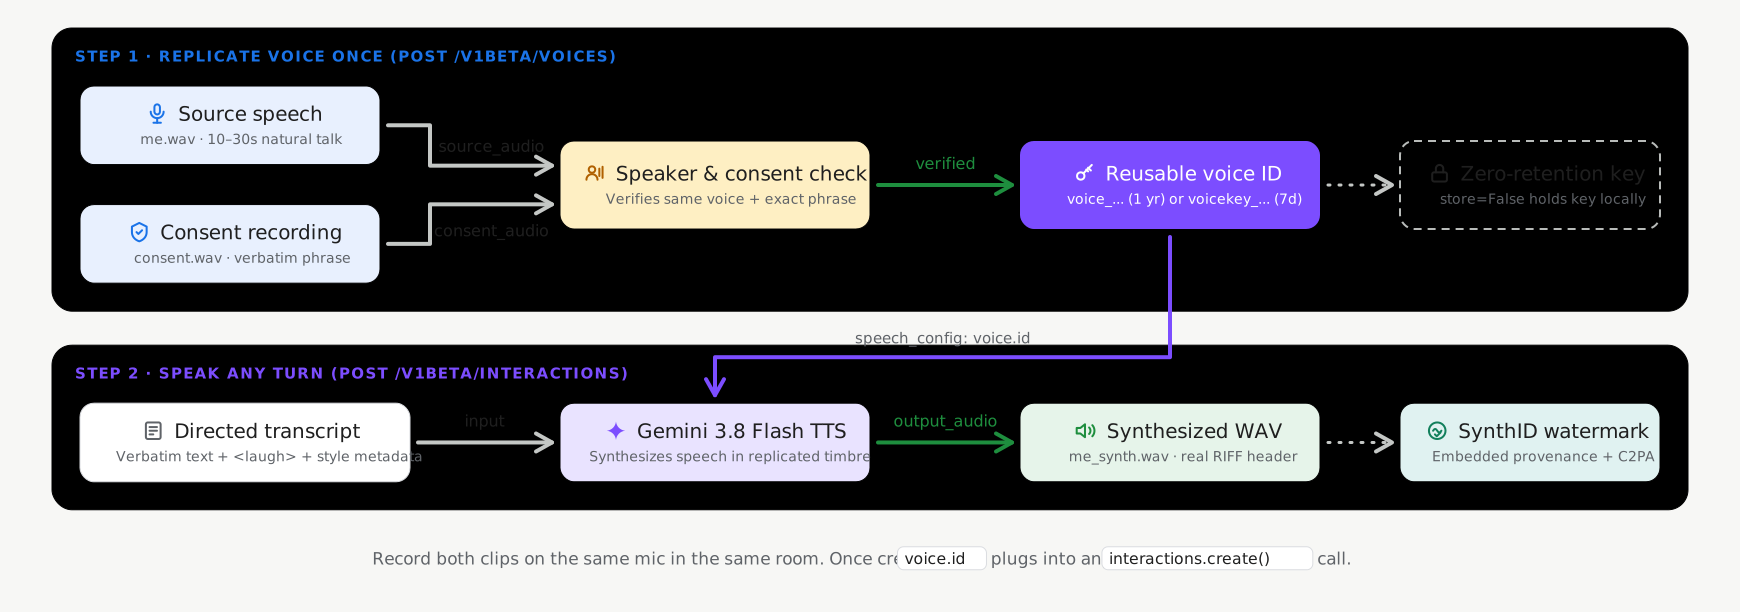
स्टेटफ़ुल और स्टेटलेस स्टोरेज मोड के बीच अंतर
कॉल voices.create
(POST /v1beta/voices) के दौरान, आवाज़ की नकल करने की सुविधा के लिए दो स्टोरेज मोड उपलब्ध होते हैं. इनमें स्टेटफ़ुल स्टोरेज डिफ़ॉल्ट रूप से चालू होता है:
- स्टेटफ़ुल स्टोरेज (
store=True, डिफ़ॉल्ट रूप से सुझाया गया): Google, आपकी पुष्टि की गई वॉइस प्रोफ़ाइल को आपके प्रोजेक्ट में सेव करता है. साथ ही, हल्के-फुल्के और लगातार बने रहने वालेvoice_id(replicated_voice.id, जैसे किvoice_abc123...) को वापस भेजता है. इसvoice_idको सभी अनुरोधों में पास किया जा सकता है. साथ ही, इसेvoices.list(),voices.get(), औरvoices.delete()की मदद से मैनेज किया जा सकता है. - क्लाइंट मैनेज किए गए स्टेटलेस कुंजियां (
store=False, ज़रूरी नहीं): उन वर्कलोड के लिएstore=Falseसेट करें जिनके लिए बायोमेट्रिक वॉइस प्रोफ़ाइल को सर्वर-साइड पर सेव करने की ज़रूरत नहीं होती. एपीआई, एन्क्रिप्ट (सुरक्षित) किया गया, अपने-आप में शामिलvoice_key(replicated_voice.key,voicekey_...से शुरू होता है) दिखाता है. आपका ऐप्लिकेशन इसे स्थानीय तौर पर सेव करता है और सीधे तौर पर सिंथेसिस के अनुरोधों में पास करता है.
| स्टोरेज मोड | पहचानकर्ता | प्रोजेक्ट की सीमा | डेटा के रखरखाव की अवधि (टीटीएल) |
|---|---|---|---|
स्टेटफ़ुल वॉइस (store=True) |
voice_... |
हर प्रोजेक्ट के लिए 200 आवाज़ें (इन्हें प्रॉम्प्ट की गई और रेप्लिका की गई आवाज़ों के साथ शेयर किया जाता है) | एक साल |
स्टेटलेस वॉइस की (store=False) |
voicekey_... |
क्लाइंट की ओर से मैनेज किया गया | सात दिन |
ऑडियो और सहमति लेने से जुड़ी ज़रूरी शर्तें
हर CreateVoice रेप्लिकेशन के अनुरोध के लिए, एक ही वयस्क व्यक्ति की दो ऑडियो रिकॉर्डिंग की ज़रूरत होती है. हमारा सुझाव है कि ये रिकॉर्डिंग 24 किलोहर्ट्ज़ मोनो 16-बिट WAV फ़ॉर्मैट में हों:
- रेफ़रंस ऑडियो (
source_audio): यह 10 से 30 सेकंड की ऐसी क्लिप होती है जिसमें साफ़ और नैचुरल तरीके से बोले गए शब्दों को शामिल किया जाता है. यह क्लिप उस व्यक्ति की होनी चाहिए जिसकी आवाज़ को आपको क्लोन करना है. - सहमति वाला ऑडियो (
consent_audio): इसमें, एक ही व्यक्ति की आवाज़ में, सहमति देने वाला ज़रूरी स्टेटमेंट साफ़ तौर पर रिकॉर्ड किया गया हो. यह स्टेटमेंट, इन भाषाओं में से किसी एक में होना चाहिए. उदाहरण के लिए, अंग्रेज़ी में: > "I am the owner of this voice and I consent to Google using this voice to > create a synthetic voice model."
रेप्लिका की गई आवाज़ बनाना (स्टेटफ़ुल डिफ़ॉल्ट)
अपने प्रोजेक्ट में डुप्लीकेट वॉइस प्रोफ़ाइल बनाने और उसे सेव करने के लिए, Google GenAI SDK (google-genai 2.25.0+ / @google/genai 2.24.0+) या REST API का इस्तेमाल करें. इसके लिए, store=True का इस्तेमाल करें:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
अपनी रेप्लिका आवाज़ का इस्तेमाल करके स्पीच सिंथेसाइज़ करना
सिंथेसिस के अनुरोध में, वापस मिला id (voice_...) पास करें:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
स्टोर की गई, डुप्लीकेट की गई आवाज़ों को मैनेज करना
store=True की मदद से बनाई गई आपकी आवाज़ों को Voices API के ज़रिए सूची में शामिल किया जा सकता है, फ़िल्टर किया जा सकता है, उनकी जांच की जा सकती है, और उन्हें मिटाया जा सकता है. फ़िल्टर करने के सभी पैरामीटर के लिए, बड़ी वॉइस लाइब्रेरी और फ़िल्टर करने की सुविधा देखें:
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
विकल्प: क्लाइंट के मैनेज किए गए स्टेटलेस वॉइस की (store=False)
अगर आपके ऐप्लिकेशन को सर्वर-साइड पर वॉइस प्रोफ़ाइल सेव करने की ज़रूरत नहीं है, तो डुप्लीकेट आवाज़ बनाते समय store=False सेट करें. एपीआई, एन्क्रिप्ट (सुरक्षित) किया गया voice_key (replicated_voice.key, voicekey_... से शुरू होता है) दिखाता है. इसे क्लाइंट-साइड पर सेव किया जाता है. साथ ही, इसे सीधे तौर पर उस जगह पर पास किया जाता है जहां voice आईडी स्वीकार किया जाता है:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
भाषा के हिसाब से, सहमति के लिए इस्तेमाल किए जा सकने वाले वाक्यांश
सहमति वाले ऑडियो में, साफ़ तौर पर सटीक स्टेटमेंट को 30 भाषाओं में से किसी एक में सुनाया जाना चाहिए:
| भाषा | स्थान-भाषा (lang_id) |
सहमति से जुड़ा कानूनी स्टेटमेंट |
|---|---|---|
| ऐरेबिक | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| बांग्ला | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি. |
| चाइनीज़ (सिंप्लिफ़ाइड) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| डच | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| अंग्रेज़ी (यूएस) | en-US |
मेरे पास इस आवाज़ का मालिकाना हक है. मैं Google को इस आवाज़ का इस्तेमाल करके, सिंथेटिक वॉइस मॉडल बनाने की अनुमति देता/देती हूं. |
| अंग्रेज़ी (यूके) | en-GB |
मेरे पास इस आवाज़ का मालिकाना हक है. साथ ही, मैं Google को इस आवाज़ का इस्तेमाल करके सिंथेटिक वॉइस मॉडल बनाने की अनुमति देता/देती हूँ. |
| अंग्रेज़ी (भारत) | en-IN |
मेरे पास इस आवाज़ का मालिकाना हक है. मैं Google को इस आवाज़ का इस्तेमाल करके, सिंथेटिक वॉइस मॉडल बनाने की अनुमति देता/देती हूं. |
| अंग्रेज़ी (ऑस्ट्रेलिया) | en-AU |
मेरे पास इस आवाज़ का मालिकाना हक है. साथ ही, मैं Google को इस आवाज़ का इस्तेमाल करके सिंथेटिक वॉइस मॉडल बनाने की अनुमति देता/देती हूँ. |
| फ़्रेंच (फ़्रांस) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| फ़्रेंच (कनाडा) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| जर्मन | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| गुजराती | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| हिन्दी | hi-IN |
मैं इस आवाज़ का मालिक हूं और मैं सिंथेटिक आवाज़ मॉडल बनाने के लिए Google को इस आवाज़ का इस्तेमाल करने की सहमति देता हूं |
| इंडोनेशियन | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| इटैलियन | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| जैपनीज़ | ja-JP |
मैं इस ऑडियो का मालिक हूं और Google को इस ऑडियो का इस्तेमाल करके, टेक्स्ट को ऑडियो में बदलने वाला मॉडल बनाने की अनुमति देता/देती हूं. |
| कन्नड़ | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| कोरियन | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| मलयालम | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| मराठी | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| पोलिश | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| पॉर्चुगीज़ (ब्राज़ील) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| रशियन | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| स्पैनिश (स्पेन) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| स्पैनिश (अमेरिका) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| तमिल | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| तेलुगु | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| थाई | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| टर्किश | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| वियतनामीज़ | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
पहचान फ़ाइल के लिए ऑडियो रिकॉर्ड करने के सबसे सही तरीके
- शांत माहौल में रिकॉर्ड करें: कमरे में गूंजने वाली आवाज़, बैकग्राउंड का शोर, संगीत, और एक साथ कई आवाज़ें कम से कम होनी चाहिए.
- रिकॉर्डिंग की शर्तों का पालन करना:
source_audioऔरconsent_audio, दोनों को एक ही माइक्रोफ़ोन से रिकॉर्ड करें. साथ ही, दोनों को एक ही अकूस्टिक सेटिंग में रिकॉर्ड करें, ताकि स्पीकर की पुष्टि करने की प्रोसेस सही तरीके से पूरी हो सके. - 24kHz मोनो WAV में बदलें: सबसे अच्छे नतीजे पाने के लिए, इनपुट ऑडियो को एन्कोड करने से पहले, 24kHz मोनो 16-बिट पीसीएम WAV में फिर से सैंपल करें.
आगे क्या करना है
- आवाज़ का डिज़ाइन सेक्शन में जाकर, टेक्स्ट के ब्यौरे के आधार पर कस्टम पर्सोना बनाने का तरीका जानें.
- टेक्स्ट-टू-स्पीच गाइड में, टर्न-लेवल स्टाइलिंग, इनलाइन टैग, और एक से ज़्यादा स्पीकर वाले डायलॉग के बारे में जानें.