

تتيح لك ميزة "محاكاة الصوت" محاكاة الخصائص الصوتية للمتحدث من عيّنة صوتية قصيرة باستخدام نقطة نهاية "الأصوات" في Gemini API (POST /v1beta/voices). تتوافق ميزة "محاكاة الصوت" مع كل من Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) وGemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts).
أسرع طريقة لإنشاء نسخة طبق الأصل من صوتك والتحقّق من الموافقة وتجربة الصوت المنسوخ هي من خلال تجربة نسخ الصوت التفاعلية في Google AI Studio. يمكنك تسجيل مقاطع صوتية مرجعية ومقاطع صوتية تتضمّن موافقة المستخدم أو تحميلها مباشرةً في المتصفّح، ومعاينة الصوت، ونسخ معرّف voice_... الناتج مباشرةً إلى رمز تطبيقك.
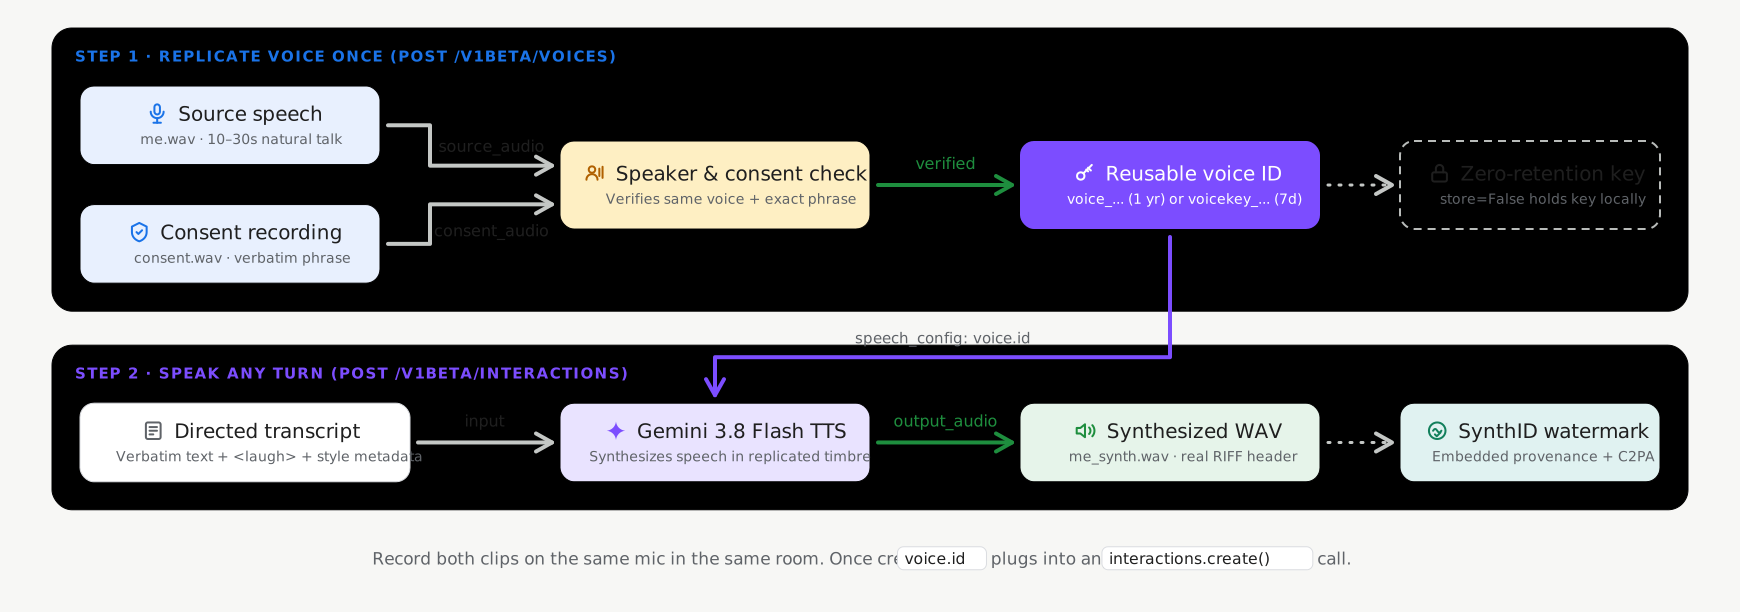
أوضاع التخزين مع الاحتفاظ بالحالة أو بدون الاحتفاظ بها
تتيح ميزة "تكرار الصوت" وضعَين للتخزين عند إجراء مكالمة voices.create
(POST /v1beta/voices)، مع تفعيل التخزين مع الاحتفاظ بالحالة تلقائيًا:
- التخزين مع الاحتفاظ بالحالة (
store=True، الإعداد التلقائي المقترَح): تخزّن Google ملفك الصوتي الذي تم التحقّق منه في مشروعك وتعرضvoice_idخفيف الوزن ودائمًا (replicated_voice.id، مثلvoice_abc123...). يمكنك تمريرvoice_idهذا عبر الطلبات وإدارته باستخدامvoices.list()وvoices.get()وvoices.delete(). - المفاتيح غير المرتبطة بحالة والمُدارة من العميل (
store=False، اختيارية): بالنسبة إلى أحمال العمل التي تتطلّب عدم الاحتفاظ بملفات تعريف الصوت البيومترية على جهة الخادم، اضبطstore=False. تعرض واجهة برمجة التطبيقاتvoice_keyمشفّرة ومستقلة (replicated_voice.key، تبدأ بـvoicekey_...) يخزّنها تطبيقك محليًا ويمررها مباشرةً في طلبات التركيب.
| وضع التخزين | المُعرّف | الحدّ الأقصى لعدد المشاريع | الاحتفاظ بالمعلومات (TTL) |
|---|---|---|---|
الأصوات ذات الحالة (store=True) |
voice_... |
200 صوت لكل مشروع (يتمّ تقسيمها بين الأصوات التي تمّ إنشاؤها من خلال المطالبات والأصوات المنسوخة) | سنة واحدة |
مفاتيح الصوت غير المرتبطة بحالة (store=False) |
voicekey_... |
تتم إدارتها من قِبل العميل | 7 أيام |
متطلبات الصوت والموافقة
يتطلّب كل طلب تكرار CreateVoice تسجيلَين صوتيَين حقيقيَين من المتحدث البالغ نفسه (يُنصح باستخدام ملف WAV أحادي القناة بسرعة 24 كيلو هرتز وعمق 16 بت):
- المحتوى الصوتي المرجعي (
source_audio): مقطع صوتي مدته تتراوح بين 10 و30 ثانية يتضمّن كلامًا طبيعيًا وواضحًا من المتحدث الذي تريد محاكاة صوته. - الموافقة الصوتية (
consent_audio): تسجيل صوتي للمتحدث نفسه وهو يتلو بوضوح بيان الموافقة الإلزامي بإحدى اللغات المتوافقة (على سبيل المثال، باللغة العربية): > "أنا صاحب هذا الصوت وأوافق على أن تستخدم Google هذا الصوت > لإنشاء نموذج صوتي اصطناعي".
إنشاء صوت مكرّر (تلقائي مع حفظ الحالة)
استخدِم حزمة تطوير البرامج (SDK) من Google للذكاء الاصطناعي التوليدي (google-genai 2.25.0 أو إصدار أحدث / @google/genai 2.24.0 أو إصدار أحدث) أو واجهة REST API
مع store=True لإنشاء وحفظ ملف صوتي طبق الأصل في مشروعك:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
إنشاء كلام باستخدام صوتك المنسوخ
مرِّر id (voice_...) الذي تم عرضه في طلب التجميع:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
إدارة الأصوات المنسوخة المخزّنة
عند إنشاء أصوات باستخدام store=True، يمكن إدراج الأصوات المنسوخة وفلترتها وفحصها وحذفها من خلال Voices API (راجِع مكتبة الأصوات الموسّعة والفلترة للاطّلاع على جميع مَعلمات الفلترة):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
الخيار: مفاتيح صوتية تديرها الجهة الخارجية بدون الاحتفاظ بأي بيانات (store=False)
إذا كان تطبيقك لا يتطلّب الاحتفاظ بنسخة من ملفات تعريف الصوت على جهة الخادم، اضبط القيمة store=False عند إنشاء نسخة طبق الأصل من الصوت. تعرض واجهة برمجة التطبيقات voice_key مشفَّرًا (replicated_voice.key، يبدأ بـ voicekey_...) يمكنك تخزينه من جهة العميل وتمريره مباشرةً إلى أي مكان يتم فيه قبول معرّف voice:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
عبارات الموافقة المتوافقة حسب اللغة
يجب أن يتضمّن المقطع الصوتي للموافقة نصّ البيان الدقيق بإحدى اللغات المتوافقة البالغ عددها 30 لغة:
| اللغة | اللغة (lang_id) |
بيان الموافقة المطابق |
|---|---|---|
| العربية | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| البنغالية | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| الصينية (المبسَّطة) | zh-CN |
我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| الهولندية | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| الإنجليزية (الولايات المتحدة) | en-US |
أنا صاحب هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| الإنجليزية (المملكة المتحدة) | en-GB |
أنا صاحب هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| الإنجليزية (الهند) | en-IN |
أنا صاحب هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| الإنجليزية (أستراليا) | en-AU |
أنا صاحب هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| الفرنسية (فرنسا) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| الفرنسية (كندا) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| الألمانية | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| الغوجاراتية | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| الهندية | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| الإندونيسية | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| الإيطالية | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| اليابانية | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| الكنادية | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| الكورية | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| المالايالامية | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| المراثية | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| البولندية | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| البرتغالية (البرازيل) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| الروسية | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| الإسبانية (إسبانيا) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| الإسبانية (الولايات المتحدة) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| التاميلية | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| التيلوغوية | te-IN |
నేను ఈ వాయిస్ యజమానిని మరియు సింతటిక్ వాయిస్ మోడల్ ని రూపొందించడానికి ఈ వాయిస్ ని ఉపయోగించడానికి googleకి నేను సమ్మతిస్తున్నాను. |
| التايلاندية | th-TH |
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์ |
| التركية | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| الفيتنامية | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
أفضل الممارسات لتسجيل مقطع صوتي مرجعي
- التسجيل في بيئة هادئة: قلِّل صدى الصوت في الغرفة والضوضاء في الخلفية والموسيقى والأصوات المتداخلة.
- مطابقة شروط التسجيل: سجِّل كلّاً من
source_audioوconsent_audioباستخدام الميكروفون نفسه وفي الإعدادات الصوتية نفسها لضمان نجاح عملية التحقّق من هوية المتحدث. - التحويل إلى ملف WAV أحادي القناة بتردد 24 كيلو هرتز: للحصول على أفضل النتائج، أعِد أخذ عينات من الصوت المدخل إلى ملف WAV أحادي القناة بتردد 24 كيلو هرتز و16 بت بتنسيق PCM قبل الترميز.
الخطوات التالية
- كيفية إنشاء شخصيات مخصّصة من أوصاف نصية في "تصميم الصوت"
- يمكنك الاطّلاع على المزيد من المعلومات حول أنماط المحادثة على مستوى الجملة والعلامات المضمّنة والحوارات بين عدة أشخاص في دليل تحويل النص إلى كلام.