

مدلهای ER (استدلال تجسمی) Gemini Robotics، مدلهای زبان بینایی (VLM) هستند که به رباتها اجازه میدهند دنیای فیزیکی را درک کرده و با آن تعامل داشته باشند. آنها دادههای بصری را تفسیر میکنند، استدلال مکانی و زمانی انجام میدهند، وظایف چند مرحلهای را برنامهریزی میکنند و رباتها و ابزارها را هماهنگ میکنند.
مدلها
مدل Gemini Robotics ER 2 جدیدترین مدل در Gemini Robotics است. این مدل استدلال بهروز شده ما است که رباتها را قادر میسازد محیط خود را دقیقاً درک کنند. این مدل در قابلیتهای استدلال تجسمی، مانند هماهنگی عامل رباتها (مثلاً با استفاده از VLAها)، درک ویدیوی ربات از جمله درک پیشرفت و تشخیص موفقیت، خواندن ابزار، اشاره و استدلال فضایی تخصص دارد.
مدل Gemini Robotics ER 2 دو نقطه پایانی مدل را معرفی میکند:
-
gemini-robotics-er-2-preview: مدل استاندارد ER 2. بر اساس Gemini 3.5 Flash ساخته شده و استدلال فضایی، یافتن لحظات ویدیویی، طبقهبندی پیشرفت ویدیو، هماهنگی چند ربات و استفاده از ابزار چند مرحلهای بهبود یافته است. -
gemini-robotics-er-2-streaming-preview: برای جریانسازی بلادرنگ از طریق Live API بهینهسازی شده است. از این مدل برای رباتهای عامل با تأخیر کم که ورودیهای صوتی و تصویری مداوم را پردازش میکنند، استفاده کنید.
اگر از Gemini Robotics ER 1.6 استفاده میکنید، با جایگزینی model="gemini-robotics-er-1.6-preview" با model="gemini-robotics-er-2-preview" یا model="gemini-robotics-er-2-streaming-preview" در فراخوانیهای API خود، به Gemini Robotics ER 2 ارتقا دهید. توجه داشته باشید که مدل Gemini Robotics ER 1.6 در پایان ماه آگوست غیرفعال خواهد شد.
Gemini Robotics ER 2 را در استودیوی هوش مصنوعی گوگل امتحان کنید
قابلیتهای رباتیک
ربات Gemini Robotics ER از طیف وسیعی از قابلیتهای استدلال تجسمی پشتیبانی میکند. برای کسب اطلاعات بیشتر، یکی از قابلیتها را انتخاب کنید:
| قابلیت | توضیحات | راهنما |
|---|---|---|
| استدلال فضایی | به اشیاء اشاره کنید، آنها را در ویدیو ردیابی کنید، با جعبههای محدودکننده تشخیص دهید، مسیرها را برنامهریزی کنید. | استدلال فضایی |
| دیدگاه عاملگرایانه | با استفاده از ابزارهای دستکاری تصویر، از اجرای کد برای بهبود سایر قابلیتها استفاده کنید. | دیدگاه عاملگرایانه |
| هماهنگسازی وظایف | استدلال فضایی را با API های ربات سفارشی ترکیب کنید تا وظایف بلندمدت را انجام دهید. | هماهنگسازی وظایف |
| پخش جریانی (فقط نقطه پایانی پخش جریانی Gemini Robotics ER 2) | جریان دو طرفه برای عاملهای ربات بلادرنگ با فراخوانی تابع با تأخیر کم | پخش زنده برای رباتیک |
| پیشرفت ویدیویی (فقط Gemini Robotics ER 2) | یافتن لحظه و طبقهبندی پیشرفت از فیدهای ویدیویی پیوسته | درک ویدیو |
شروع به کار
مثال زیر اشیاء را در یک تصویر پیدا میکند و مختصات دوبعدی و برچسبهای نرمالشدهی آنها را برمیگرداند. میتوانید این خروجی را مستقیماً به یک API رباتیک یا یک مدل VLA ارسال کنید تا اقدامات ربات تولید شود.
پایتون
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
استراحت
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
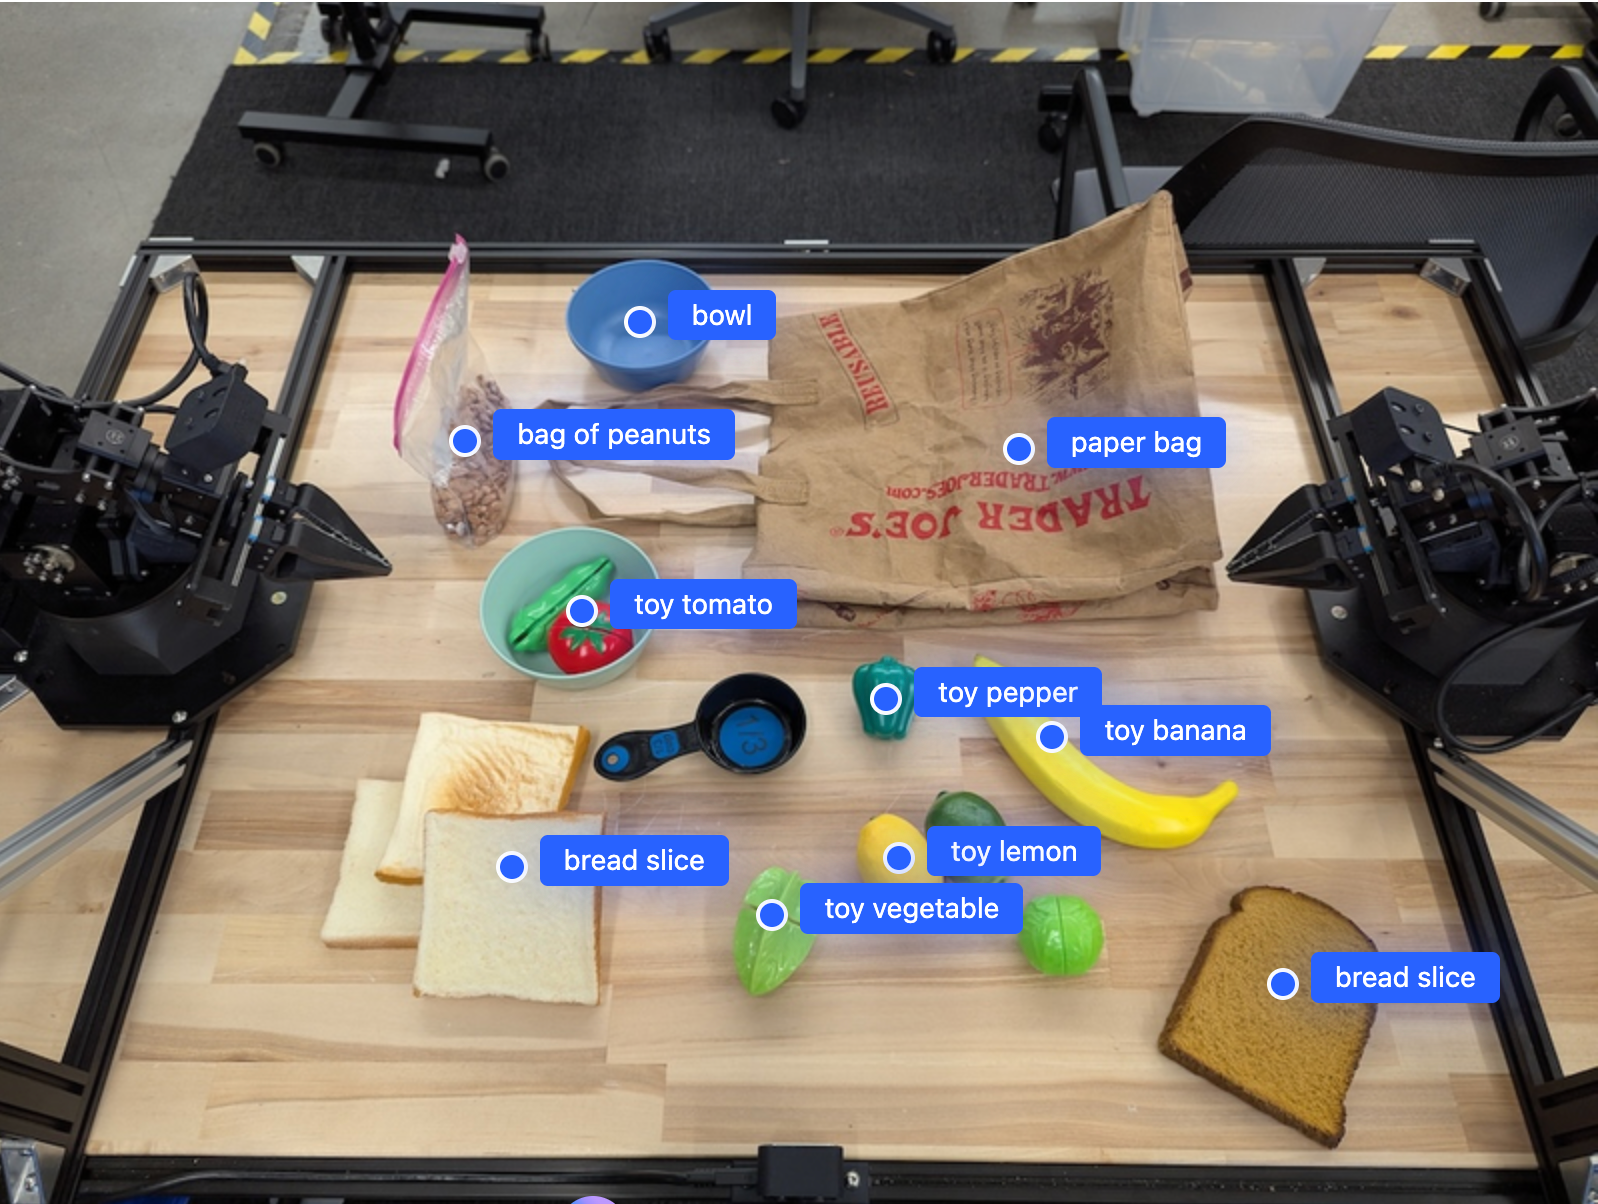
خروجی یک آرایه JSON حاوی اشیاء خواهد بود که هر کدام دارای یک point (مختصات نرمال شده [y, x] ) و یک label شناسایی کننده شیء هستند.
جیسون
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تصویر زیر نمونهای از نحوه نمایش این نقاط است:
چگونه کار میکند؟
Gemini Robotics ER ورودی تصویر، ویدئو یا صدا را با زبان طبیعی دریافت میکند. اشیاء را شناسایی میکند، دلایلی در مورد زمینه صحنه و روابط مکانی ارائه میدهد و خروجی ساختاریافتهای مانند مختصات یا جعبههای محصورکننده را برمیگرداند.
Gemini Robotics ER همچنین عاملگرا است: وظایف پیچیده را به زیروظایف تقسیم میکند و آنها را با فراخوانی توابع ربات شما یا اجرای کد تولید شده اجرا میکند. به عنوان مثال، "سیب را در کاسه بگذار" به دنبالهای از مراحل مکانیابی، گرفتن و قرار دادن تبدیل میشود.
برای جزئیات بیشتر در مورد نحوه اجرای فراخوانیهای ابزار در Gemini، به بخش فراخوانی تابع مراجعه کنید.
ایمنی
اگرچه ربات Gemini Robotics ER با در نظر گرفتن ایمنی ساخته شده است، اما مسئولیت حفظ محیط امن در اطراف ربات بر عهده شماست. مدلهای هوش مصنوعی مولد میتوانند اشتباه کنند و رباتهای فیزیکی میتوانند باعث آسیب شوند. برای کسب اطلاعات بیشتر، به صفحه ایمنی رباتیک Google DeepMind مراجعه کنید.
بهترین شیوهها
از زبان ساده و طبیعی استفاده کنید. کاری را که میخواهید ربات انجام دهد، همانطور که برای یک انسان انجام میدهید، توصیف کنید. اگر یک اصطلاح کارساز نبود، یک مترادف رایج را امتحان کنید.
ورودی بصری را بهینه کنید. قبل از ارسال تصویر، اشیاء کوچک یا نامشخص را برش دهید یا بزرگنمایی کنید. روشنایی و کنتراست رنگ پایین میتواند بر تشخیص تأثیر بگذارد.
وظایف پیچیده را به مراحل مختلف تقسیم کنید. هر مرحله را به عنوان یک دستورالعمل جداگانه ارسال کنید تا مدل متمرکز بماند و دقت بهبود یابد.
چندین بار پرس و جو کنید و برای وظایف با دقت بالا، میانگین نتایج را بگیرید. این رویکرد اجماع، واریانس در خروجیهای مکانی را کاهش میدهد.
محدودیتها
هنگام توسعه با Gemini Robotics ER، محدودیتهای زیر را در نظر بگیرید:
- محدودیتهای کلید API: رابط برنامهنویسی Gemini درخواستهای دریافتی از کلیدهای API بدون محدودیت را نمیپذیرد و خطای
403 Forbiddenرا برمیگرداند. با اضافه کردن محدودیتهایی در AI Studio ، کلید API خود را ایمن کنید. برای جزئیات بیشتر به Secure unlimited API keys مراجعه کنید. - تأخیر در مقابل عملکرد: پرسوجوهای پیچیده، ورودیهای با وضوح بالا یا سطوح بالای تفکر میتوانند منجر به افزایش زمان پردازش شوند. برای سطح تفکر از سطح متوسط استفاده کنید تا تعادل خوبی بین تأخیر و عملکرد برقرار شود.
- توهمات: مانند تمام مدلهای زبانی بزرگ، مدلهای ER Gemini Robotics میتوانند گاهی اوقات "توهم" داشته باشند یا اطلاعات نادرستی ارائه دهند، به خصوص برای دستورات مبهم یا ورودیهای خارج از توزیع.
- وابستگی به کیفیت دستور: کیفیت خروجی به وضوح دستور ورودی بستگی دارد. از دستورهای خاص و ساختارمند استفاده کنید.
- هزینه محاسباتی: اجرای مدل، به خصوص با ورودیهای ویدیویی یا
thinking_budgetبالا، منابع محاسباتی را مصرف میکند و هزینههایی را به همراه دارد. برای جزئیات بیشتر به صفحه Thinking مراجعه کنید. - انواع ورودی: برای جزئیات بیشتر در مورد محدودیتهای هر حالت، به مباحث زیر مراجعه کنید.
اطلاعیه حریم خصوصی
شما تصدیق میکنید که مدلهای ارجاعشده در این سند ("مدلهای رباتیک") از دادههای ویدیویی و صوتی برای کار و جابجایی سختافزار شما مطابق با دستورالعملهای شما استفاده میکنند. بنابراین، شما میتوانید مدلهای رباتیک را به گونهای اداره کنید که دادههای افراد قابل شناسایی، مانند صدا، تصویر و دادههای شباهت ("دادههای شخصی")، توسط مدلهای رباتیک جمعآوری شود. اگر تصمیم بگیرید که مدلهای رباتیک را به روشی که دادههای شخصی را جمعآوری میکند، اداره کنید، موافقت میکنید که به هیچ فرد قابل شناسایی اجازه تعامل یا حضور در منطقه اطراف مدلهای رباتیک را نخواهید داد، مگر اینکه و تا زمانی که این افراد قابل شناسایی به اندازه کافی از این واقعیت که دادههای شخصی آنها ممکن است توسط گوگل ارائه و استفاده شود، همانطور که در شرایط خدمات اضافی Gemini API که در https://ai.google.dev/gemini-api/terms ("شرایط") ذکر شده است، از جمله مطابق با بخش "نحوه استفاده گوگل از دادههای شما" مطلع شده و رضایت داده باشند. شما تضمین خواهید کرد که چنین اطلاعیهای، جمعآوری و استفاده از دادههای شخصی را طبق مفاد مندرج در شرایط، مجاز میداند و با استفاده از تکنیکهایی مانند محو کردن چهره و اجرای مدلهای رباتیک در مناطقی که افراد قابل شناسایی در آنها حضور ندارند، تا حد امکان، تلاشهای تجاری معقولی را برای به حداقل رساندن جمعآوری و توزیع دادههای شخصی به کار خواهید گرفت.
قیمتگذاری
برای اطلاعات دقیق در مورد قیمت گذاری و مناطق موجود، به صفحه قیمت گذاری مراجعه کنید.
نقاط پایانی مدل
پیشنمایش ربات Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش پخش زنده Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-streaming-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی شده پشتیبانی نمیشود |
| گزینههای مصرف | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش Gemini Robotics ER 1.6
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-1.6-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | دسامبر ۲۰۲۵ |
| حد آستانه دانش | ژانویه ۲۰۲۵ |
قدم بعدی چیست؟
- استدلال فضایی - اشاره کردن، ردیابی، تعیین محدوده، مسیرها.
- قابلیتهای عاملیتی - اجرای کد، خواندن ابزار، حاشیهنویسی تصویر.
- هماهنگسازی وظایف — وظایف بلندمدت با APIهای سفارشی ربات.
- رباتیک با استریمینگ — استریمینگ دوطرفه بلادرنگ (فقط Gemini Robotics ER 2).
- درک ویدیو — یافتن لحظه و طبقهبندی پیشرفت (فقط Gemini Robotics ER 2).
- ایمنی رباتیک گوگل دیپمایند - تحقیقات ایمنی پشت خانواده مدل.
مدلهای ER (استدلال تجسمی) Gemini Robotics، مدلهای زبان بینایی (VLM) هستند که به رباتها اجازه میدهند دنیای فیزیکی را درک کرده و با آن تعامل داشته باشند. آنها دادههای بصری را تفسیر میکنند، استدلال مکانی و زمانی انجام میدهند، وظایف چند مرحلهای را برنامهریزی میکنند و رباتها و ابزارها را هماهنگ میکنند.
مدلها
مدل Gemini Robotics ER 2 جدیدترین مدل در Gemini Robotics است. این مدل استدلال بهروز شده ما است که رباتها را قادر میسازد محیط خود را دقیقاً درک کنند. این مدل در قابلیتهای استدلال تجسمی، مانند هماهنگی عامل رباتها (مثلاً با استفاده از VLAها)، درک ویدیوی ربات از جمله درک پیشرفت و تشخیص موفقیت، خواندن ابزار، اشاره و استدلال فضایی تخصص دارد.
مدل Gemini Robotics ER 2 دو نقطه پایانی مدل را معرفی میکند:
-
gemini-robotics-er-2-preview: مدل استاندارد ER 2. بر اساس Gemini 3.5 Flash ساخته شده و استدلال فضایی، یافتن لحظات ویدیویی، طبقهبندی پیشرفت ویدیو، هماهنگی چند ربات و استفاده از ابزار چند مرحلهای بهبود یافته است. -
gemini-robotics-er-2-streaming-preview: برای جریانسازی بلادرنگ از طریق Live API بهینهسازی شده است. از این مدل برای رباتهای عامل با تأخیر کم که ورودیهای صوتی و تصویری مداوم را پردازش میکنند، استفاده کنید.
اگر از Gemini Robotics ER 1.6 استفاده میکنید، با جایگزینی model="gemini-robotics-er-1.6-preview" با model="gemini-robotics-er-2-preview" یا model="gemini-robotics-er-2-streaming-preview" در فراخوانیهای API خود، به Gemini Robotics ER 2 ارتقا دهید. توجه داشته باشید که مدل Gemini Robotics ER 1.6 در پایان ماه آگوست غیرفعال خواهد شد.
Gemini Robotics ER 2 را در استودیوی هوش مصنوعی گوگل امتحان کنید
قابلیتهای رباتیک
ربات Gemini Robotics ER از طیف وسیعی از قابلیتهای استدلال تجسمی پشتیبانی میکند. برای کسب اطلاعات بیشتر، یکی از قابلیتها را انتخاب کنید:
| قابلیت | توضیحات | راهنما |
|---|---|---|
| استدلال فضایی | به اشیاء اشاره کنید، آنها را در ویدیو ردیابی کنید، با جعبههای محدودکننده تشخیص دهید، مسیرها را برنامهریزی کنید. | استدلال فضایی |
| دیدگاه عاملگرایانه | با استفاده از ابزارهای دستکاری تصویر، از اجرای کد برای بهبود سایر قابلیتها استفاده کنید. | دیدگاه عاملگرایانه |
| هماهنگسازی وظایف | استدلال فضایی را با API های ربات سفارشی ترکیب کنید تا وظایف بلندمدت را انجام دهید. | هماهنگسازی وظایف |
| پخش جریانی (فقط نقطه پایانی پخش جریانی Gemini Robotics ER 2) | جریان دو طرفه برای عاملهای ربات بلادرنگ با فراخوانی تابع با تأخیر کم | پخش زنده برای رباتیک |
| پیشرفت ویدیویی (فقط Gemini Robotics ER 2) | یافتن لحظه و طبقهبندی پیشرفت از فیدهای ویدیویی پیوسته | درک ویدیو |
شروع به کار
مثال زیر اشیاء را در یک تصویر پیدا میکند و مختصات دوبعدی و برچسبهای نرمالشدهی آنها را برمیگرداند. میتوانید این خروجی را مستقیماً به یک API رباتیک یا یک مدل VLA ارسال کنید تا اقدامات ربات تولید شود.
پایتون
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
استراحت
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
خروجی یک آرایه JSON حاوی اشیاء خواهد بود که هر کدام دارای یک point (مختصات نرمال شده [y, x] ) و یک label شناسایی کننده شیء هستند.
جیسون
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تصویر زیر نمونهای از نحوه نمایش این نقاط است:
چگونه کار میکند؟
Gemini Robotics ER ورودی تصویر، ویدئو یا صدا را با زبان طبیعی دریافت میکند. اشیاء را شناسایی میکند، دلایلی در مورد زمینه صحنه و روابط مکانی ارائه میدهد و خروجی ساختاریافتهای مانند مختصات یا جعبههای محصورکننده را برمیگرداند.
Gemini Robotics ER همچنین عاملگرا است: وظایف پیچیده را به زیروظایف تقسیم میکند و آنها را با فراخوانی توابع ربات شما یا اجرای کد تولید شده اجرا میکند. به عنوان مثال، "سیب را در کاسه بگذار" به دنبالهای از مراحل مکانیابی، گرفتن و قرار دادن تبدیل میشود.
برای جزئیات بیشتر در مورد نحوه اجرای فراخوانیهای ابزار در Gemini، به بخش فراخوانی تابع مراجعه کنید.
ایمنی
اگرچه ربات Gemini Robotics ER با در نظر گرفتن ایمنی ساخته شده است، اما مسئولیت حفظ محیط امن در اطراف ربات بر عهده شماست. مدلهای هوش مصنوعی مولد میتوانند اشتباه کنند و رباتهای فیزیکی میتوانند باعث آسیب شوند. برای کسب اطلاعات بیشتر، به صفحه ایمنی رباتیک Google DeepMind مراجعه کنید.
بهترین شیوهها
از زبان ساده و طبیعی استفاده کنید. کاری را که میخواهید ربات انجام دهد، همانطور که برای یک انسان انجام میدهید، توصیف کنید. اگر یک اصطلاح کارساز نبود، یک مترادف رایج را امتحان کنید.
ورودی بصری را بهینه کنید. قبل از ارسال تصویر، اشیاء کوچک یا نامشخص را برش دهید یا بزرگنمایی کنید. روشنایی و کنتراست رنگ پایین میتواند بر تشخیص تأثیر بگذارد.
وظایف پیچیده را به مراحل مختلف تقسیم کنید. هر مرحله را به عنوان یک دستورالعمل جداگانه ارسال کنید تا مدل متمرکز بماند و دقت بهبود یابد.
چندین بار پرس و جو کنید و برای وظایف با دقت بالا، میانگین نتایج را بگیرید. این رویکرد اجماع، واریانس در خروجیهای مکانی را کاهش میدهد.
محدودیتها
هنگام توسعه با Gemini Robotics ER، محدودیتهای زیر را در نظر بگیرید:
- محدودیتهای کلید API: رابط برنامهنویسی Gemini درخواستهای دریافتی از کلیدهای API بدون محدودیت را نمیپذیرد و خطای
403 Forbiddenرا برمیگرداند. با اضافه کردن محدودیتهایی در AI Studio ، کلید API خود را ایمن کنید. برای جزئیات بیشتر به Secure unlimited API keys مراجعه کنید. - تأخیر در مقابل عملکرد: پرسوجوهای پیچیده، ورودیهای با وضوح بالا یا سطوح بالای تفکر میتوانند منجر به افزایش زمان پردازش شوند. برای سطح تفکر از سطح متوسط استفاده کنید تا تعادل خوبی بین تأخیر و عملکرد برقرار شود.
- توهمات: مانند تمام مدلهای زبانی بزرگ، مدلهای ER Gemini Robotics میتوانند گاهی اوقات "توهم" داشته باشند یا اطلاعات نادرستی ارائه دهند، به خصوص برای دستورات مبهم یا ورودیهای خارج از توزیع.
- وابستگی به کیفیت دستور: کیفیت خروجی به وضوح دستور ورودی بستگی دارد. از دستورهای خاص و ساختارمند استفاده کنید.
- هزینه محاسباتی: اجرای مدل، به خصوص با ورودیهای ویدیویی یا
thinking_budgetبالا، منابع محاسباتی را مصرف میکند و هزینههایی را به همراه دارد. برای جزئیات بیشتر به صفحه Thinking مراجعه کنید. - انواع ورودی: برای جزئیات بیشتر در مورد محدودیتهای هر حالت، به مباحث زیر مراجعه کنید.
اطلاعیه حریم خصوصی
شما تصدیق میکنید که مدلهای ارجاعشده در این سند ("مدلهای رباتیک") از دادههای ویدیویی و صوتی برای کار و جابجایی سختافزار شما مطابق با دستورالعملهای شما استفاده میکنند. بنابراین، شما میتوانید مدلهای رباتیک را به گونهای اداره کنید که دادههای افراد قابل شناسایی، مانند صدا، تصویر و دادههای شباهت ("دادههای شخصی")، توسط مدلهای رباتیک جمعآوری شود. اگر تصمیم بگیرید که مدلهای رباتیک را به روشی که دادههای شخصی را جمعآوری میکند، اداره کنید، موافقت میکنید که به هیچ فرد قابل شناسایی اجازه تعامل یا حضور در منطقه اطراف مدلهای رباتیک را نخواهید داد، مگر اینکه و تا زمانی که این افراد قابل شناسایی به اندازه کافی از این واقعیت که دادههای شخصی آنها ممکن است توسط گوگل ارائه و استفاده شود، همانطور که در شرایط خدمات اضافی Gemini API که در https://ai.google.dev/gemini-api/terms ("شرایط") ذکر شده است، از جمله مطابق با بخش "نحوه استفاده گوگل از دادههای شما" مطلع شده و رضایت داده باشند. شما تضمین خواهید کرد که چنین اطلاعیهای، جمعآوری و استفاده از دادههای شخصی را طبق مفاد مندرج در شرایط، مجاز میداند و با استفاده از تکنیکهایی مانند محو کردن چهره و اجرای مدلهای رباتیک در مناطقی که افراد قابل شناسایی در آنها حضور ندارند، تا حد امکان، تلاشهای تجاری معقولی را برای به حداقل رساندن جمعآوری و توزیع دادههای شخصی به کار خواهید گرفت.
قیمتگذاری
برای اطلاعات دقیق در مورد قیمت گذاری و مناطق موجود، به صفحه قیمت گذاری مراجعه کنید.
نقاط پایانی مدل
پیشنمایش ربات Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش پخش زنده Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-streaming-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی شده پشتیبانی نمیشود |
| گزینههای مصرف | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش Gemini Robotics ER 1.6
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-1.6-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | دسامبر ۲۰۲۵ |
| حد آستانه دانش | ژانویه ۲۰۲۵ |
قدم بعدی چیست؟
- استدلال فضایی - اشاره کردن، ردیابی، تعیین محدوده، مسیرها.
- قابلیتهای عاملیتی - اجرای کد، خواندن ابزار، حاشیهنویسی تصویر.
- هماهنگسازی وظایف — وظایف بلندمدت با APIهای سفارشی ربات.
- رباتیک با استریمینگ — استریمینگ دوطرفه بلادرنگ (فقط Gemini Robotics ER 2).
- درک ویدیو — یافتن لحظه و طبقهبندی پیشرفت (فقط Gemini Robotics ER 2).
- ایمنی رباتیک گوگل دیپمایند - تحقیقات ایمنی پشت خانواده مدل.
مدلهای ER (استدلال تجسمی) Gemini Robotics، مدلهای زبان بینایی (VLM) هستند که به رباتها اجازه میدهند دنیای فیزیکی را درک کرده و با آن تعامل داشته باشند. آنها دادههای بصری را تفسیر میکنند، استدلال مکانی و زمانی انجام میدهند، وظایف چند مرحلهای را برنامهریزی میکنند و رباتها و ابزارها را هماهنگ میکنند.
مدلها
مدل Gemini Robotics ER 2 جدیدترین مدل در Gemini Robotics است. این مدل استدلال بهروز شده ما است که رباتها را قادر میسازد محیط خود را دقیقاً درک کنند. این مدل در قابلیتهای استدلال تجسمی، مانند هماهنگی عامل رباتها (مثلاً با استفاده از VLAها)، درک ویدیوی ربات از جمله درک پیشرفت و تشخیص موفقیت، خواندن ابزار، اشاره و استدلال فضایی تخصص دارد.
مدل Gemini Robotics ER 2 دو نقطه پایانی مدل را معرفی میکند:
-
gemini-robotics-er-2-preview: مدل استاندارد ER 2. بر اساس Gemini 3.5 Flash ساخته شده و استدلال فضایی، یافتن لحظات ویدیویی، طبقهبندی پیشرفت ویدیو، هماهنگی چند ربات و استفاده از ابزار چند مرحلهای بهبود یافته است. -
gemini-robotics-er-2-streaming-preview: برای جریانسازی بلادرنگ از طریق Live API بهینهسازی شده است. از این مدل برای رباتهای عامل با تأخیر کم که ورودیهای صوتی و تصویری مداوم را پردازش میکنند، استفاده کنید.
اگر از Gemini Robotics ER 1.6 استفاده میکنید، با جایگزینی model="gemini-robotics-er-1.6-preview" با model="gemini-robotics-er-2-preview" یا model="gemini-robotics-er-2-streaming-preview" در فراخوانیهای API خود، به Gemini Robotics ER 2 ارتقا دهید. توجه داشته باشید که مدل Gemini Robotics ER 1.6 در پایان ماه آگوست غیرفعال خواهد شد.
Gemini Robotics ER 2 را در استودیوی هوش مصنوعی گوگل امتحان کنید
قابلیتهای رباتیک
ربات Gemini Robotics ER از طیف وسیعی از قابلیتهای استدلال تجسمی پشتیبانی میکند. برای کسب اطلاعات بیشتر، یکی از قابلیتها را انتخاب کنید:
| قابلیت | توضیحات | راهنما |
|---|---|---|
| استدلال فضایی | به اشیاء اشاره کنید، آنها را در ویدیو ردیابی کنید، با جعبههای محدودکننده تشخیص دهید، مسیرها را برنامهریزی کنید. | استدلال فضایی |
| دیدگاه عاملگرایانه | با استفاده از ابزارهای دستکاری تصویر، از اجرای کد برای بهبود سایر قابلیتها استفاده کنید. | دیدگاه عاملگرایانه |
| هماهنگسازی وظایف | استدلال فضایی را با API های ربات سفارشی ترکیب کنید تا وظایف بلندمدت را انجام دهید. | هماهنگسازی وظایف |
| پخش جریانی (فقط نقطه پایانی پخش جریانی Gemini Robotics ER 2) | جریان دو طرفه برای عاملهای ربات بلادرنگ با فراخوانی تابع با تأخیر کم | پخش زنده برای رباتیک |
| پیشرفت ویدیویی (فقط Gemini Robotics ER 2) | یافتن لحظه و طبقهبندی پیشرفت از فیدهای ویدیویی پیوسته | درک ویدیو |
شروع به کار
مثال زیر اشیاء را در یک تصویر پیدا میکند و مختصات دوبعدی و برچسبهای نرمالشدهی آنها را برمیگرداند. میتوانید این خروجی را مستقیماً به یک API رباتیک یا یک مدل VLA ارسال کنید تا اقدامات ربات تولید شود.
پایتون
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
استراحت
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
خروجی یک آرایه JSON حاوی اشیاء خواهد بود که هر کدام دارای یک point (مختصات نرمال شده [y, x] ) و یک label شناسایی کننده شیء هستند.
جیسون
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تصویر زیر نمونهای از نحوه نمایش این نقاط است:
چگونه کار میکند؟
Gemini Robotics ER ورودی تصویر، ویدئو یا صدا را با زبان طبیعی دریافت میکند. اشیاء را شناسایی میکند، دلایلی در مورد زمینه صحنه و روابط مکانی ارائه میدهد و خروجی ساختاریافتهای مانند مختصات یا جعبههای محصورکننده را برمیگرداند.
Gemini Robotics ER همچنین عاملگرا است: وظایف پیچیده را به زیروظایف تقسیم میکند و آنها را با فراخوانی توابع ربات شما یا اجرای کد تولید شده اجرا میکند. به عنوان مثال، "سیب را در کاسه بگذار" به دنبالهای از مراحل مکانیابی، گرفتن و قرار دادن تبدیل میشود.
برای جزئیات بیشتر در مورد نحوه اجرای فراخوانیهای ابزار در Gemini، به بخش فراخوانی تابع مراجعه کنید.
ایمنی
اگرچه ربات Gemini Robotics ER با در نظر گرفتن ایمنی ساخته شده است، اما مسئولیت حفظ محیط امن در اطراف ربات بر عهده شماست. مدلهای هوش مصنوعی مولد میتوانند اشتباه کنند و رباتهای فیزیکی میتوانند باعث آسیب شوند. برای کسب اطلاعات بیشتر، به صفحه ایمنی رباتیک Google DeepMind مراجعه کنید.
بهترین شیوهها
از زبان ساده و طبیعی استفاده کنید. کاری را که میخواهید ربات انجام دهد، همانطور که برای یک انسان انجام میدهید، توصیف کنید. اگر یک اصطلاح کارساز نبود، یک مترادف رایج را امتحان کنید.
ورودی بصری را بهینه کنید. قبل از ارسال تصویر، اشیاء کوچک یا نامشخص را برش دهید یا بزرگنمایی کنید. روشنایی و کنتراست رنگ پایین میتواند بر تشخیص تأثیر بگذارد.
وظایف پیچیده را به مراحل مختلف تقسیم کنید. هر مرحله را به عنوان یک دستورالعمل جداگانه ارسال کنید تا مدل متمرکز بماند و دقت بهبود یابد.
چندین بار پرس و جو کنید و برای وظایف با دقت بالا، میانگین نتایج را بگیرید. این رویکرد اجماع، واریانس در خروجیهای مکانی را کاهش میدهد.
محدودیتها
هنگام توسعه با Gemini Robotics ER، محدودیتهای زیر را در نظر بگیرید:
- محدودیتهای کلید API: رابط برنامهنویسی Gemini درخواستهای دریافتی از کلیدهای API بدون محدودیت را نمیپذیرد و خطای
403 Forbiddenرا برمیگرداند. با اضافه کردن محدودیتهایی در AI Studio ، کلید API خود را ایمن کنید. برای جزئیات بیشتر به Secure unlimited API keys مراجعه کنید. - تأخیر در مقابل عملکرد: پرسوجوهای پیچیده، ورودیهای با وضوح بالا یا سطوح بالای تفکر میتوانند منجر به افزایش زمان پردازش شوند. برای سطح تفکر از سطح متوسط استفاده کنید تا تعادل خوبی بین تأخیر و عملکرد برقرار شود.
- توهمات: مانند تمام مدلهای زبانی بزرگ، مدلهای ER Gemini Robotics میتوانند گاهی اوقات "توهم" داشته باشند یا اطلاعات نادرستی ارائه دهند، به خصوص برای دستورات مبهم یا ورودیهای خارج از توزیع.
- وابستگی به کیفیت دستور: کیفیت خروجی به وضوح دستور ورودی بستگی دارد. از دستورهای خاص و ساختارمند استفاده کنید.
- هزینه محاسباتی: اجرای مدل، به خصوص با ورودیهای ویدیویی یا
thinking_budgetبالا، منابع محاسباتی را مصرف میکند و هزینههایی را به همراه دارد. برای جزئیات بیشتر به صفحه Thinking مراجعه کنید. - انواع ورودی: برای جزئیات بیشتر در مورد محدودیتهای هر حالت، به مباحث زیر مراجعه کنید.
اطلاعیه حریم خصوصی
شما تصدیق میکنید که مدلهای ارجاعشده در این سند ("مدلهای رباتیک") از دادههای ویدیویی و صوتی برای کار و جابجایی سختافزار شما مطابق با دستورالعملهای شما استفاده میکنند. بنابراین، شما میتوانید مدلهای رباتیک را به گونهای اداره کنید که دادههای افراد قابل شناسایی، مانند صدا، تصویر و دادههای شباهت ("دادههای شخصی")، توسط مدلهای رباتیک جمعآوری شود. اگر تصمیم بگیرید که مدلهای رباتیک را به روشی که دادههای شخصی را جمعآوری میکند، اداره کنید، موافقت میکنید که به هیچ فرد قابل شناسایی اجازه تعامل یا حضور در منطقه اطراف مدلهای رباتیک را نخواهید داد، مگر اینکه و تا زمانی که این افراد قابل شناسایی به اندازه کافی از این واقعیت که دادههای شخصی آنها ممکن است توسط گوگل ارائه و استفاده شود، همانطور که در شرایط خدمات اضافی Gemini API که در https://ai.google.dev/gemini-api/terms ("شرایط") ذکر شده است، از جمله مطابق با بخش "نحوه استفاده گوگل از دادههای شما" مطلع شده و رضایت داده باشند. شما تضمین خواهید کرد که چنین اطلاعیهای، جمعآوری و استفاده از دادههای شخصی را طبق مفاد مندرج در شرایط، مجاز میداند و با استفاده از تکنیکهایی مانند محو کردن چهره و اجرای مدلهای رباتیک در مناطقی که افراد قابل شناسایی در آنها حضور ندارند، تا حد امکان، تلاشهای تجاری معقولی را برای به حداقل رساندن جمعآوری و توزیع دادههای شخصی به کار خواهید گرفت.
قیمتگذاری
برای اطلاعات دقیق در مورد قیمت گذاری و مناطق موجود، به صفحه قیمت گذاری مراجعه کنید.
نقاط پایانی مدل
پیشنمایش ربات Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش پخش زنده Gemini Robotics ER 2
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-streaming-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی شده پشتیبانی نمیشود |
| گزینههای مصرف | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| کارت مدل | کارت مدل |
پیشنمایش Gemini Robotics ER 1.6
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-1.6-preview |
| انواع داده پشتیبانی شده را | ورودیها متن، تصویر، ویدئو، صدا خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ محدودیت توکن خروجی ۶۵,۵۳۶ |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده اتصال به زمین با نقشههای گوگل پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | دسامبر ۲۰۲۵ |
| حد آستانه دانش | ژانویه ۲۰۲۵ |
قدم بعدی چیست؟
- استدلال فضایی - اشاره کردن، ردیابی، تعیین محدوده، مسیرها.
- قابلیتهای عاملیتی - اجرای کد، خواندن ابزار، حاشیهنویسی تصویر.
- هماهنگسازی وظایف — وظایف بلندمدت با APIهای سفارشی ربات.
- رباتیک با استریمینگ — استریمینگ دوطرفه بلادرنگ (فقط Gemini Robotics ER 2).
- درک ویدیو — یافتن لحظه و طبقهبندی پیشرفت (فقط Gemini Robotics ER 2).
- ایمنی رباتیک گوگل دیپمایند - تحقیقات ایمنی پشت خانواده مدل.
مدلهای ER (استدلال تجسمی) Gemini Robotics، مدلهای زبان بینایی (VLM) هستند که به رباتها اجازه میدهند دنیای فیزیکی را درک کرده و با آن تعامل داشته باشند. آنها دادههای بصری را تفسیر میکنند، استدلال مکانی و زمانی انجام میدهند، وظایف چند مرحلهای را برنامهریزی میکنند و رباتها و ابزارها را هماهنگ میکنند.
مدلها
مدل Gemini Robotics ER 2 جدیدترین مدل در Gemini Robotics است. این مدل استدلال بهروز شده ما است که رباتها را قادر میسازد محیط خود را دقیقاً درک کنند. این مدل در قابلیتهای استدلال تجسمی، مانند هماهنگی عامل رباتها (مثلاً با استفاده از VLAها)، درک ویدیوی ربات از جمله درک پیشرفت و تشخیص موفقیت، خواندن ابزار، اشاره و استدلال فضایی تخصص دارد.
مدل Gemini Robotics ER 2 دو نقطه پایانی مدل را معرفی میکند:
-
gemini-robotics-er-2-preview: مدل استاندارد ER 2. بر اساس Gemini 3.5 Flash ساخته شده و استدلال فضایی، یافتن لحظات ویدیویی، طبقهبندی پیشرفت ویدیو، هماهنگی چند ربات و استفاده از ابزار چند مرحلهای بهبود یافته است. -
gemini-robotics-er-2-streaming-preview: برای جریانسازی بلادرنگ از طریق Live API بهینهسازی شده است. از این مدل برای رباتهای عامل با تأخیر کم که ورودیهای صوتی و تصویری مداوم را پردازش میکنند، استفاده کنید.
اگر از Gemini Robotics ER 1.6 استفاده میکنید، با جایگزینی model="gemini-robotics-er-1.6-preview" با model="gemini-robotics-er-2-preview" یا model="gemini-robotics-er-2-streaming-preview" در فراخوانیهای API خود، به Gemini Robotics ER 2 ارتقا دهید. توجه داشته باشید که مدل Gemini Robotics ER 1.6 در پایان ماه آگوست غیرفعال خواهد شد.
Gemini Robotics ER 2 را در استودیوی هوش مصنوعی گوگل امتحان کنید
قابلیتهای رباتیک
ربات Gemini Robotics ER از طیف وسیعی از قابلیتهای استدلال تجسمی پشتیبانی میکند. برای کسب اطلاعات بیشتر، یکی از قابلیتها را انتخاب کنید:
| قابلیت | توضیحات | راهنما |
|---|---|---|
| استدلال فضایی | به اشیاء اشاره کنید، آنها را در ویدیو ردیابی کنید، با جعبههای محدودکننده تشخیص دهید، مسیرها را برنامهریزی کنید. | استدلال فضایی |
| دیدگاه عاملگرایانه | با استفاده از ابزارهای دستکاری تصویر، از اجرای کد برای بهبود سایر قابلیتها استفاده کنید. | دیدگاه عاملگرایانه |
| هماهنگسازی وظایف | استدلال فضایی را با API های ربات سفارشی ترکیب کنید تا وظایف بلندمدت را انجام دهید. | هماهنگسازی وظایف |
| پخش جریانی (فقط نقطه پایانی پخش جریانی Gemini Robotics ER 2) | جریان دو طرفه برای عاملهای ربات بلادرنگ با فراخوانی تابع با تأخیر کم | پخش زنده برای رباتیک |
| پیشرفت ویدیویی (فقط Gemini Robotics ER 2) | یافتن لحظه و طبقهبندی پیشرفت از فیدهای ویدیویی پیوسته | درک ویدیو |
شروع به کار
مثال زیر اشیاء را در یک تصویر پیدا میکند و مختصات دوبعدی و برچسبهای نرمالشدهی آنها را برمیگرداند. میتوانید این خروجی را مستقیماً به یک API رباتیک یا یک مدل VLA ارسال کنید تا اقدامات ربات تولید شود.
پایتون
from google import genai
from google.genai import types

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

response = client.models.generate_content(
    model="gemini-robotics-er-2-preview",
    contents=[
        types.Part.from_uri(
            file_uri=uploaded_file.uri,
            mime_type=uploaded_file.mime_type
        ),
        PROMPT
    ],
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="high")
    ),
)

print(response.text)
استراحت
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/models/gemini-robotics-er-2-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [
      {
        "parts": [
          {
            "inlineData": {
              "mimeType": "image/png",
              "data": "'"${IMAGE_BASE64}"'"
            }
          },
          {
            "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
          }
        ]
      }
    ],
    "generationConfig": {
      "thinkingConfig": {
        "thinkingLevel": "high"
      }
    }
  }'
خروجی یک آرایه JSON حاوی اشیاء خواهد بود که هر کدام دارای یک point (مختصات نرمال شده [y, x] ) و یک label شناسایی کننده شیء هستند.
جیسون
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تصویر زیر نمونهای از نحوه نمایش این نقاط است:
چگونه کار میکند؟
Gemini Robotics ER ورودی تصویر، ویدئو یا صدا را با زبان طبیعی دریافت میکند. اشیاء را شناسایی میکند، دلایلی در مورد زمینه صحنه و روابط مکانی ارائه میدهد و خروجی ساختاریافتهای مانند مختصات یا جعبههای محصورکننده را برمیگرداند.
Gemini Robotics ER همچنین عاملگرا است: وظایف پیچیده را به زیروظایف تقسیم میکند و آنها را با فراخوانی توابع ربات شما یا اجرای کد تولید شده اجرا میکند. به عنوان مثال، "سیب را در کاسه بگذار" به دنبالهای از مراحل مکانیابی، گرفتن و قرار دادن تبدیل میشود.
برای جزئیات بیشتر در مورد نحوه اجرای فراخوانیهای ابزار در Gemini، به بخش فراخوانی تابع مراجعه کنید.
ایمنی
اگرچه ربات Gemini Robotics ER با در نظر گرفتن ایمنی ساخته شده است، اما مسئولیت حفظ محیط امن در اطراف ربات بر عهده شماست. مدلهای هوش مصنوعی مولد میتوانند اشتباه کنند و رباتهای فیزیکی میتوانند باعث آسیب شوند. برای کسب اطلاعات بیشتر، به صفحه ایمنی رباتیک Google DeepMind مراجعه کنید.
بهترین شیوهها
از زبان ساده و طبیعی استفاده کنید. کاری را که میخواهید ربات انجام دهد، همانطور که برای یک انسان انجام میدهید، توصیف کنید. اگر یک اصطلاح کارساز نبود، یک مترادف رایج را امتحان کنید.
ورودی بصری را بهینه کنید. قبل از ارسال تصویر، اشیاء کوچک یا نامشخص را برش دهید یا بزرگنمایی کنید. روشنایی و کنتراست رنگ پایین میتواند بر تشخیص تأثیر بگذارد.
وظایف پیچیده را به مراحل مختلف تقسیم کنید. هر مرحله را به عنوان یک دستورالعمل جداگانه ارسال کنید تا مدل متمرکز بماند و دقت بهبود یابد.
چندین بار پرس و جو کنید و برای وظایف با دقت بالا، میانگین نتایج را بگیرید. این رویکرد اجماع، واریانس در خروجیهای مکانی را کاهش میدهد.
محدودیتها
هنگام توسعه با Gemini Robotics ER، محدودیتهای زیر را در نظر بگیرید:
- محدودیتهای کلید API: رابط برنامهنویسی Gemini درخواستهای دریافتی از کلیدهای API بدون محدودیت را نمیپذیرد و خطای
403 Forbiddenرا برمیگرداند. با اضافه کردن محدودیتهایی در AI Studio ، کلید API خود را ایمن کنید. برای جزئیات بیشتر به Secure unlimited API keys مراجعه کنید. - تأخیر در مقابل عملکرد: پرسوجوهای پیچیده، ورودیهای با وضوح بالا یا سطوح بالای تفکر میتوانند منجر به افزایش زمان پردازش شوند. برای سطح تفکر از سطح متوسط استفاده کنید تا تعادل خوبی بین تأخیر و عملکرد برقرار شود.
- توهمات: مانند تمام مدلهای زبانی بزرگ، مدلهای ER Gemini Robotics میتوانند گاهی اوقات "توهم" داشته باشند یا اطلاعات نادرستی ارائه دهند، به خصوص برای دستورات مبهم یا ورودیهای خارج از توزیع.
- وابستگی به کیفیت دستور: کیفیت خروجی به وضوح دستور ورودی بستگی دارد. از دستورهای خاص و ساختارمند استفاده کنید.
- هزینه محاسباتی: اجرای مدل، به خصوص با ورودیهای ویدیویی یا
thinking_budgetبالا، منابع محاسباتی را مصرف میکند و هزینههایی را به همراه دارد. برای جزئیات بیشتر به صفحه Thinking مراجعه کنید. - انواع ورودی: برای جزئیات بیشتر در مورد محدودیتهای هر حالت، به مباحث زیر مراجعه کنید.
اطلاعیه حریم خصوصی
You acknowledge that the models referenced in this document (the "Robotics Models") leverage video and audio data in order to operate and move your hardware in accordance with your instructions. You therefore may operate the Robotics Models such that data from identifiable persons, such as voice, imagery, and likeness data ("Personal Data"), will be collected by the Robotics Models. If you elect to operate the Robotics Models in a manner that collects Personal Data, you agree that you will not permit any identifiable persons to interact with, or be present in the area surrounding, the Robotics Models, unless and until such identifiable persons have been sufficiently notified of and consented to the fact that their Personal Data may be provided to and used by Google as outlined in the Gemini API Additional Terms of Service found at https://ai.google.dev/gemini-api/terms (the "Terms"), including in accordance with the section entitled "How Google Uses Your Data". You will ensure that such notice permits the collection and use of Personal Data as outlined in the Terms, and you will use commercially reasonable efforts to minimize the collection and distribution of Personal Data by using techniques such as face blurring and operating the Robotics Models in areas not containing identifiable persons to the extent practicable.
قیمتگذاری
For detailed information on pricing and available regions, refer to the pricing page.
Model endpoints
Gemini Robotics ER 2 Preview
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-preview |
| انواع داده پشتیبانی شده را | Inputs Text, images, video, audio خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ Output token limit 65,536 |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده |
| گزینههای مصرف | پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| Model card | Model card |
Gemini Robotics ER 2 Streaming Preview
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-2-streaming-preview |
| انواع داده پشتیبانی شده را | Inputs Text, images, video, audio خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ Output token limit 65,536 |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی شده پشتیبانی نمیشود |
| گزینههای مصرف | پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | ژوئیه ۲۰۲۶ |
| Model card | Model card |
Gemini Robotics ER 1.6 Preview
| ملک | توضیحات |
|---|---|
| کد مدل | gemini-robotics-er-1.6-preview |
| انواع داده پشتیبانی شده را | Inputs Text, images, video, audio خروجی متن |
| محدودیتهای توکن [*] | محدودیت توکن ورودی ۱۳۱,۰۷۲ Output token limit 65,536 |
| قابلیتهای | پشتیبانی نمیشود پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی شده پشتیبانی نمیشود پشتیبانی نمیشود پشتیبانی شده Supported Supported Supported |
| گزینههای مصرف | Supported پشتیبانی نمیشود پشتیبانی نمیشود |
| نسخه |
|
| آخرین بهروزرسانی | دسامبر ۲۰۲۵ |
| Knowledge cutoff | ژانویه ۲۰۲۵ |
What's next
- Spatial reasoning — pointing, tracking, bounding boxes, trajectories.
- Agentic capabilities — code execution, instrument reading, image annotation.
- Task orchestration — long-horizon tasks with custom robot APIs.
- Robotics with streaming — real-time bidirectional streaming (Gemini Robotics ER 2 only).
- Video understanding — moment finding and progress classification (Gemini Robotics ER 2 only).
- Google DeepMind robotics safety — safety research behind the model family.