

Die Gemini Live API ermöglicht bidirektionale Sprachunterhaltungen in Echtzeit mit Gemini-Modellen.
Standard-Sprachmodelle eignen sich gut für den direkten Dialog. Sie sprechen mit dem Modell und es generiert sofort eine gesprochene Antwort. Wenn für eine Anfrage jedoch Planung, komplexe Analysen oder externe Tools erforderlich sind, stoßen direkte Antworten an ihre Grenzen. Das Modell muss entweder ohne Begründung antworten oder still pausieren, während es auf den Abschluss der Tools wartet.
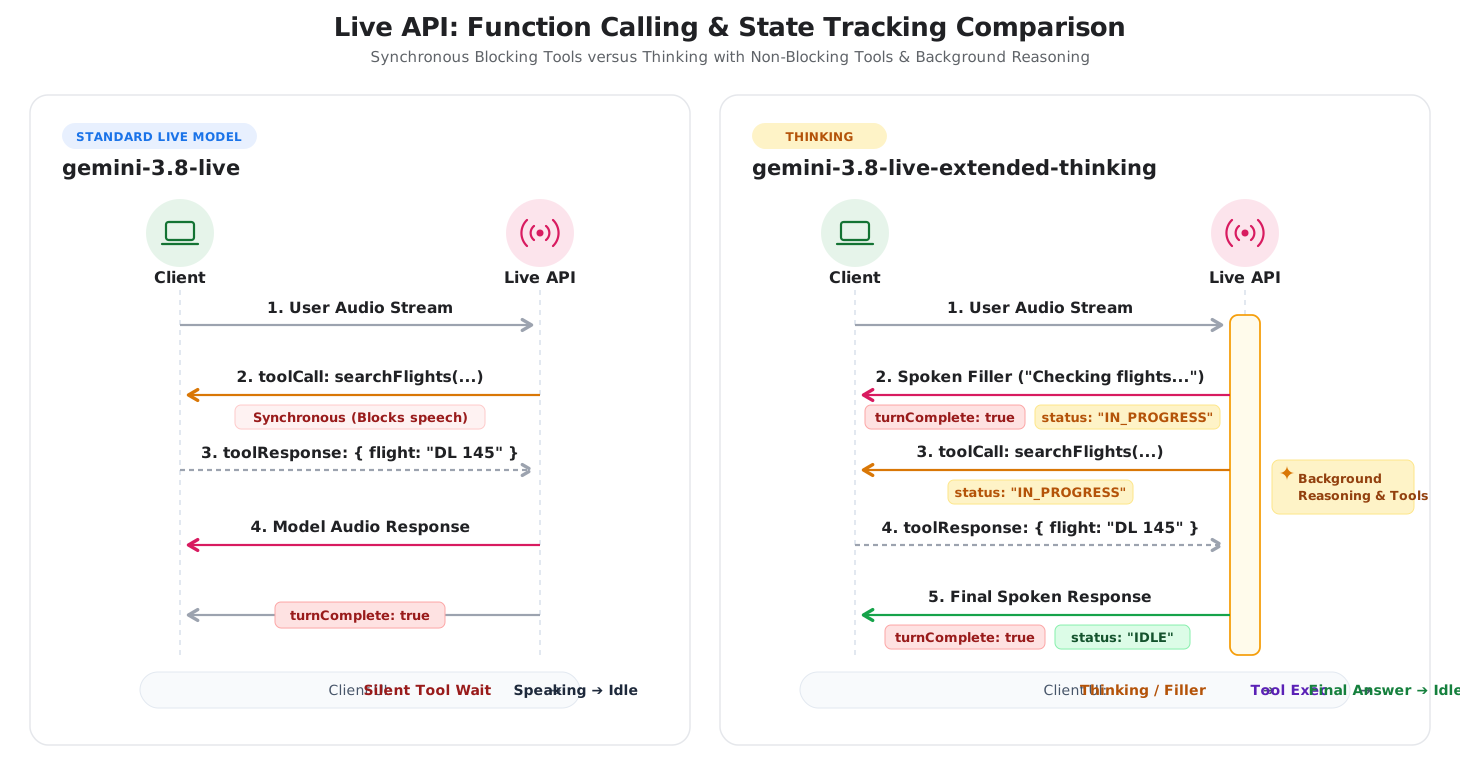
Wenn Sie in der Live API (gemini-3.8-live-extended-thinking) denken, wird den Echtzeit-Sprachsitzungen eine Hintergrundbegründung hinzugefügt. Das Modell plant und ruft asynchrone Tools im Hintergrund auf, während es natürliche Gesprächsfüller verwendet, um die Interaktion aktiv zu halten.
Diese Architektur ändert den Unterhaltungslebenszyklus auf zwei wichtige Arten:
- Gesprächsfüller: Das Modell gibt Zwischenupdates aus, z. B. „Ich suche jetzt nach Flugoptionen“, während es im Hintergrund Tools ausführt.
- Statusverfolgung von Interaktionen: Da das Modell während einer einzelnen Anfrage mehrmals sprechen kann, gibt der Server während der Hintergrundverarbeitung
interaction_status: "IN_PROGRESS"und nach Abschluss der Gesamtaufgabeinteraction_status: "IDLE"aus.
Im folgenden Diagramm werden die Interaktionslebenszyklen zwischen standardmäßigen Live-Sprachsitzungen und „Mit Hintergrundbegründung denken“ verglichen:
Das richtige Modell auswählen
Bei der Entscheidung zwischen gemini-3.8-live und gemini-3.8-live-extended-thinking sollten Sie drei Hauptaspekte berücksichtigen: Antwortlatenz, Komplexität der Aufgabe und Verarbeitung des Clientstatus.
Wann sollte Gemini 3.8 Live verwendet werden?
Verwenden Sie gemini-3.8-live für Sprachagenten mit niedriger Latenz, bei denen ein sofortiger Sprecherwechsel erforderlich ist und die Aufgaben direkt sind.
- Konversationelle Sprachassistenten: Kundenservice-Triage, Sprachübungen, Sprachsuche und interaktives Storytelling.
- Schnelle Tool-Ausführung: Workflows, bei denen externe Tools innerhalb von Millisekunden zurückgegeben werden (z. B. beim Lesen von Sensorwerten oder Steuern von Smart-Home-Geräten).
- Einfache Clientlogik: Anwendungen, in denen jeder Nutzerzug eine einzelne Modellantwort erhält und
turnComplete: truezuverlässig signalisiert, wenn die Sitzung im Leerlauf ist.
Wann sollte Gemini 3.8 Live Extended Thinking verwendet werden?
Verwenden Sie gemini-3.8-live-extended-thinking, wenn Ihr Agent komplexe Daten auswerten, mehrere Schritte planen oder Tools verarbeiten muss, deren Ausführung mehrere Sekunden dauert.
- Mehrstufige Diagnose und Support: Kundenservicemitarbeiter diagnostizieren Systemprobleme anhand mehrerer Protokolle, Fehlercodes und Konfigurationsprüfungen.
- Koordinierter Datenabruf: Reise- und Buchungsagenten, die Flüge suchen, Hotels abfragen und Preise über parallele API-Aufrufe vergleichen.
- Nachhilfe in MINT-Fächern und Programmieren: Bildungs-Agents, die Formeln überprüfen, Code debuggen oder mehrstufige Logik durchgehen, bevor sie eine Erklärung ausgeben.
- Latenz des Maskierungstools: Sprachfunktionen, bei denen Funktionen mit langer Ausführungszeit ansonsten zu unangenehmer Stille für den Zuhörer führen würden.
Zusammenfassung der wichtigsten Unterschiede
In der folgenden Tabelle werden die technischen Unterschiede zwischen den beiden Modellen zusammengefasst:
| Funktion | Gemini 3.8 Live | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| Primäre Anwendungsfälle | Sprachagenten mit niedriger Latenz, direkte Befehle, schnelle Tools | Mehrstufige Problemlösung, komplexe Planung, Workflows mit mehreren Tools |
| Modell-Endpunkt | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| Reasoning-Architektur | Verschachtelte Argumentation mit festem Latenzprofil (thinking_level wird nicht unterstützt) |
Konfigurierbare Hintergrundinformationen (thinking_level: low, medium, high; MINIMAL wird nicht unterstützt) |
| Abbiegehinweise | turnComplete: true beendet den Zug und kehrt in den Leerlauf zurück. |
turnComplete: true beendet eine Äußerung; interaction_status steuert den Sitzungslebenszyklus |
| Füllwörter | Das Modell wartet mit der Antwort, bis das Tool ausgeführt wurde | Das Modell streamt während der Verarbeitung Zwischeninhalte für die Unterhaltung. |
| Tool-Ausführung | Unterstützt synchrone (BLOCKING) und asynchrone (NON_BLOCKING) Tools |
Erfordert asynchrone (NON_BLOCKING) Tool-Deklarationen |
Migrations- und Einbindungswege
So aktualisieren Sie vorhandene Sprachanwendungen oder binden Thinking in Ihre Live API-Sitzungen ein:
Upgrade von Gemini 3.1 Flash Live
Bei vorhandenen Sprachanwendungen, die gemini-3.1-flash-live-preview verwenden, muss beim Upgrade auf gemini-3.8-live der Modellstring aktualisiert und thinking_level (oder thinking_config) aus der Einrichtungskonfiguration entfernt werden, da thinking_level für gemini-3.8-live nicht unterstützt wird:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Der Lebenszyklus des Zuges und die turnComplete-Signale bleiben unverändert.
Denkprozess übernehmen
Um gemini-3.8-live-extended-thinking zu übernehmen, müssen Sie drei Integrationspunkte aktualisieren:
interaction_statusanstelle vonturnCompleteverfolgen: In Thinking-Sitzungen kann das Modell während der Argumentation Zwischenfüller ausgeben. Prüfen Sie das Feldinteraction_statusin eingehenden Servernachrichten, um den UI-Status zu verwalten. Nur in den Leerlauf zurückkehren, wenninteraction_statusIDLEist.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Nicht blockierende Funktionen deklarieren: Setzen Sie
"behavior": "NON_BLOCKING"für alle Funktionsdeklarationen. Thinking-Modelle führen Tools asynchron im Hintergrund aus, während sie verbale Updates streamen. Synchrone Blockierungstools geben einen Fehler zurück.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Detailgrad der Problemlösung konfigurieren: Legen Sie
thinking_configin Ihrer Sitzungskonfiguration fest, um den Detailgrad der Problemlösung anzupassen (low,mediumoderhigh;MINIMALwird nicht unterstützt).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Direkter Protokollvergleich
In diesem Abschnitt werden die WebSocket-Nachrichten verglichen, die in den einzelnen Phasen einer Live API-Sitzung ausgetauscht werden.
Schritt 1: Sitzung einrichten
Beide Modelle stellen eine Verbindung zum selben WebSocket-Endpunkt her:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identisch: WebSocket-URL und API-Schlüssel-Authentifizierung.
- Modellstring:
gemini-3.8-liveim Vergleich zugemini-3.8-live-extended-thinking. - Konfiguration des Denkprozesses: Durch „Thinking“ wird
thinkingConfighinzugefügt, um die Tiefe des Denkprozesses anzupassen. Tool-Verhalten: Für die Denkphase sind
"behavior": "NON_BLOCKING"für Funktionsdeklarationen erforderlich.
Gemini 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Beide Modelle erhalten bei der Verbindung dieselbe Serverbestätigung:
{
  "setupComplete": {}
}
Schritt 2: Audioeingabe des Nutzers
Das Audiostreaming ist bei beiden Modellen identisch. Echtzeit-Audio-Chunks im rohen PCM-Format mit 16 kHz werden über realtimeInput gestreamt:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Schritt 3: Modellreaktion und Statuslebenszyklus
Beide Modelle streamen 24 kHz-PCM-Audioblöcke in serverContent.modelTurn. Die Lebenszyklusverwaltung unterscheidet sich jedoch:
Gemini 3.8 – Live-Antwortablauf
- Der Server streamt Audio-Chunks für den Turn.
- Der Server sendet
turnComplete: true, was darauf hinweist, dass das Modell mit dem Sprechen fertig ist und die Sitzung inaktiv ist.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Gemini 3.8 Live Extended Thinking-Antwortablauf
- Gesprochene Füllwörter: Das Modell gibt Zwischenansagen aus (z. B. „Suche nach Flügen nach Seattle…“) mit
turnComplete: trueundinteractionStatus: "IN_PROGRESS". - Asynchroner Toolaufruf: Der Server gibt den Toolaufruf aus, während
interactionStatusweiterhin"IN_PROGRESS"ist. Das bedeutet, dass der Server den mehrstufigen Turn aktiv verarbeitet und auf die Toolantwort wartet. - Tool-Antwort: Der Client führt die Funktion aus und gibt die Ausgabe zurück.
- Endgültige Antwort: Der Server liefert die vollständige Antwort mit
turnComplete: trueundinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Beispiele für die SDK-Implementierung
In den folgenden Beispielen wird gezeigt, wie Sie die Denkphase konfigurieren und interaction_status mit dem Google GenAI SDK verarbeiten.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Nächste Schritte
- Lesen Sie die Modellseiten Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking.
- In der Modellvergleich-Tabelle finden Sie einen detaillierten Vergleich der Funktionen aller Live-API-Modelle.
- Weitere Informationen zu Funktionsaufrufen finden Sie im Leitfaden Live API Tool use.
- Informationen zum Verarbeiten von Sitzungswiederaufnahme und Kontextlebenszyklus finden Sie unter Sitzungsverwaltung.