

ממשק Gemini Live API מאפשר לנהל שיחות קוליות דו-כיווניות בזמן אמת עם מודלים של Gemini.
מודלים סטנדרטיים של קול מתאימים לדיאלוגים מיידיים. אתם מדברים עם המודל, והוא יוצר תשובה קולית באופן מיידי. אבל כשבקשה דורשת תכנון, ניתוח מורכב או שימוש בכלים חיצוניים, התשובות הישירות מוגבלות. המודל צריך לענות בלי חשיבה רציונלית או להשהות את עצמו בשקט בזמן שהוא מחכה שהכלים יסיימו את הפעולה.
השימוש ב-Live API (gemini-3.8-live-extended-thinking) מוסיף חשיבה רציונלית ברקע לשיחות קוליות בזמן אמת. המודל מתכנן וקורא כלים אסינכרוניים ברקע, תוך כדי שהוא משתמש במילות קישור טבעיות כדי לשמור על האינטראקציה פעילה.
הארכיטקטורה הזו משנה את מחזור החיים של השיחה בשתי דרכים עיקריות:
- מילות קישור: המודל משמיע עדכונים ביניים (למשל, 'בודק עכשיו אפשרויות לטיסה') בזמן שהוא מפעיל כלים ברקע.
- מעקב אחר סטטוס האינטראקציה: מכיוון שהמודל יכול לדבר כמה פעמים במהלך בקשה אחת, השרת פולט
interaction_status: "IN_PROGRESS"במהלך עיבוד הרקע ו-interaction_status: "IDLE"כשהמשימה הכוללת מסתיימת.
בתרשים הבא מוצגת השוואה בין מחזורי החיים של אינטראקציות בשיחות רגילות עם קול לבין מחזורי החיים של אינטראקציות בשיחות עם קול שבהן נעשה שימוש בשיקולים ברקע:
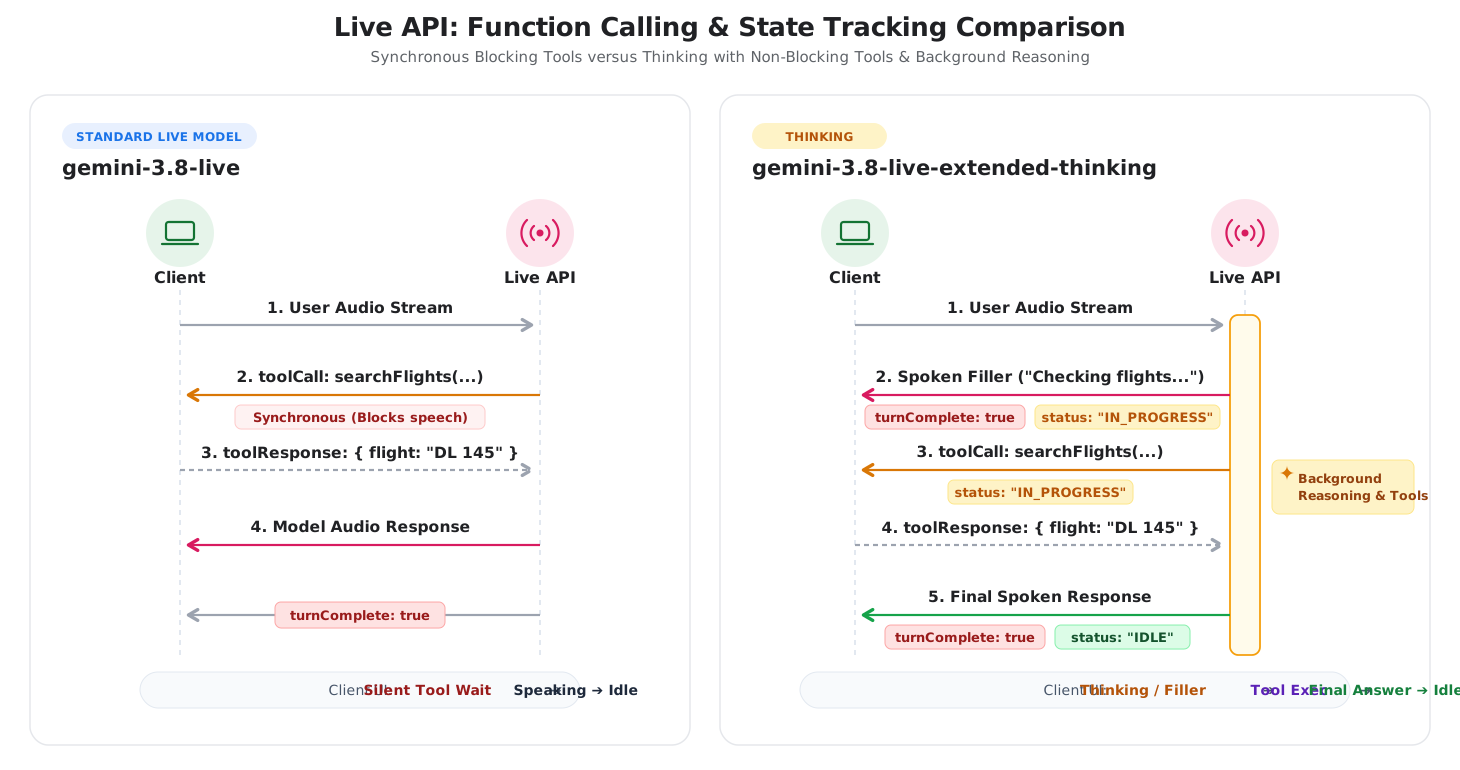
בחירת המודל המתאים
כשמתלבטים בין gemini-3.8-live לבין gemini-3.8-live-extended-thinking, כדאי לשקול שלושה שיקולים עיקריים: זמן האחזור של התגובה, מורכבות המשימה וטיפול במצב הלקוח.
מתי כדאי להשתמש ב-Gemini 3.8 במצב לייב
משתמשים ב-gemini-3.8-live לסוכנים קוליים לשיחות עם זמן אחזור נמוך, שבהם חיוני להעביר את התור לדיבור באופן מיידי והמשימות הן ישירות.
- אסיסטנטים קוליים לצ'אט עם AI: מיון של פניות לשירות לקוחות, תרגול שפה, חיפוש קולי וסיפור אינטראקטיבי.
- ביצוע מהיר של כלים: תהליכי עבודה שבהם כלים חיצוניים מחזירים תוצאות תוך אלפיות השנייה (למשל קריאת ערכי חיישנים או שליטה במכשירים חכמים).
- לוגיקה פשוטה של לקוח: אפליקציות שבהן כל תור של משתמש מקבל תגובה אחת מהמודל, ו
turnComplete: trueמסמנות באופן מהימן מתי הסשן לא פעיל.
מתי כדאי להשתמש ב-Gemini 3.8 במצב לייב עם חשיבה מעמיקה
מומלץ להשתמש ב-gemini-3.8-live-extended-thinking כשהסוכן צריך להעריך נתונים מורכבים, לתכנן כמה שלבים או להשתמש בכלים שלוקח להם כמה שניות לפעול.
- אבחון ותמיכה בכמה שלבים: נציגי התמיכה הטכנית מאבחנים בעיות במערכת בכמה יומנים, קודי שגיאה ובדיקות הגדרה.
- אחזור נתונים מתואם: סוכני נסיעות והזמנות שמחפשים טיסות, שולחים שאילתות לגבי מלונות ומשווים מחירים באמצעות קריאות מקבילות ל-API.
- שיעורים פרטיים במדעים, טכנולוגיה, הנדסה ומתמטיקה (STEM) ובקוד: סוכנים חינוכיים שמאמתים נוסחאות, מנפים באגים בקוד או פועלים לפי לוגיקה מורכבת לפני שהם מסבירים.
- השהיה בכלי ההסתרה: חוויות קוליות שבהן פונקציות שפועלות לאורך זמן יוצרות שקט מביך למאזין.
סיכום ההבדלים העיקריים
בטבלה הבאה מסוכמים ההבדלים הטכניים בין שני המודלים:
| תכונה | Gemini 3.8 במצב לייב | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| תרחישים ראשיים לדוגמה | סוכנים קוליים עם השהיה נמוכה, פקודות ישירות, כלים מהירים | פתרון בעיות בכמה שלבים, תכנון מורכב, תהליכי עבודה עם כמה כלים |
| נקודת קצה של המודל | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| ארכיטקטורת חשיבה רציונלית | הסקה משולבת עם פרופיל חביון קבוע (thinking_level לא נתמך) |
הסקה ניתנת להגדרה ברקע (thinking_level: low, medium, high; MINIMAL לא נתמך) |
| הפעלת גבולות | turnComplete: true סוגר את התור וחוזר למצב המתנה |
turnComplete: true מסיים אמירה; interaction_status שולט במחזור החיים של הסשן |
| מילות קישור | המודל ממתין להרצת הכלי לפני שהוא מדבר | המערכת מעבדת את המידע ומציגה מילים או ביטויים שמשמשים למילוי פערים בשיחה |
| הפעלת הכלי | תמיכה בכלי סינכרוני (BLOCKING) ואסינכרוני (NON_BLOCKING) |
נדרשות הצהרות על כלים אסינכרוניים (NON_BLOCKING) |
מסלולי העברה ושילוב
כדי לשדרג אפליקציות קיימות לשיחות קוליות או לשלב את Thinking בסשנים של Live API, צריך לפעול לפי השלבים הבאים.
שדרוג מ-Gemini 3.1 Flash Live
אם יש לכם אפליקציות קוליות קיימות שמשתמשות ב-gemini-3.1-flash-live-preview, כדי לשדרג ל-gemini-3.8-live צריך לעדכן את מחרוזת המודל ולהשמיט את thinking_level (או את thinking_config) מהגדרת ההגדרה, כי thinking_level לא נתמך ב-gemini-3.8-live:
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
מחזור החיים של התור ואותות turnComplete נשארים זהים.
אימוץ חשיבה
כדי להטמיע את gemini-3.8-live-extended-thinking, צריך לעדכן שלוש נקודות שילוב:
מעקב אחרי
interaction_statusבמקוםturnComplete: בסשנים של חשיבה, המודל יכול להשתמש במילות קישור כדי להסביר את תהליך החשיבה שלו. בודקים את השדהinteraction_statusבהודעות שרת נכנסות כדי לנהל את מצב ממשק המשתמש. החזרה למצב לא פעיל רק אםinteraction_statusהואIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
הצהרה על פונקציות לא חוסמות: מגדירים את
"behavior": "NON_BLOCKING"בכל ההצהרות של הפונקציות. מודלים של חשיבה מפעילים כלים באופן אסינכרוני ברקע בזמן שהם משדרים עדכונים מילוליים. כלי חסימה סינכרוניים מחזירים שגיאה.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
הגדרת עומק הנימוקים: כדי לשנות את רמות הנימוקים (
low, mediumאוhigh;MINIMALלא נתמכת), צריך להגדיר אתthinking_configבהגדרות הסשן.Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
השוואת פרוטוקולים בטבלה
בקטע הזה מוצגת השוואה בין הודעות WebSocket שהועברו במהלך כל שלב בסשן של Live API.
שלב 1: הגדרת הסשן
שני המודלים מתחברים לאותה נקודת קצה של WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- זהה: אימות של כתובת ה-URL של WebSocket ומפתח ה-API.
- מחרוזת מודל:
gemini-3.8-liveלעומתgemini-3.8-live-extended-thinking. - הגדרת חשיבה: התכונה 'חשיבה' מוסיפה
thinkingConfigכדי להתאים את עומק ההיגיון. התנהגות הכלי: כדי להשתמש ב'חשיבה' צריך להגדיר את
"behavior": "NON_BLOCKING"בהצהרות על פונקציות.
Gemini 3.8 במצב לייב
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Gemini 3.8 Live Extended Thinking
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
שני המודלים מקבלים את אותו אישור מהשרת עם החיבור:
{
  "setupComplete": {}
}
שלב 2: קלט אודיו מהמשתמש
הזרמת האודיו זהה בשני הדגמים. נתחי אודיו גולמיים בפורמט PCM של 16kHz בזמן אמת מועברים בסטרימינג באמצעות realtimeInput:
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
שלב 3: מחזור החיים של התשובה והמצב של המודל
שני הדגמים משדרים נתחי אודיו PCM של 24kHz בפורמט serverContent.modelTurn. עם זאת, יש הבדלים בניהול מחזור החיים:
תהליך התשובה בזמן אמת ב-Gemini 3.8
- השרת מעביר נתחי אודיו בתורו.
- השרת שולח
turnComplete: true, שמציין שהמודל סיים לדבר והסשן לא פעיל.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
תהליך התשובה של Gemini 3.8 Live Extended Thinking
- מילת קישור בדיבור: המודל משמיע דיבור ביניים (למשל, "Checking flights to Seattle...") עם
turnComplete: trueו-interactionStatus: "IN_PROGRESS". - קריאה אסינכרונית לכלי: השרת פולט את הקריאה לכלי בזמן ש-
interactionStatusנשאר"IN_PROGRESS", מה שמצביע על כך שהשרת מעבד באופן פעיל את התור הרב-שלבי וממתין לתגובה מהכלי. - תגובה של הכלי: הלקוח מפעיל את הפונקציה ומחזיר את הפלט.
- תשובה סופית: השרת מספק את התשובה המלאה עם
turnComplete: trueו-interactionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
דוגמאות להטמעה של SDK
בדוגמאות הבאות מוסבר איך להגדיר את התכונה 'חשיבה' ולטפל ב-interaction_status באמצעות Google GenAI SDK.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
המאמרים הבאים
- אפשר לקרוא את הדפים של המודלים Gemini 3.8 Live ו-Gemini 3.8 Live Extended Thinking.
- בטבלה השוואה בין מודלים מפורטות השוואות בין התכונות של כל המודלים של Live API.
- מידע נוסף על שימוש בפונקציות זמין במדריך שימוש בכלי API בזמן אמת.
- כדאי לעיין במאמר בנושא ניהול סשנים כדי להבין איך לטפל בהמשך של סשנים ובמחזור החיים של ההקשר.