

API-ja Gemini Live mundëson biseda zanore në kohë reale, dypalëshe, me modelet Gemini.
Modelet standarde të zërit funksionojnë mirë për dialog të menjëhershëm. Ju i flisni modelit dhe ai gjeneron menjëherë një përgjigje të folur. Por kur një kërkesë kërkon planifikim, analizë komplekse ose mjete të jashtme, përgjigjet e drejtpërdrejta arrijnë një kufi. Modeli duhet ose të përgjigjet pa arsyetim ose të ndalet në heshtje ndërsa pret që mjetet të përfundojnë.
Thinking in the Live API ( gemini-3.8-live-extended-thinking ) shton arsyetim në sfond në seancat zanore në kohë reale. Modeli planifikon dhe thërret mjete asinkrone në sfond, ndërsa përdor mbushës natyralë bisedorë për ta mbajtur bashkëveprimin aktiv.
Kjo arkitekturë e ndryshon ciklin jetësor të bisedës në dy mënyra kryesore:
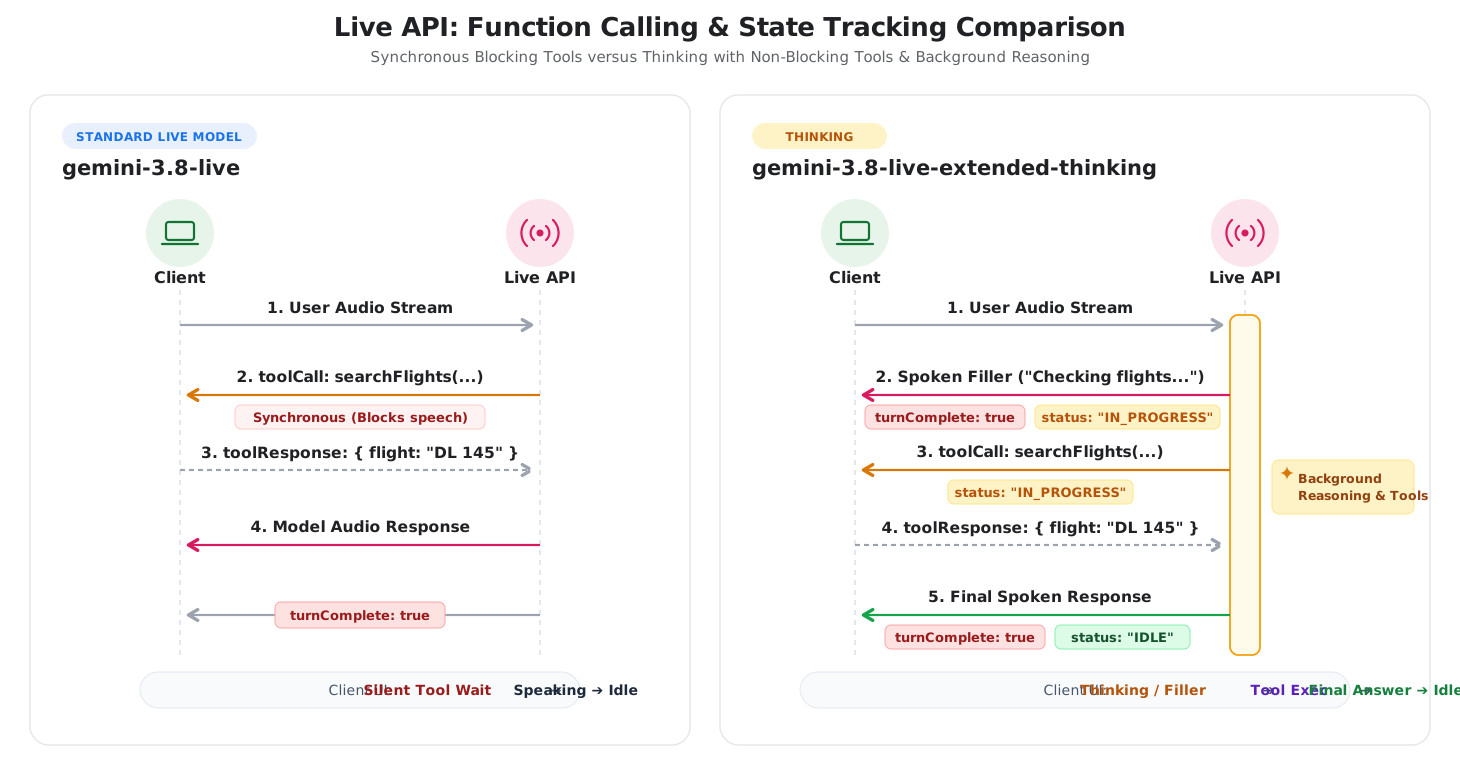
- Mbushës bisedor : Modeli shqipton përditësime të ndërmjetme (si p.sh. "Po kontrollojmë opsionet e fluturimit tani") ndërsa ekzekuton mjete në sfond.
- Gjurmimi i statusit të ndërveprimit : Meqenëse modeli mund të flasë shumë herë gjatë një kërkese të vetme, serveri lëshon
interaction_status: "IN_PROGRESS"gjatë përpunimit në sfond dheinteraction_status: "IDLE"kur detyra e përgjithshme përfundon.
Diagrama e mëposhtme krahason ciklet e ndërveprimit midis seancave standarde të zërit Live dhe të Mendimit me arsyetim në sfond:
Zgjedhja e modelit të duhur
Kur vendosni midis gemini-3.8-live dhe gemini-3.8-live-extended-thinking , merrni në konsideratë tre faktorë kryesorë: vonesën e përgjigjes, kompleksitetin e detyrës dhe trajtimin e gjendjes së klientit.
Kur të përdorni Gemini 3.8 Live
Përdorni gemini-3.8-live për agjentë zanorë bisedorë me latencë të ulët ku marrja e menjëhershme e radhës është thelbësore dhe detyrat janë të drejtpërdrejta.
- Asistentë zëri bisedor : Triazhi i shërbimit ndaj klientit, praktika gjuhësore, kërkimi me zë dhe rrëfimi interaktiv i historive.
- Ekzekutim i shpejtë i mjeteve : Rrjedha pune ku mjetet e jashtme kthehen brenda milisekondave (siç është leximi i vlerave të sensorëve ose kontrollimi i pajisjeve inteligjente).
- Logjikë e thjeshtë e klientit : Aplikacione ku çdo përdorues merr një përgjigje të vetme modeli, dhe
turnComplete: truesinjalizon në mënyrë të besueshme kur seanca është në gjendje joaktive.
Kur duhet të përdoret Gemini 3.8 Live Extended Thinking
Përdorni gemini-3.8-live-extended-thinking kur agjenti juaj duhet të vlerësojë të dhëna komplekse, të planifikojë hapa të shumtë ose të trajtojë mjete që duhen disa sekonda për t'u ekzekutuar.
- Diagnostikim dhe mbështetje me shumë hapa : Agjentë të mbështetjes teknike diagnostikojnë problemet e sistemit nëpër regjistra të shumëfishtë, kode gabimesh dhe kontrolle konfigurimi.
- Marrja e koordinuar e të dhënave : Agjentë udhëtimesh dhe rezervimesh që kërkojnë fluturime, pyesin për hotele dhe krahasojnë çmimet përmes thirrjeve paralele API.
- Mësimdhënie STEM dhe kodi : Agjentë edukativë që verifikojnë formulat, debugojnë kodin ose punojnë me logjikën shumëhapëshe përpara se të japin një shpjegim.
- Latencia e mjetit të maskimit : Përvoja zanore ku funksionet që ekzekutohen për një kohë të gjatë do të krijonin heshtje të sikletshme për dëgjuesin.
Përmbledhje e dallimeve kryesore
Tabela më poshtë përmbledh ndryshimet teknike midis dy modeleve:
| Karakteristikë | Binjakët 3.8 Live | Binjakët 3.8 Jeto Mendimin e Zgjeruar |
|---|---|---|
| Rastet e përdorimit kryesor | Agjentë zanorë me vonesë të ulët, komanda të drejtpërdrejta, mjete të shpejta | Zgjidhje problemesh me shumë hapa, planifikim kompleks, rrjedha pune me shumë mjete |
| Pika fundore e modelit | gemini-3.8-live | gemini-3.8-live-extended-thinking |
| Arkitektura e arsyetimit | Arsyetim i ndërthurur me profil latence fikse ( thinking_level nuk mbështetet) | Arsyetim i sfondit i konfigurueshëm ( thinking_level : low , medium , high ; MINIMAL nuk mbështetet) |
| Kufijtë e kthesës | turnComplete: true mbyll kthesën dhe kthehet në gjendje joaktive | turnComplete: true përfundon një shprehje; interaction_status kontrollon ciklin jetësor të sesionit |
| Mbushës bisedash | Modeli pret ekzekutimin e mjetit përpara se të flasë | Modeli transmeton mbushës të ndërmjetëm bisedash gjatë përpunimit |
| Ekzekutimi i mjetit | Mbështet mjete sinkrone ( BLOCKING ) dhe asinkrone ( NON_BLOCKING ) | Kërkon deklarata asinkrone ( NON_BLOCKING ) të mjeteve |
Shtigjet e migrimit dhe integrimit
Ndiqni këto hapa për të përmirësuar aplikacionet ekzistuese zanore ose për të integruar Thinking në seancat tuaja Live API.
Përmirësimi nga Gemini 3.1 Flash Live
Për aplikacionet ekzistuese zanore që përdorin gemini-3.1-flash-live-preview , përmirësimi në gemini-3.8-live kërkon përditësimin e vargut të modelit dhe heqjen e thinking_level (ose thinking_config ) nga konfigurimi juaj i konfigurimit, pasi thinking_level nuk mbështetet për gemini-3.8-live :
{
  "setup": {
    "model": "models/gemini-3.8-live"
  }
}
Cikli jetësor i turn-it dhe sinjalet turnComplete mbeten identike.
Përvetësimi i të menduarit
Për të adoptuar gemini-3.8-live-extended-thinking , përditësoni tre pika integrimi:
Gjurmimi i
interaction_statusnë vend tëturnComplete: Në sesionet e të menduarit, modeli mund të lëshojë mbushës të ndërmjetëm bisedor gjatë arsyetimit. Inspektoni fushëninteraction_statusnë mesazhet hyrëse të serverit për të menaxhuar gjendjen e ndërfaqes së përdoruesit. Kthehuni në gjendje joaktive vetëm kurinteraction_statusështëIDLE.Python
status = getattr(message, "interaction_status", None)
if status == "IDLE":
    # Ready for user input
    set_ui_state("listening")
elif status == "IN_PROGRESS":
    # Reasoning or executing tools
    set_ui_state("thinking")
JavaScript
if (message.interactionStatus === 'IDLE') {
  // Ready for user input
  setUiState('listening');
} else if (message.interactionStatus === 'IN_PROGRESS') {
  // Reasoning or executing tools
  setUiState('thinking');
}
Deklaroni funksionet jo-bllokuese : Vendosni
"behavior": "NON_BLOCKING"në të gjitha deklaratat e funksioneve. Modelet e të menduarit ekzekutojnë mjete në mënyrë asinkrone në sfond ndërsa transmetojnë përditësime verbale. Mjetet sinkrone të bllokimit kthejnë një gabim.Python
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"},
        },
        "required": ["destination"],
    },
)
JavaScript
const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' },
    },
    required: ['destination'],
  },
};
Konfiguro thellësinë e arsyetimit : Vendos
thinking_confignë konfigurimin e sesionit tënd për të rregulluar nivelet e arsyetimit (low,mediumosehigh;MINIMALnuk mbështetet).Python
config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low",
    ),
    tools=[types.Tool(function_declarations=[search_flights])],
)
JavaScript
const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low',
  },
  tools: [{ functionDeclarations: [searchFlights] }],
};
Krahasimi i protokollit krah për krah
Ky seksion krahason mesazhet WebSocket të shkëmbyera gjatë secilës fazë të një sesioni Live API.
Hapi 1: Konfigurimi i sesionit
Të dy modelet lidhen me të njëjtën pikë fundore WebSocket:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=$API_KEY
- Identike : Autentifikimi i URL-së së WebSocket dhe çelësit API.
- Vargu i modelit :
gemini-3.8-livekundrejtgemini-3.8-live-extended-thinking. - Konfigurimi i të menduarit : Thinking shton
thinkingConfigpër të rregulluar thellësinë e arsyetimit. Sjellja e mjetit : Të menduarit kërkon
"behavior": "NON_BLOCKING"në deklaratat e funksionit.
Binjakët 3.8 Live
{
  "setup": {
    "model": "models/gemini-3.8-live",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      }
    }
  }
}
Binjakët 3.8 Jeto Mendimin e Zgjeruar
{
  "setup": {
    "model": "models/gemini-3.8-live-extended-thinking",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "speechConfig": {
        "voiceConfig": {
          "prebuiltVoiceConfig": {
            "voiceName": "Puck"
          }
        }
      },
      "thinkingConfig": {
        "thinkingLevel": "LOW"
      }
    },
    "tools": [{
      "functionDeclarations": [{
        "name": "searchFlights",
        "description": "Searches for flights between cities.",
        "behavior": "NON_BLOCKING",
        "parameters": {
          "type": "OBJECT",
          "properties": {
            "destination": { "type": "STRING" }
          },
          "required": ["destination"]
        }
      }]
    }]
  }
}
Të dy modelet marrin të njëjtën konfirmim të serverit pas lidhjes:
{
  "setupComplete": {}
}
Hapi 2: Futja audio e përdoruesit
Transmetimi audio është identik në të dy modelet. Pjesët audio të papërpunuara PCM në kohë reale 16kHz transmetohen duke përdorur realtimeInput :
{
  "realtimeInput": {
    "audio": {
      "data": "UklGRiQAAABXQVZF...",
      "mimeType": "audio/pcm;rate=16000"
    }
  }
}
Hapi 3: Përgjigja e modelit dhe cikli jetësor i gjendjes
Të dy modelet transmetojnë pjesë audio PCM 24kHz në serverContent.modelTurn . Megjithatë, menaxhimi i ciklit jetësor ndryshon:
Fluksi i përgjigjes së drejtpërdrejtë Gemini 3.8
- Serveri transmeton pjesë audio për raundin.
- Serveri dërgon
turnComplete: true, duke treguar që modeli ka mbaruar së foluri dhe seanca është në gjendje joaktive.
// 1. Audio stream chunks
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    }
  }
}

// 2. Turn completion -> Signals client to switch UI to Idle/Listening
{
  "serverContent": {
    "turnComplete": true
  }
}
Rrjedha e përgjigjes së të menduarit të zgjatur të Binjakëve 3.8
- Mbushës i folur : Modeli lëshon të folur të ndërmjetme (si p.sh. "Duke kontrolluar fluturimet për në Seattle..." ) me
turnComplete: truedheinteractionStatus: "IN_PROGRESS". - Thirrje asinkrone e mjetit : Serveri lëshon thirrjen e mjetit ndërsa
interactionStatusmbetet"IN_PROGRESS", duke treguar që serveri po përpunon në mënyrë aktive kthesën shumëhapëshe dhe po pret përgjigjen e mjetit. - Përgjigja e mjetit : Klienti ekzekuton funksionin dhe kthen rezultatin.
- Përgjigja përfundimtare : Serveri jep përgjigjen e plotë me
turnComplete: truedheinteractionStatus: "IDLE".
// 1. Spoken verbal filler while background reasoning proceeds
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "turnComplete": true,
    "interactionStatus": "IN_PROGRESS"
  }
}

// 2. Asynchronous tool call emitted with IN_PROGRESS status
{
  "toolCall": {
    "functionCalls": [
      {
        "id": "call_123",
        "name": "searchFlights",
        "args": {
          "destination": "Seattle"
        }
      }
    ]
  },
  "interactionStatus": "IN_PROGRESS"
}

// 3. Client executes function and returns result
{
  "toolResponse": {
    "functionResponses": [
      {
        "response": {
          "output": {
            "flight": "DL 145",
            "price": "$145"
          }
        },
        "id": "call_123"
      }
    ]
  }
}

// 4. Final spoken answer delivered -> session transitions to IDLE when done
{
  "serverContent": {
    "modelTurn": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "audio/pcm;rate=24000",
            "data": "..."
          }
        }
      ]
    },
    "interactionStatus": "IDLE",
    "turnComplete": true
  }
}
Shembuj të implementimit të SDK-së
Shembujt e mëposhtëm tregojnë se si të konfiguroni Thinking dhe të trajtoni interaction_status duke përdorur SDK-në Google GenAI.
Python
import asyncio
from google import genai
from google.genai import types

client = genai.Client()
model = "gemini-3.8-live-extended-thinking"

# Define non-blocking function declaration
search_flights = types.FunctionDeclaration(
    name="search_flights",
    description="Searches for available flights to a destination.",
    behavior="NON_BLOCKING",
    parameters={
        "type": "OBJECT",
        "properties": {
            "destination": {"type": "STRING"}
        },
        "required": ["destination"]
    }
)

config = types.LiveConnectConfig(
    response_modalities=["AUDIO"],
    thinking_config=types.ThinkingConfig(
        thinking_level="low"
    ),
    tools=[types.Tool(function_declarations=[search_flights])]
)

async def main():
    async with client.aio.live.connect(model=model, config=config) as session:
        print("Session connected with Thinking")

        async for message in session.receive():
            # Inspect interaction status for server lifecycle tracking
            status = getattr(message, "interaction_status", None)
            if status:
                print(f"Interaction status: {status}")

            # Handle audio output parts
            if message.server_content and message.server_content.model_turn:
                for part in message.server_content.model_turn.parts:
                    if part.inline_data:
                        # Process 24kHz audio chunk
                        pass

            # Handle asynchronous tool call
            if message.tool_call:
                for call in message.tool_call.function_calls:
                    print(f"Executing tool: {call.name}")
                    # Simulate function execution
                    response = types.FunctionResponse(
                        id=call.id,
                        name=call.name,
                        response={"result": "Flight DL 145 ($145)"}
                    )
                    await session.send_tool_response(
                        function_responses=[response]
                    )

            # Status is IDLE when reasoning and all turns are complete
            if status == "IDLE":
                print("Session is idle and ready for user input.")

if __name__ == "__main__":
    asyncio.run(main())
JavaScript
import { GoogleGenAI, Modality } from '@google/genai';

const ai = new GoogleGenAI({});
const model = 'gemini-3.8-live-extended-thinking';

const searchFlights = {
  name: 'search_flights',
  description: 'Searches for available flights to a destination.',
  behavior: 'NON_BLOCKING',
  parameters: {
    type: 'OBJECT',
    properties: {
      destination: { type: 'STRING' }
    },
    required: ['destination']
  }
};

const config = {
  responseModalities: [Modality.AUDIO],
  thinkingConfig: {
    thinkingLevel: 'low'
  },
  tools: [{ functionDeclarations: [searchFlights] }]
};

async function main() {
  const session = await ai.live.connect({
    model: model,
    config: config,
    callbacks: {
      onopen: () => console.log('Session connected'),
      onmessage: async (event) => {
        const message = JSON.parse(event.data);

        if (message.interactionStatus) {
          console.log(`Interaction status: ${message.interactionStatus}`);
        }

        if (message.toolCall) {
          for (const call of message.toolCall.functionCalls) {
            console.log(`Executing tool: ${call.name}`);
            session.sendToolResponse({
              functionResponses: [{
                id: call.id,
                name: call.name,
                response: { result: 'Flight DL 145 ($145)' }
              }]
            });
          }
        }

        if (message.interactionStatus === 'IDLE') {
          console.log('Session is idle and waiting for input.');
        }
      }
    }
  });
}

main();
Çfarë vjen më pas
- Lexoni faqet e modelit Gemini 3.8 Live dhe Gemini 3.8 Live Extended Thinking .
- Kontrolloni tabelën e krahasimit të modeleve për krahasime të hollësishme të veçorive në të gjitha modelet Live API.
- Mësoni më shumë rreth thirrjes së funksioneve në udhëzuesin e përdorimit të Live API Tool .
- Rishikoni menaxhimin e sesionit për të trajtuar rifillimin e sesionit dhe ciklin jetësor të kontekstit.