

Model Gemini Robotics ER (embodied reasoning) adalah model vision-language (VLM) yang memungkinkan robot memahami dan berinteraksi dengan dunia fisik. Model ini menafsirkan data visual, melakukan penalaran spasial dan temporal, merencanakan tugas multilangkah, serta mengorkestrasi robot dan alat.
Model
Model Gemini Robotics ER 2 adalah model terbaru di Gemini Robotics. Model penalaran terbaru kami yang memungkinkan robot memahami lingkungannya secara akurat. Model ini mengkhususkan diri dalam kemampuan penalaran yang diwujudkan, seperti orkestrasi agen robot (misalnya, menggunakan VLA), pemahaman video robot termasuk pemahaman progres dan deteksi keberhasilan, pembacaan instrumen, penunjukan, dan penalaran spasial.
Model Gemini Robotics ER 2 memperkenalkan dua endpoint model:
gemini-robotics-er-2-preview: Model ER 2 standar. Dibuat berdasarkan Gemini 3.5 Flash dengan peningkatan penalaran spasial, penemuan momen video, klasifikasi progres video, orkestrasi multi-robot, dan penggunaan alat multi-langkah.gemini-robotics-er-2-streaming-preview: Dioptimalkan untuk streaming real-time menggunakan Live API. Gunakan model ini untuk agen robot dengan latensi rendah yang memproses input audio dan video berkelanjutan.
Gemini Robotics ER 1.6 telah
tidak digunakan lagi pada 31 Agustus 2026.
Jika Anda masih menggunakan Gemini Robotics ER 1.6, upgrade ke Gemini Robotics ER 2
dengan mengganti model="gemini-robotics-er-1.6-preview" dengan
model="gemini-robotics-er-2-preview" atau
model="gemini-robotics-er-2-streaming-preview" dalam panggilan API Anda.
Coba Gemini Robotics ER 2 di Google AI Studio
Kemampuan robotika
Gemini Robotics ER mendukung berbagai kemampuan penalaran yang diwujudkan. Pilih kemampuan untuk mempelajari lebih lanjut:
| Kemampuan | Deskripsi | Panduan |
|---|---|---|
| Penalaran spasial | Menunjuk ke objek, melacaknya dalam video, mendeteksi dengan kotak pembatas, merencanakan lintasan. | Penalaran spasial |
| Visi agentic | Gunakan eksekusi kode untuk meningkatkan kemampuan lainnya dengan memanfaatkan alat manipulasi gambar. | Visi agentic |
| Orkestrasi tugas | Menggabungkan penalaran spasial dengan API robot kustom untuk menyelesaikan tugas jangka panjang. | Orkestrasi tugas |
| Streaming (khusus endpoint Streaming Gemini Robotics ER 2) | Streaming dua arah untuk agen robot real-time dengan pemanggilan fungsi berlatensi rendah. | Streaming untuk robotika |
| Progres video (khusus Gemini Robotics ER 2) | Penemuan momen dan klasifikasi progres dari feed video berkelanjutan. | Pemahaman video |
Sebelum memulai
Model ER Gemini Robotics tersedia melalui Gemini Developer API. Untuk memulai, buat kunci Gemini API dari Google AI Studio atau Konsol Google Cloud, dan siapkan lingkungan Anda.
Untuk mengetahui detail tentang jenis kunci, keamanan, dan cara mengonfigurasi kunci Anda di Python, JavaScript, dan bahasa lainnya, lihat Menggunakan kunci Gemini API.
Memulai
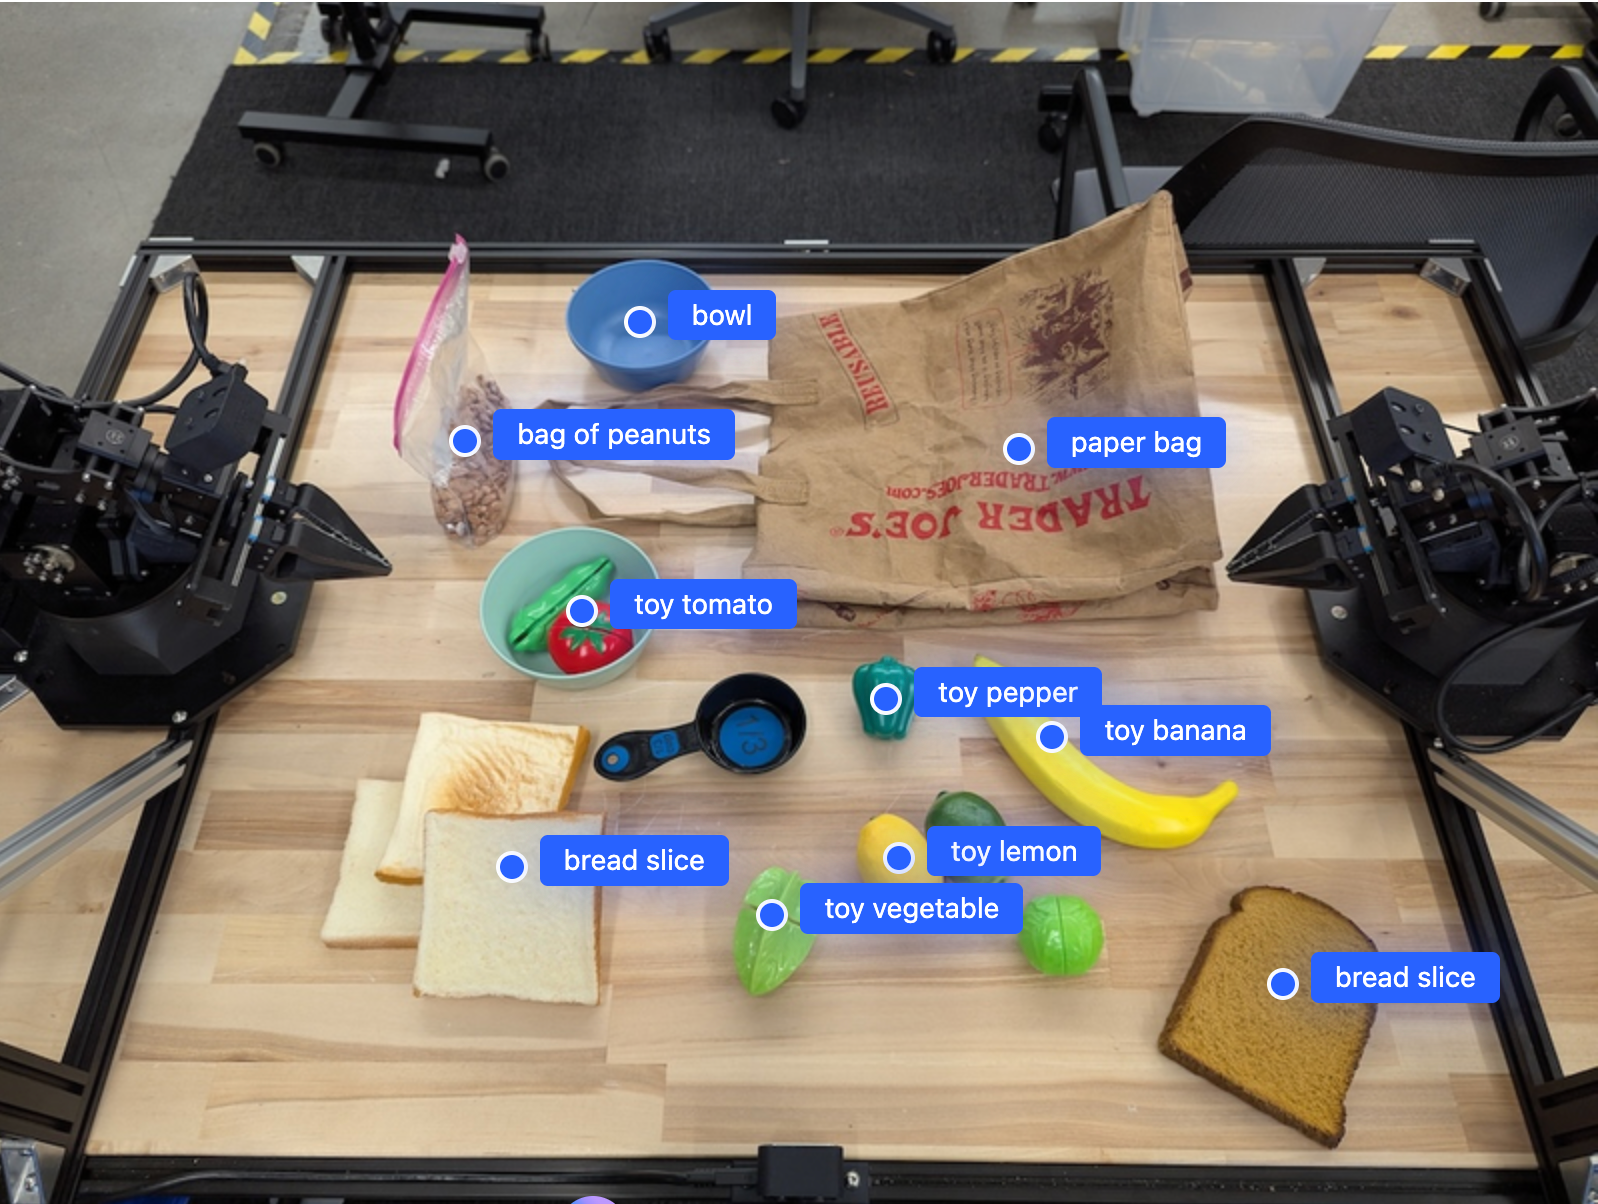
Contoh berikut menemukan objek dalam gambar dan menampilkan koordinat dan label 2D yang dinormalisasi. Anda dapat meneruskan output ini langsung ke API robotika atau model VLA untuk menghasilkan tindakan robot.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
Outputnya akan berupa array JSON yang berisi objek, masing-masing dengan point
(koordinat [y, x] yang dinormalisasi) dan label yang mengidentifikasi objek.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Gambar berikut adalah contoh cara menampilkan titik-titik ini:
Cara kerjanya
Gemini Robotics ER menerima input gambar, video, atau audio dengan perintah bahasa alami. Model ini mengidentifikasi objek, mempertimbangkan konteks adegan dan hubungan spasial, serta menampilkan output terstruktur seperti koordinat atau kotak pembatas.
Gemini Robotics ER juga bersifat agentic: model ini memecah tugas kompleks menjadi sub-tugas dan mengeksekusinya dengan memanggil fungsi robot Anda atau menjalankan kode yang dihasilkan. Misalnya, "letakkan apel di mangkuk" menjadi urutan langkah menemukan, menggenggam, dan menempatkan.
Lihat Pemanggilan fungsi untuk mengetahui detail tentang cara Gemini menjalankan panggilan alat.
Keamanan
Meskipun Gemini Robotics ER dibuat dengan mempertimbangkan keselamatan, Anda bertanggung jawab untuk menjaga lingkungan yang aman di sekitar robot. Model AI generatif dapat membuat kesalahan, dan robot fisik dapat menyebabkan kerusakan. Untuk mempelajari lebih lanjut, buka halaman keamanan Gemini Robotics.
Praktik terbaik
Gunakan bahasa yang sederhana dan alami. Jelaskan tindakan yang Anda inginkan dari robot seperti yang Anda lakukan kepada seseorang. Jika istilah tidak berfungsi, coba sinonim yang umum.
Mengoptimalkan input visual. Pangkas atau perbesar objek kecil atau tidak jelas sebelum mengirim gambar. Pencahayaan dan kontras warna yang rendah dapat memengaruhi deteksi.
Uraikan tugas yang kompleks menjadi beberapa langkah. Kirim setiap langkah sebagai perintah terpisah agar model tetap fokus dan meningkatkan akurasi.
Buat kueri beberapa kali dan hitung rata-rata hasilnya untuk tugas yang memerlukan presisi tinggi. Pendekatan konsensus ini mengurangi varians pada output spasial.
Batasan
Pertimbangkan batasan berikut saat mengembangkan dengan Gemini Robotics ER:
- Pembatasan kunci API: Gemini API tidak menerima permintaan dari kunci API yang tidak dibatasi dan menampilkan error
403 Forbidden. Amankan kunci API Anda dengan menambahkan batasan di AI Studio. Lihat Mengamankan kunci API yang tidak dibatasi untuk mengetahui detailnya. - Latensi vs performa: Kueri yang kompleks, input beresolusi tinggi, atau tingkat penalaran yang tinggi dapat menyebabkan peningkatan waktu pemrosesan. Untuk tingkat penalaran, gunakan sedang untuk keseimbangan yang baik antara latensi dan performa.
- Halusinasi: Seperti semua model bahasa besar, model ER Gemini Robotics terkadang dapat "berhalusinasi" atau memberikan informasi yang salah, terutama untuk perintah yang ambigu atau input di luar distribusi.
- Ketergantungan pada kualitas perintah: Kualitas output bergantung pada kejelasan perintah input. Gunakan perintah yang spesifik dan terstruktur dengan baik.
- Biaya komputasi: Menjalankan model, terutama dengan input video atau
thinking_budgetyang tinggi, akan menggunakan resource komputasi dan menimbulkan biaya. Lihat halaman Penalaran untuk mengetahui detail selengkapnya. - Jenis input: Lihat topik berikut untuk mengetahui detail tentang batasan untuk setiap mode.
Pemberitahuan Privasi
Anda memahami bahwa model yang dirujuk dalam dokumen ini ("Model Robotika") memanfaatkan data video dan audio untuk mengoperasikan dan menggerakkan hardware Anda sesuai dengan petunjuk Anda. Oleh karena itu, Anda dapat mengoperasikan Model Robotika sedemikian rupa sehingga data dari orang yang dapat diidentifikasi, seperti data suara, gambar, dan kemiripan ("Data Pribadi"), akan dikumpulkan oleh Model Robotika. Jika Anda memilih untuk mengoperasikan Model Robotika dengan cara yang mengumpulkan Data Pribadi, Anda setuju bahwa Anda tidak akan mengizinkan orang yang dapat diidentifikasi untuk berinteraksi dengan, atau berada di area sekitar, Model Robotika, kecuali dan hingga orang yang dapat diidentifikasi tersebut telah diberi tahu secara memadai dan menyetujui fakta bahwa Data Pribadi mereka dapat diberikan kepada dan digunakan oleh Google sebagaimana diuraikan dalam Persyaratan Layanan Tambahan Gemini API yang dapat ditemukan di https://ai.google.dev/gemini-api/terms ("Persyaratan"), termasuk sesuai dengan bagian berjudul "Cara Google Menggunakan Data Anda". Anda akan memastikan bahwa pemberitahuan tersebut mengizinkan pengumpulan dan penggunaan Data Pribadi sebagaimana diuraikan dalam Persyaratan, dan Anda akan menggunakan upaya yang wajar secara komersial untuk meminimalkan pengumpulan dan distribusi Data Pribadi dengan menggunakan teknik seperti pemburaman wajah dan mengoperasikan Model Robotika di area yang tidak berisi orang yang dapat diidentifikasi sejauh yang dapat dilakukan.
Harga
Untuk mengetahui informasi mendetail tentang harga dan region yang tersedia, lihat halaman harga.
Endpoint model
Pratinjau Gemini Robotics ER 2
| Properti | Deskripsi |
|---|---|
| Kode model | gemini-robotics-er-2-preview |
| Jenis data yang didukung |
Input Teks, gambar, video, audio Output Teks |
| Batas token[*] |
Batas token input 131.072 Batas token output 65.536 |
| Kemampuan | Tidak didukung Didukung Didukung Didukung Didukung Didukung Didukung Tidak didukung Tidak didukung Didukung Didukung Didukung Didukung |
| Opsi pemakaian |
Didukung Tidak didukung Tidak didukung |
| Versi |
|
| Pembaruan terbaru | Juli 2026 |
| Kartu model | Kartu model |
Pratinjau Streaming Gemini Robotics ER 2
| Properti | Deskripsi |
|---|---|
| Kode model | gemini-robotics-er-2-streaming-preview |
| Jenis data yang didukung |
Input Teks, gambar, video, audio Output Teks |
| Batas token[*] |
Batas token input 131.072 Batas token output 65.536 |
| Kemampuan | Tidak didukung Tidak didukung Tidak didukung Tidak didukung Tidak didukung Didukung Tidak didukung Tidak didukung Didukung Didukung Tidak didukung Didukung Tidak didukung |
| Opsi pemakaian |
Tidak didukung Tidak didukung Tidak didukung |
| Versi |
|
| Pembaruan terbaru | Juli 2026 |
| Kartu model | Kartu model |
Gemini Robotics ER 1.6 Preview
| Properti | Deskripsi |
|---|---|
| Kode model | gemini-robotics-er-1.6-preview |
| Jenis data yang didukung |
Input Teks, gambar, video, audio Output Teks |
| Batas token[*] |
Batas token input 131.072 Batas token output 65.536 |
| Kemampuan | Tidak didukung Didukung Didukung Didukung Didukung Didukung Didukung Tidak didukung Tidak didukung Didukung Didukung Didukung Didukung |
| Opsi pemakaian |
Didukung Tidak didukung Tidak didukung |
| Versi |
|
| Pembaruan terbaru | Desember 2025 |
| Batas informasi | Januari 2025 |
Langkah berikutnya
- Penalaran spasial — penunjukan, pelacakan, kotak pembatas, lintasan.
- Kemampuan agentic — eksekusi kode, pembacaan instrumen, anotasi gambar.
- Task orchestration — tugas jangka panjang dengan API robot kustom.
- Robotika dengan streaming — streaming dua arah real-time (khusus Gemini Robotics ER 2).
- Pemahaman video — menemukan momen dan klasifikasi progres (khusus Gemini Robotics ER 2).
- Keamanan Gemini Robotics — riset keamanan di balik rangkaian model ini.