

نماذج Gemini Robotics ER (الاستدلال المتجسّد) هي نماذج لغوية بصرية (VLM) تتيح للروبوتات فهم العالم المادي والتفاعل معه. فهي تفسّر البيانات المرئية، وتُجري الاستدلال المكاني والزمني، وتخطّط للمهام المتعدّدة الخطوات، وتنسّق عمل الروبوتات والأدوات.
النماذج
Gemini Robotics ER 2 هو أحدث نموذج في Gemini Robotics. وهو نموذج الاستدلال المحدَّث الذي يتيح للروبوتات فهم بيئاتها بدقة. وهو متخصّص في قدرات الاستدلال المتجسّد، مثل التنسيق الوكيل للروبوتات (على سبيل المثال، باستخدام نماذج VLA)، وفهم فيديوهات الروبوتات، بما في ذلك فهم مستوى التقدّم ورصد النجاح، وقراءة الأدوات، والإشارة، والاستدلال المكاني.
يقدّم نموذج Gemini Robotics ER 2 نقطتَي نهاية:
-
gemini-robotics-er-2-preview: نموذج ER 2 العادي يستند إلى Gemini 3.5 Flash مع تحسينات في الاستدلال المكاني، والعثور على اللحظات في الفيديو، وتصنيف مستوى تقدّم الفيديو، وتنسيق الروبوتات المتعددة، واستخدام الأدوات المتعددة الخطوات. gemini-robotics-er-2-streaming-preview: تم تحسينه للبث في الوقت الفعلي باستخدام Live API. يمكنك استخدام هذا النموذج لبرامج الروبوت التي تتطلب وقت استجابة منخفضًا وتعالج مدخلات الصوت والفيديو المستمرة.
تم إيقاف الإصدار 1.6 من Gemini Robotics ER نهائيًا في 31 أغسطس 2026.
إذا كنت لا تزال تستخدم Gemini Robotics ER 1.6، يُرجى الترقية إلى Gemini Robotics ER 2
من خلال استبدال model="gemini-robotics-er-1.6-preview" بـ
model="gemini-robotics-er-2-preview" أو
model="gemini-robotics-er-2-streaming-preview" في طلبات البيانات من واجهة برمجة التطبيقات.
تجربة Gemini Robotics ER 2 في Google AI Studio
إمكانات الروبوتات
يتيح Gemini Robotics ER مجموعة من إمكانات الاستدلال المتجسّد. اختَر إحدى الإمكانات لمعرفة المزيد:
| إمكانية | الوصف | الدليل |
|---|---|---|
| الاستدلال المكاني | يمكنك الإشارة إلى العناصر وتتبُّعها في الفيديو ورصدها باستخدام مربّعات الإحاطة وتخطيط مساراتها. | الاستدلال المكاني |
| الرؤية المستنِدة إلى الذكاء الاصطناعي الوكيل | يمكنك استخدام ميزة تنفيذ الرموز البرمجية لتحسين الإمكانات الأخرى من خلال الاستفادة من أدوات معالجة الصور. | الرؤية المستندة إلى الذكاء الاصطناعي الوكيل |
| تنظيم المهام | الجمع بين الاستدلال المكاني وواجهات برمجة التطبيقات المخصّصة للروبوتات لإكمال المهام الطويلة المدى | تنظيم المهام |
| البث (نقطة نهاية البث في Gemini Robotics ER 2 فقط) | بث ثنائي الاتجاه لوكلاء الروبوتات في الوقت الفعلي مع استدعاء الدوال بوقت استجابة منخفض | البث المباشر للروبوتات |
| تقدّم الفيديو (Gemini Robotics ER 2 فقط) | العثور على اللحظات وتصنيف مستوى التقدّم من خلاصات الفيديو المستمرة | فهم محتوى الفيديو |
قبل البدء
تتوفّر نماذج ER من Gemini Robotics من خلال Gemini Developer API. للبدء، أنشِئ مفتاح Gemini API من Google AI Studio أو Google Cloud Console، و اضبط بيئتك.
للحصول على تفاصيل حول أنواع المفاتيح والأمان وكيفية ضبط المفتاح في Python وJavaScript ولغات أخرى، يُرجى الاطّلاع على استخدام مفاتيح Gemini API.
الخطوات الأولى
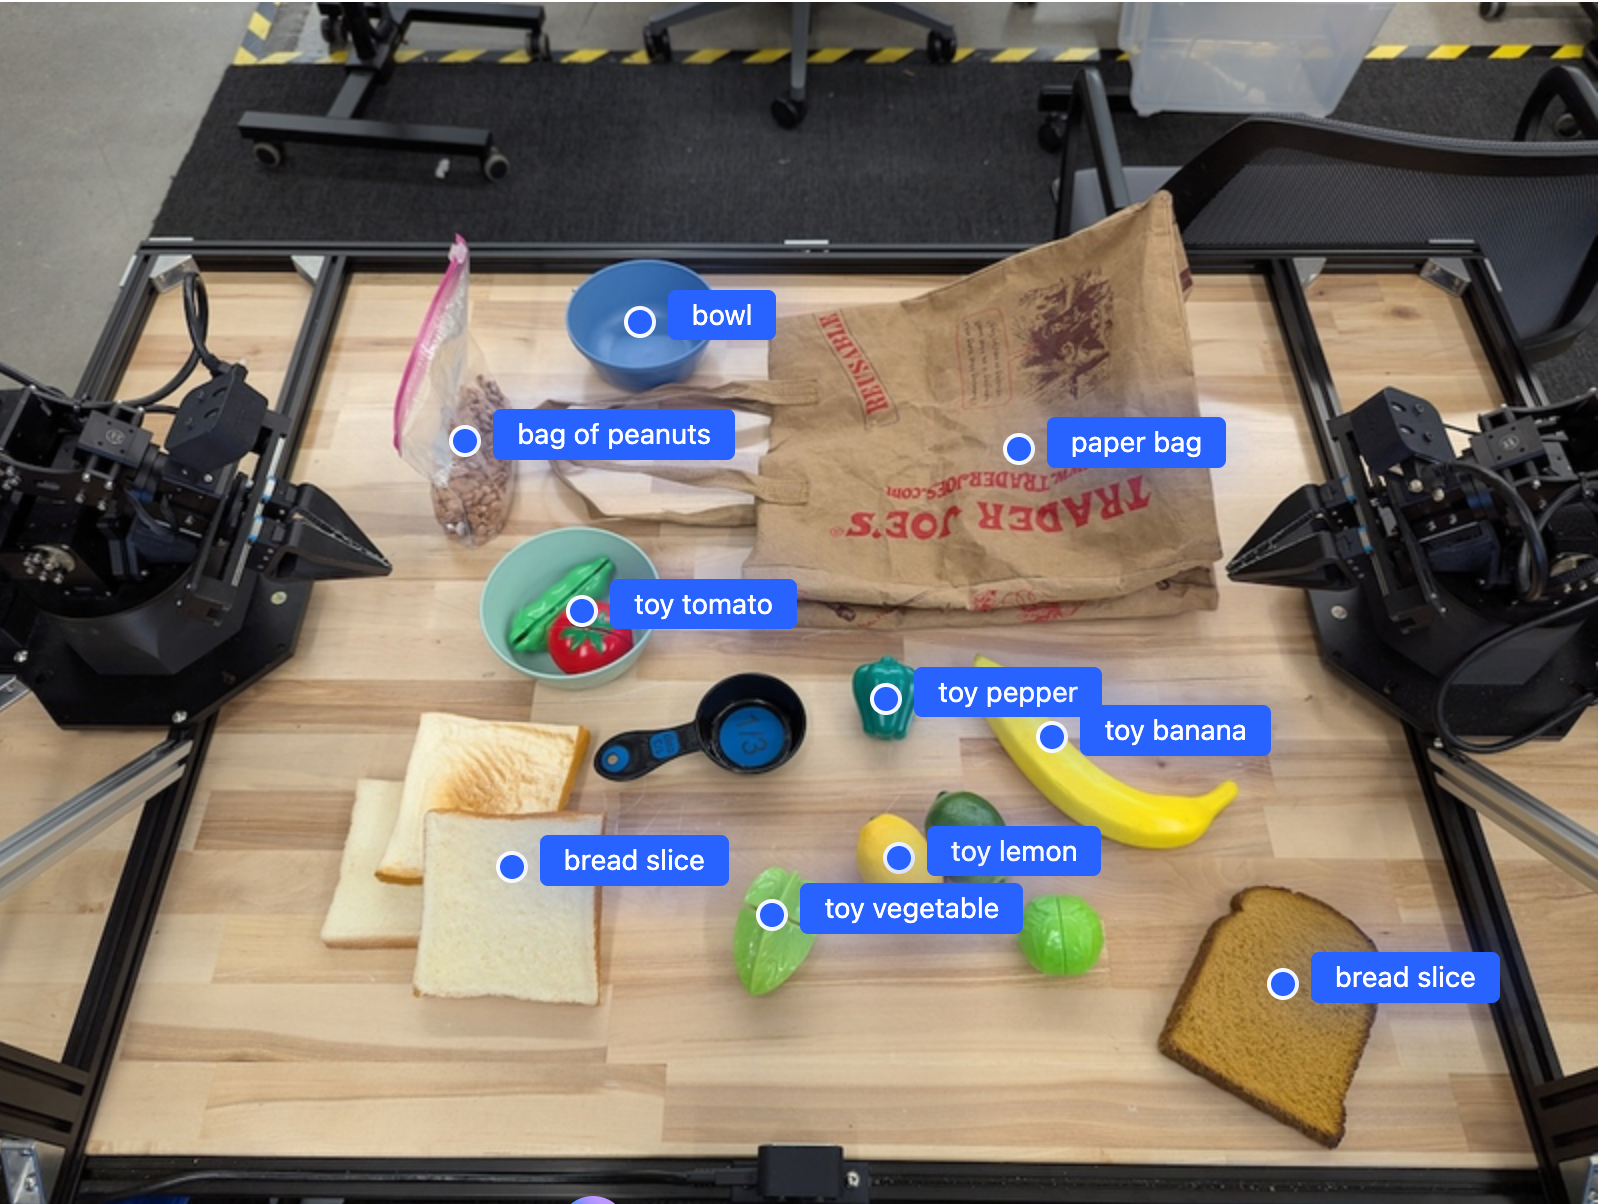
يعثر المثال التالي على العناصر في صورة ويعرض تصنيفاتها وإحداثياتها الثنائية الأبعاد التي تمّت تسويتها. يمكنك تمرير هذه النتيجة مباشرةً إلى واجهة برمجة تطبيقات للروبوتات أو نموذج VLA لإنشاء إجراءات الروبوت.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
جافا
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
ستكون النتيجة مصفوفة JSON تحتوي على عناصر، لكل منها point
(إحداثيات [y, x] التي تمّت تسويتها) وlabel يحدّد العنصر.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
تعرض الصورة التالية مثالاً على كيفية عرض هذه النقاط:
آلية العمل
يستقبل Gemini Robotics ER الصور أو الفيديوهات أو الملفات الصوتية مع طلبات باللغة الطبيعية. ويحدّد العناصر، ويستنتج سياق المشهد والعلاقات المكانية، ويعرض نتائج منظَّمة مثل الإحداثيات أو المربّعات المحيطة.
يتميّز Gemini Robotics ER أيضًا بقدرته على العمل بشكل مستقل، إذ يقسّم المهام المعقّدة إلى مهام فرعية وينفّذها من خلال استدعاء وظائف الروبوت أو تشغيل الرموز البرمجية التي تم إنشاؤها. على سبيل المثال، تصبح عبارة "ضع التفاحة في الوعاء" سلسلة من خطوات تحديد الموقع والإمساك والوضع.
يمكنك الاطّلاع على استدعاء الدوال للحصول على تفاصيل حول كيفية تنفيذ Gemini لطلبات الأدوات.
الأمان
على الرغم من أنّ Gemini Robotics ER تم تصميمه مع مراعاة السلامة، تقع على عاتقك مسؤولية الحفاظ على بيئة آمنة حول الروبوت. قد ترتكب نماذج الذكاء الاصطناعي التوليدي أخطاءً، وقد تتسبّب الروبوتات المادية في حدوث أضرار. لمزيد من المعلومات، يُرجى الانتقال إلى صفحة أمان Gemini Robotics.
أفضل الممارسات
استخدِم اللغة الطبيعية. صِف ما تريد أن يفعله الروبوت كما لو كنت تصفه لشخص. إذا لم تنجح عبارة معيّنة، جرِّب مرادفًا شائعًا.
تحسين الإدخال المرئي اقتصّ العناصر الصغيرة أو غير الواضحة أو كبِّرها قبل إرسال الصورة. يمكن أن تؤثر الإضاءة وتباين الألوان المنخفض في عملية الرصد.
قسِّم المهام المعقّدة إلى خطوات. أرسِل كل خطوة كطلب منفصل للحفاظ على تركيز النموذج وتحسين الدقة.
إرسال الطلب عدة مرات وحساب متوسط النتائج للمهام التي تتطلّب دقة عالية يقلّل نهج الإجماع هذا من التباين في المخرجات المكانية.
القيود
يُرجى مراعاة القيود التالية عند التطوير باستخدام Gemini Robotics ER:
- القيود المفروضة على مفتاح واجهة برمجة التطبيقات: لا تقبل واجهة Gemini API الطلبات من مفاتيح واجهة برمجة التطبيقات غير المقيّدة، وتعرض الخطأ
403 Forbidden. يمكنك تأمين مفتاح واجهة برمجة التطبيقات من خلال إضافة قيود في AI Studio. لمعرفة التفاصيل، يُرجى الاطّلاع على تأمين مفاتيح واجهة برمجة التطبيقات غير المقيَّدة. - وقت الاستجابة مقابل الأداء: يمكن أن تؤدي الطلبات المعقّدة أو المدخلات العالية الدقة أو مستويات التفكير العالية إلى زيادة أوقات المعالجة. بالنسبة إلى مستوى التفكير، ننصحك باستخدام المستوى المتوسط لتحقيق توازن جيد بين وقت الاستجابة والأداء.
- الهلوسة: مثل جميع النماذج اللغوية الكبيرة، يمكن أن "تهلوس" نماذج Gemini Robotics ER أحيانًا أو تقدّم معلومات غير صحيحة، خاصةً في الطلبات الغامضة أو الإدخالات غير المألوفة.
- الاعتماد على جودة الطلب: تعتمد جودة النتائج على مدى وضوح الطلب المُدخل. استخدِم طلبات محدّدة ومنظَّمة بشكل جيد.
- تكلفة الحوسبة: يؤدي تشغيل النموذج، خاصةً مع إدخالات الفيديو أو
قيم
thinking_budgetالعالية، إلى استهلاك موارد الحوسبة وتحمُّل تكاليف. لمزيد من التفاصيل، يُرجى الاطّلاع على صفحة التفكير. - أنواع الإدخال: يمكنك الاطّلاع على المواضيع التالية للحصول على تفاصيل حول القيود المفروضة على كل وضع.
إشعار الخصوصية
أنت تقرّ بأنّ النماذج المُشار إليها في هذا المستند ("نماذج الروبوتات") تستفيد من بيانات الفيديو والصوت لتشغيل وتحريك أجهزتك وفقًا لتعليماتك. وبالتالي، يمكنك تشغيل "نماذج الروبوتات" بطريقة تتيح لها جمع بيانات من أشخاص يمكن التعرّف عليهم، مثل بيانات الصوت والصور والتشابه ("البيانات الشخصية"). إذا اخترت تشغيل "نماذج الروبوتات" بطريقة تجمع "البيانات الشخصية"، فإنّك توافق على عدم السماح لأي أشخاص يمكن التعرّف عليهم بالتفاعل مع "نماذج الروبوتات" أو التواجد في المنطقة المحيطة بها، ما لم يتم إبلاغ هؤلاء الأشخاص بشكل كافٍ بأنّه قد يتم تقديم "بياناتهم الشخصية" إلى Google واستخدامها من قِبلها كما هو موضّح في "بنود الخدمة الإضافية لواجهة Gemini API" المتاحة على الرابط https://ai.google.dev/gemini-api/terms ("البنود")، بما في ذلك وفقًا للقسم الذي يحمل عنوان "كيف تستخدم Google بياناتك". وعليك التأكّد من أنّ هذا الإشعار يسمح بجمع "البيانات الشخصية" واستخدامها على النحو الموضّح في "البنود"، وعليك بذل جهود معقولة تجاريًا للحدّ من جمع "البيانات الشخصية" وتوزيعها باستخدام تقنيات مثل تمويه الوجوه وتشغيل "نماذج الروبوتات" في مناطق لا تحتوي على أشخاص يمكن التعرّف عليهم إلى أقصى حدّ ممكن.
الأسعار
للحصول على معلومات تفصيلية حول الأسعار والمناطق التي تتوفّر فيها الخدمة، يُرجى الرجوع إلى صفحة الأسعار.
نقاط نهاية النموذج
النسخة الحصرية من Gemini Robotics ER 2
| الموقع | الوصف |
|---|---|
| رمز الطراز | gemini-robotics-er-2-preview |
| أنواع البيانات المتوافقة |
الإدخالات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| الحدود القصوى للرموز المميّزة[*] |
الحد الأقصى لعدد الرموز المميّزة للإدخال 131,072 الحد الأقصى لعدد الرموز المميّزة الناتجة 65,536 |
| الإمكانات | غير متاح متاح متاح متاح متاح متاح متاح غير متاح غير متاح متاح متاح متاح متاح |
| خيارات الاستهلاك |
متاح غير متاح غير متاح |
| الإصدارات |
|
| آخر تعديل | يوليو 2026 |
| بطاقة النموذج | بطاقة النموذج |
Gemini Robotics ER 2 Streaming Preview
| الموقع | الوصف |
|---|---|
| رمز الطراز | gemini-robotics-er-2-streaming-preview |
| أنواع البيانات المتوافقة |
الإدخالات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| الحدود القصوى للرموز المميّزة[*] |
الحد الأقصى لعدد الرموز المميّزة للإدخال 131,072 الحد الأقصى لعدد الرموز المميّزة الناتجة 65,536 |
| الإمكانات | غير متاح غير متاح غير متاح غير متاح غير متاح متاح غير متاح غير متاح متاح متاح غير متاح متاح غير متاح |
| خيارات الاستهلاك |
غير متاح غير متاح غير متاح |
| الإصدارات |
|
| آخر تعديل | يوليو 2026 |
| بطاقة النموذج | بطاقة النموذج |
النسخة الحصرية من Gemini Robotics ER 1.6
| الموقع | الوصف |
|---|---|
| رمز الطراز | gemini-robotics-er-1.6-preview |
| أنواع البيانات المتوافقة |
الإدخالات النصوص والصور والفيديوهات والمحتوى الصوتي الناتج نص |
| الحدود القصوى للرموز المميّزة[*] |
الحد الأقصى لعدد الرموز المميّزة للإدخال 131,072 الحد الأقصى لعدد الرموز المميّزة الناتجة 65,536 |
| الإمكانات | غير متاح متاح متاح متاح متاح متاح متاح غير متاح غير متاح متاح متاح متاح متاح |
| خيارات الاستهلاك |
متاح غير متاح غير متاح |
| الإصدارات |
|
| آخر تعديل | ديسمبر 2025 |
| تاريخ آخر تحديث للبيانات | يناير 2025 |
الخطوات التالية
- الاستدلال المكاني: الإشارة والتتبُّع ومربّعات الإحاطة والمسارات
- إمكانات بالذكاء الاصطناعي الوكيل: تنفيذ الرموز البرمجية، وقراءة الأدوات، وإضافة التعليقات التوضيحية إلى الصور.
- تنظيم المهام: مهام طويلة المدى باستخدام واجهات برمجة تطبيقات مخصّصة للروبوتات
- الروبوتات مع البث: بث ثنائي الاتجاه في الوقت الفعلي (Gemini Robotics ER 2 فقط).
- فهم الفيديو: العثور على اللحظات وتصنيف مستوى التقدّم (في Gemini Robotics ER 2 فقط)
- أمان Gemini Robotics: أبحاث الأمان وراء مجموعة النماذج.