

Modele Gemini Robotics ER (rozumowanie w świecie fizycznym) to modele wizualno-językowe (VLM), które umożliwiają robotom postrzeganie świata fizycznego i interakcję z nim. Interpretują dane wizualne, wykonują rozumowanie przestrzenne i czasowe, planują wieloetapowe zadania oraz koordynują roboty i narzędzia.
Modele
Model Gemini Robotics ER 2 to najnowszy model w Gemini Robotics. To nasz zaktualizowany model rozumowania, który umożliwia robotom precyzyjne rozumienie otoczenia. Specjalizuje się w rozumowaniu w świecie fizycznym, które obejmuje m.in. agentową orkiestrację robotów (np. przy użyciu modeli VLA), rozumienie filmów przez roboty, w tym rozumienie postępów i wykrywanie sukcesu, odczytywanie wskazań przyrządów, wskazywanie i rozumowanie przestrzenne.
Model Gemini Robotics ER 2 wprowadza 2 punkty końcowe modelu:
gemini-robotics-er-2-preview: standardowy model ER 2. Opiera się na Gemini 3.5 Flash, ale ma ulepszone rozumowanie przestrzenne, wyszukiwanie momentów w filmach, klasyfikację postępów w filmach, koordynację wielu robotów i wieloetapowe korzystanie z narzędzi.gemini-robotics-er-2-streaming-preview: zoptymalizowany pod kątem strumieniowania w czasie rzeczywistym za pomocą interfejsu Live API. Używaj tego modelu w przypadku agentów robotów o krótkim czasie oczekiwania, które przetwarzają ciągłe dane wejściowe audio i wideo.
Model Gemini Robotics ER 1.6 został wycofany 31 sierpnia 2026 r.
Jeśli nadal używasz Gemini Robotics ER 1.6, przejdź na Gemini Robotics ER 2, zastępując model="gemini-robotics-er-1.6-preview" przez model="gemini-robotics-er-2-preview" lub model="gemini-robotics-er-2-streaming-preview" w wywołaniach interfejsu API.
Wypróbuj Gemini Robotics ER 2 w Google AI Studio
Możliwości robotyki
Gemini Robotics ER obsługuje szereg funkcji rozumowania w świecie fizycznym. Wybierz funkcję, aby dowiedzieć się więcej:
| Możliwości | Opis | Przewodnik |
|---|---|---|
| Rozumowanie przestrzenne | Wskazywanie obiektów, śledzenie ich w filmie, wykrywanie za pomocą ramek ograniczających, planowanie trajektorii. | Rozumowanie przestrzenne |
| Agentic Vision | Używaj wykonywania kodu, aby ulepszać inne funkcje za pomocą narzędzi do manipulowania obrazami. | Wizja agentowa |
| Aranżacja zadań | Połącz rozumowanie przestrzenne z niestandardowymi interfejsami API robotów, aby wykonywać długofalowe zadania. | Aranżacja zadań |
| Streaming (tylko punkt końcowy Gemini Robotics ER 2 Streaming) | Dwukierunkowe strumieniowanie dla agentów robotów w czasie rzeczywistym z wywoływaniem funkcji z krótkim czasem oczekiwania. | Strumieniowe przesyłanie danych na potrzeby robotyki |
| Postęp odtwarzania filmu (tylko Gemini Robotics ER 2) | Wykrywanie momentów i klasyfikacja postępów na podstawie ciągłych strumieni wideo. | Rozumienie filmów |
Zanim zaczniesz
Modele Gemini Robotics ER są dostępne przez Gemini Developer API. Aby rozpocząć, utwórz klucz interfejsu Gemini API w Google AI Studio lub konsoli Google Cloud i skonfiguruj środowisko.
Szczegółowe informacje o typach kluczy, zabezpieczeniach i konfigurowaniu klucza w Pythonie, JavaScript i innych językach znajdziesz w artykule Korzystanie z kluczy interfejsu Gemini API.
Pierwsze kroki
W tym przykładzie wykrywane są obiekty na obrazie i zwracane są ich znormalizowane współrzędne 2D oraz etykiety. Możesz przekazać te dane wyjściowe bezpośrednio do interfejsu API robotyki lub modelu VLA, aby wygenerować działania robota.
Python
from google import genai

PROMPT = """
          Point to no more than 10 items in the image. The label returned
          should be an identifying name for the object detected.
          The answer should follow the json format: [{"point": <point>,
          "label": <label1>}, ...]. The points are in [y, x] format
          normalized to 0-1000.
        """
client = genai.Client()

uploaded_file = client.files.upload(file="my-image.png")

image_response = client.interactions.create(
    model="gemini-robotics-er-2-preview",
    input=[
        {
            "type": "image",
            "uri": uploaded_file.uri,
            "mime_type": uploaded_file.mime_type
        },
        {"type": "text", "text": PROMPT}
    ],
    generation_config={"thinking_level": "high"},
)

print(image_response.output_text)
JavaScript
import { GoogleGenAI } from "@google/genai";

const PROMPT = `
  Point to no more than 10 items in the image. The label returned
  should be an identifying name for the object detected.
  The answer should follow the json format: [{"point": <point>,
  "label": <label1>}, ...]. The points are in [y, x] format
  normalized to 0-1000.
`;
const client = new GoogleGenAI();

const uploadedFile = await client.files.upload({ file: "my-image.png" });

const imageResponse = await client.interactions.create({
  model: "gemini-robotics-er-2-preview",
  input: [
    {
      type: "image",
      uri: uploadedFile.uri,
      mime_type: uploadedFile.mimeType,
    },
    { type: "text", text: PROMPT },
  ],
  generation_config: { thinking_level: "high" },
});

console.log(imageResponse.output_text);
Java
import com.google.genai.Client;
import com.google.genai.gaos.models.interactions.Content;
import com.google.genai.gaos.models.interactions.CreateModelInteraction;
import com.google.genai.gaos.models.interactions.GenerationConfig;
import com.google.genai.gaos.models.interactions.ImageContent;
import com.google.genai.gaos.models.interactions.ImageContentMimeType;
import com.google.genai.gaos.models.interactions.Interaction;
import com.google.genai.gaos.models.interactions.InteractionsInput;
import com.google.genai.gaos.models.interactions.Model;
import com.google.genai.gaos.models.interactions.TextContent;
import com.google.genai.gaos.models.interactions.ThinkingLevel;
import com.google.genai.gaos.models.operations.CreateInteractionRequestBody;
import com.google.genai.types.File;
import com.google.genai.types.UploadFileConfig;
import java.util.List;

Client client = new Client();

String prompt =
    "Point to no more than 10 items in the image. The label returned "
        + "should be an identifying name for the object detected. "
        + "The answer should follow the json format: [{\"point\": <point>, "
        + "\"label\": <label1>}, ...]. The points are in [y, x] format "
        + "normalized to 0-1000.";

File uploadedFile =
    client.files.upload(
        new java.io.File("my-image.png"),
        UploadFileConfig.builder().mimeType("image/png").build());

Content imageContent =
    ImageContent.builder()
        .uri(uploadedFile.uri().orElse(""))
        .mimeType(ImageContentMimeType.of(uploadedFile.mimeType().orElse("image/png")))
        .build();
Content textContent = TextContent.builder().text(prompt).build();

CreateModelInteraction params =
    CreateModelInteraction.builder()
        .model(Model.of("gemini-robotics-er-2-preview"))
        .input(InteractionsInput.ofContent(List.of(imageContent, textContent)))
        .generationConfig(
            GenerationConfig.builder().thinkingLevel(ThinkingLevel.HIGH).build())
        .build();

Interaction imageResponse =
    client.interactions.create(CreateInteractionRequestBody.of(params)).interaction().get();

System.out.println(imageResponse.outputText().orElse(""));
Go
package main

import (
    "context"
    "fmt"
    "log"

    "google.golang.org/genai"
    "google.golang.org/genai/interactions/models/interactions"
    "google.golang.org/genai/interactions/models/operations"
)

func main() {
    ctx := context.Background()
    client, err := genai.NewClient(ctx, nil)
    if err != nil {
        log.Fatal(err)
    }

    prompt := `Point to no more than 10 items in the image. The label returned
should be an identifying name for the object detected.
The answer should follow the json format: [{"point": <point>,
"label": <label1>}, ...]. The points are in [y, x] format
normalized to 0-1000.`

    uploadedFile, err := client.Files.UploadFromPath(ctx, "my-image.png", &genai.UploadFileConfig{
        MIMEType: "image/png",
    })
    if err != nil {
        log.Fatal(err)
    }

    res, err := client.Interactions.Create(ctx, operations.CreateInteractionRequest{
        Body: operations.NewCreateInteractionRequestBody(interactions.CreateModelInteraction{
            Model: interactions.Model("gemini-robotics-er-2-preview"),
            Input: interactions.NewInteractionsInput([]interactions.Content{
                interactions.NewContent(interactions.ImageContent{
                    URI:      genai.Ptr(uploadedFile.URI),
                    MimeType: genai.Ptr(interactions.ImageMimeTypeImagePng),
                }),
                interactions.NewContent(interactions.TextContent{
                    Text: prompt,
                }),
            }),
            GenerationConfig: &interactions.GenerationConfig{
                ThinkingLevel: interactions.ThinkingLevelHigh.ToPointer(),
            },
        }),
    })
    if err != nil {
        log.Fatal(err)
    }
    if res.Interaction.OutputText != nil {
        fmt.Println(*res.Interaction.OutputText)
    }
}
REST
# First, ensure you have the image file locally.
# Encode the image to base64
IMAGE_BASE64=$(base64 -w 0 my-image.png)

curl -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-robotics-er-2-preview",
    "input": {
      "parts": [
        {
          "inlineData": {
            "mimeType": "image/png",
            "data": "'"${IMAGE_BASE64}"'"
          }
        },
        {
          "text": "Point to no more than 10 items in the image. The label returned should be an identifying name for the object detected. The answer should follow the json format: [{\"point\": [y, x], \"label\": <label1>}, ...]. The points are in [y, x] format normalized to 0-1000."
        }
      ]
    },
    "generation_config": {
      "thinking_config": {
        "thinking_level": "high"
      }
    }
  }'
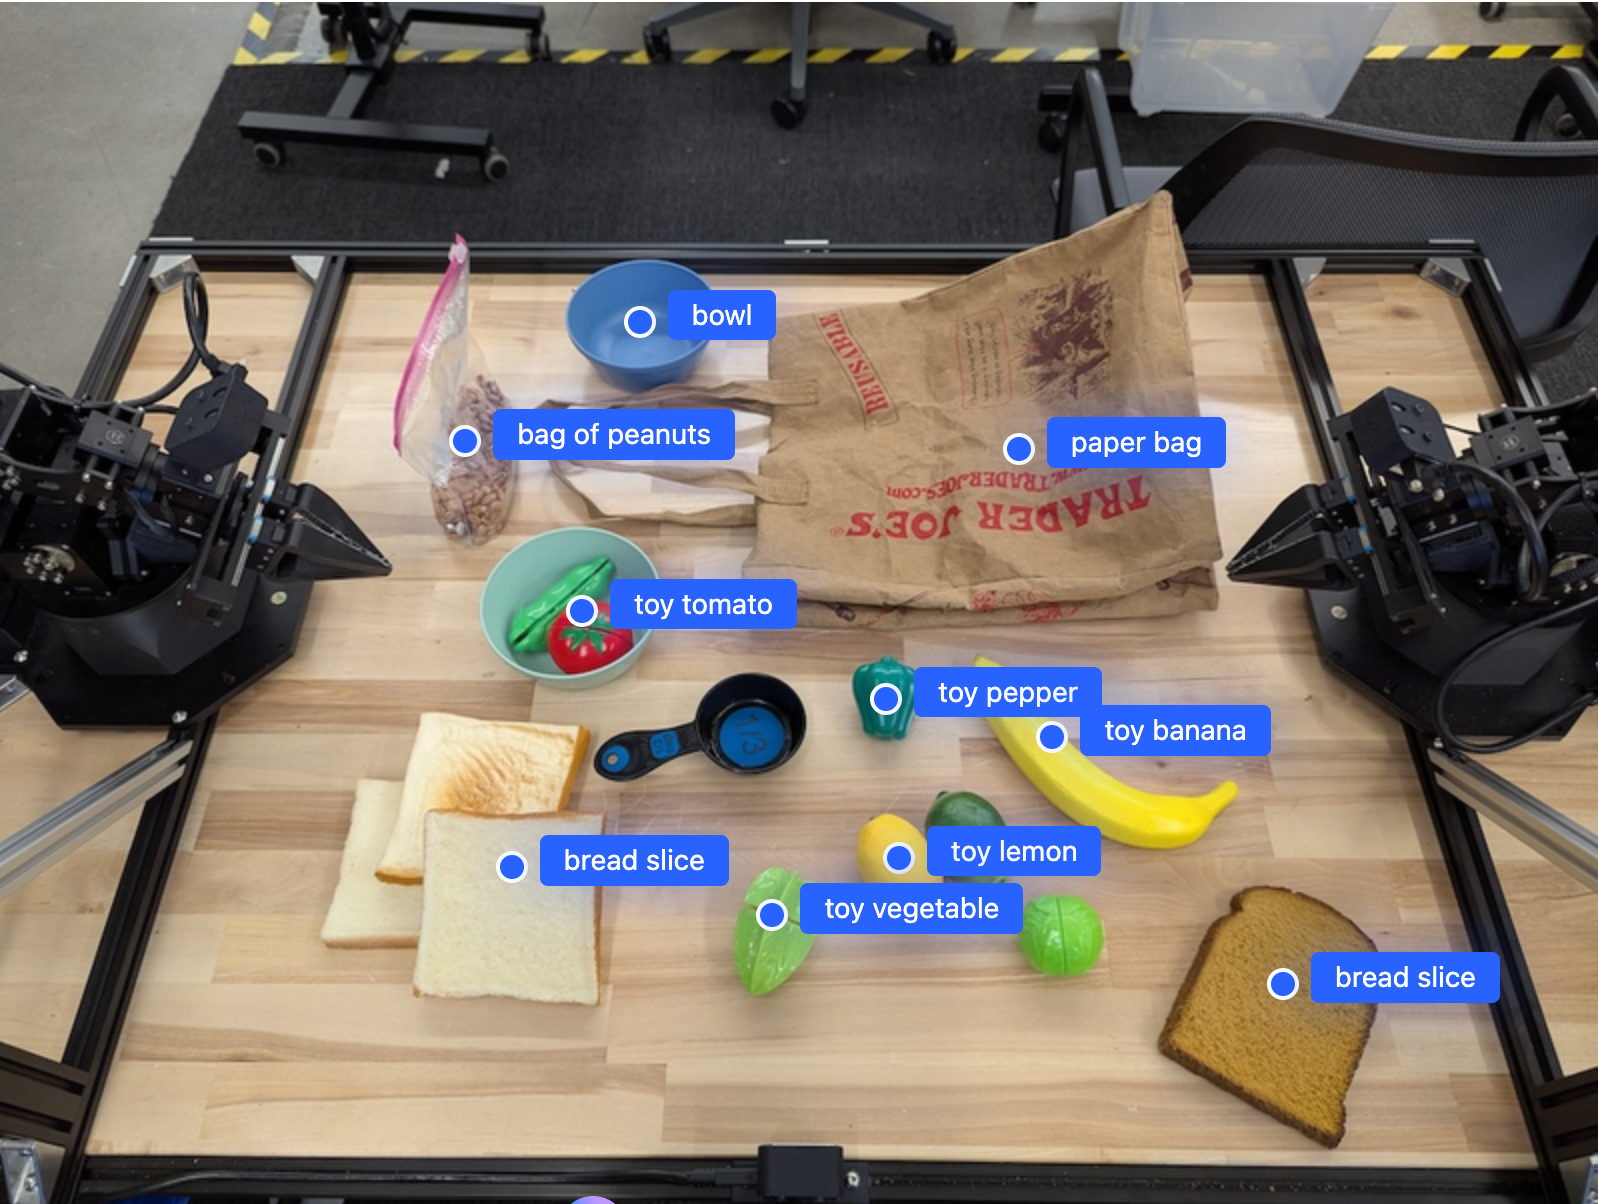
Dane wyjściowe będą tablicą JSON zawierającą obiekty, z których każdy będzie miał point (znormalizowane współrzędne [y, x]) i label identyfikujący obiekt.
JSON
[
  {"point": [376, 508], "label": "small banana"},
  {"point": [287, 609], "label": "larger banana"},
  {"point": [223, 303], "label": "pink starfruit"},
  {"point": [435, 172], "label": "paper bag"},
  {"point": [270, 786], "label": "green plastic bowl"},
  {"point": [488, 775], "label": "metal measuring cup"},
  {"point": [673, 580], "label": "dark blue bowl"},
  {"point": [471, 353], "label": "light blue bowl"},
  {"point": [492, 497], "label": "bread"},
  {"point": [525, 429], "label": "lime"}
]
Poniższy obraz przedstawia przykład wyświetlania tych punktów:
Jak to działa
Gemini Robotics ER przyjmuje dane wejściowe w postaci obrazu, filmu lub dźwięku z promptami w języku naturalnym. Identyfikuje obiekty, analizuje kontekst sceny i relacje przestrzenne oraz zwraca uporządkowane dane wyjściowe, takie jak współrzędne lub ramki ograniczające.
Gemini Robotics ER działa też jak agent: dzieli złożone zadania na podzadania i wykonuje je, wywołując funkcje robota lub uruchamiając wygenerowany kod. Na przykład „włóż jabłko do miski” staje się sekwencją kroków: zlokalizuj, chwyć i umieść.
Szczegółowe informacje o tym, jak Gemini wykonuje wywołania narzędzi, znajdziesz w artykule Wywoływanie funkcji.
Bezpieczeństwo
Chociaż model Gemini Robotics ER został stworzony z myślą o bezpieczeństwie, to Ty odpowiadasz za utrzymanie bezpiecznego środowiska wokół robota. Modele generatywnej AI mogą popełniać błędy, a fizyczne roboty mogą powodować szkody. Więcej informacji znajdziesz na stronie poświęconej bezpieczeństwu Gemini Robotics.
Sprawdzone metody
Używaj prostego, języka naturalnego. Opisz, co robot ma zrobić, tak jakbyś mówił do człowieka. Jeśli dany termin nie działa, spróbuj użyć popularnego synonimu.
Zoptymalizuj dane wizualne. Przed wysłaniem obrazu przytnij go lub powiększ małe lub niewyraźne obiekty. Oświetlenie i niski kontrast kolorów mogą wpływać na wykrywanie.
Podziel skomplikowane zadania na etapy. Wyślij każdy krok jako osobny prompt, aby model mógł się skupić i zwiększyć dokładność.
W przypadku zadań wymagających dużej precyzji wykonaj zapytanie kilka razy i uśrednij wyniki. Takie podejście oparte na konsensusie zmniejsza rozbieżności w wynikach przestrzennych.
Ograniczenia
Podczas programowania z użyciem Gemini Robotics ER weź pod uwagę te ograniczenia:
- Ograniczenia klucza interfejsu API: interfejs Gemini API nie akceptuje żądań z nieograniczonych kluczy interfejsu API i zwraca błąd
403 Forbidden. Zabezpiecz klucz interfejsu API, dodając ograniczenia w AI Studio. Szczegółowe informacje znajdziesz w artykule Zabezpieczanie kluczy interfejsu API bez ograniczeń. - Czas oczekiwania a wydajność: złożone zapytania, dane wejściowe o wysokiej rozdzielczości lub wysokie poziomy rozumowania mogą wydłużyć czas przetwarzania. W przypadku poziomu myślenia użyj średniego, aby uzyskać dobrą równowagę między czasem oczekiwania a wydajnością.
- Halucynacje: podobnie jak wszystkie duże modele językowe, modele Gemini Robotics ER mogą czasami „halucynować” lub podawać nieprawidłowe informacje, zwłaszcza w przypadku niejednoznacznych promptów lub danych wejściowych spoza rozkładu.
- Zależność od jakości prompta: jakość wygenerowanych treści zależy od przejrzystości prompta wejściowego. Używaj konkretnych, dobrze ustrukturyzowanych promptów.
- Koszt obliczeniowy: uruchomienie modelu, zwłaszcza z danymi wejściowymi w postaci filmów lub z wysoką wartością
thinking_budget, zużywa zasoby obliczeniowe i generuje koszty. Więcej informacji znajdziesz na stronie Myślenie. - Typy danych wejściowych: szczegółowe informacje o ograniczeniach dotyczących poszczególnych trybów znajdziesz w poniższych tematach.
Informacje na temat ochrony prywatności
Przyjmujesz do wiadomości, że modele, o których mowa w tym dokumencie („Modele robotyki”), wykorzystują dane wideo i audio do działania i poruszania sprzętem zgodnie z Twoimi instrukcjami. W związku z tym możesz obsługiwać Modele robotyki w taki sposób, że będą one zbierać dane dotyczące możliwych do rozpoznania osób, takie jak głos, obrazy i podobieństwo („Dane osobowe”). Jeśli zdecydujesz się korzystać z Modeli robotyki w sposób, który umożliwia zbieranie Danych osobowych, zgadzasz się, że nie zezwolisz żadnym możliwym do rozpoznania osobom na interakcję z Modelami robotyki ani na przebywanie w ich pobliżu, chyba że takie osoby zostaną odpowiednio poinformowane o tym, że ich Dane osobowe mogą być przekazywane Google i wykorzystywane przez Google zgodnie z Dodatkowymi warunkami korzystania z usługi interfejsu Gemini API dostępnymi na stronie https://ai.google.dev/gemini-api/terms („Warunki”), w tym zgodnie z sekcją „Jak Google wykorzystuje Twoje dane”, i wyrażą na to zgodę. Zapewnisz, że takie powiadomienie będzie zezwalać na zbieranie i wykorzystywanie Danych osobowych zgodnie z Warunkami. Dołożysz też uzasadnionych ekonomicznie starań, aby zminimalizować zbieranie i rozpowszechnianie Danych osobowych, stosując techniki takie jak rozmywanie twarzy i obsługując Modele robotyki w obszarach, w których nie ma możliwych do rozpoznania osób, w zakresie, w jakim jest to możliwe.
Ceny
Szczegółowe informacje o cenach i dostępnych regionach znajdziesz na stronie z cenami.
Punkty końcowe modelu
Gemini Robotics ER 2 (wersja testowa)
| Właściwość | Opis |
|---|---|
| Kod modelu | gemini-robotics-er-2-preview |
| Obsługiwane typy danych |
Dane wejściowe Tekst, obrazy, filmy, dźwięk Dane wyjściowe Tekst |
| Limity tokenów[*] |
Limit tokenów wejściowych 131 072 Limit tokenów wyjściowych 65 536 |
| Możliwości | Nieobsługiwane Zapisywanie w pamięci podręcznej Obsługiwane Obsługiwane Obsługiwane Obsługiwane Obsługiwane Powiązanie ze źródłami informacji przy użyciu Map Google Obsługiwane Nieobsługiwane Nieobsługiwane Obsługiwane Obsługiwane Obsługiwane Obsługiwane |
| Opcje wykorzystania |
Obsługiwane Nieobsługiwane Nieobsługiwane |
| Wersje |
|
| Ostatnia aktualizacja | Lipiec 2026 r. |
| Karta modelu | Karta modelu |
Gemini Robotics ER 2 Streaming Preview
| Właściwość | Opis |
|---|---|
| Kod modelu | gemini-robotics-er-2-streaming-preview |
| Obsługiwane typy danych |
Dane wejściowe Tekst, obrazy, filmy, dźwięk Dane wyjściowe Tekst |
| Limity tokenów[*] |
Limit tokenów wejściowych 131 072 Limit tokenów wyjściowych 65 536 |
| Możliwości | Nieobsługiwane Zapisywanie w pamięci podręcznej Nieobsługiwane Nieobsługiwane Nieobsługiwane Nieobsługiwane Obsługiwane Powiązanie ze źródłami informacji przy użyciu Map Google Nieobsługiwane Nieobsługiwane Obsługiwane Obsługiwane Nieobsługiwane Obsługiwane Nieobsługiwane |
| Opcje wykorzystania |
Nieobsługiwane Nieobsługiwane Nieobsługiwane |
| Wersje |
|
| Ostatnia aktualizacja | Lipiec 2026 r. |
| Karta modelu | Karta modelu |
Gemini Robotics ER 1.6 (wersja testowa)
| Właściwość | Opis |
|---|---|
| Kod modelu | gemini-robotics-er-1.6-preview |
| Obsługiwane typy danych |
Dane wejściowe Tekst, obrazy, filmy, dźwięk Dane wyjściowe Tekst |
| Limity tokenów[*] |
Limit tokenów wejściowych 131 072 Limit tokenów wyjściowych 65 536 |
| Możliwości | Nieobsługiwane Zapisywanie w pamięci podręcznej Obsługiwane Obsługiwane Obsługiwane Obsługiwane Obsługiwane Powiązanie ze źródłami informacji przy użyciu Map Google Obsługiwane Nieobsługiwane Nieobsługiwane Obsługiwane Obsługiwane Obsługiwane Obsługiwane |
| Opcje wykorzystania |
Obsługiwane Nieobsługiwane Nieobsługiwane |
| Wersje |
|
| Ostatnia aktualizacja | Grudzień 2025 r. |
| Granica wiedzy | Styczeń 2025 r. |
Co dalej?
- Rozumowanie przestrzenne – wskazywanie, śledzenie, ramki ograniczające, trajektorie.
- Funkcje agentowe – wykonywanie kodu, odczytywanie instrumentów, adnotacje do obrazów.
- Aranżacja zadań – długofalowe zadania z niestandardowymi interfejsami API robotów.
- Robotyka z transmisją strumieniową – dwukierunkowa transmisja strumieniowa w czasie rzeczywistym (tylko Gemini Robotics ER 2).
- Rozumienie filmów – znajdowanie momentów i klasyfikacja postępów (tylko Gemini Robotics ER 2).
- Bezpieczeństwo Gemini Robotics – badania nad bezpieczeństwem modeli z tej rodziny.