

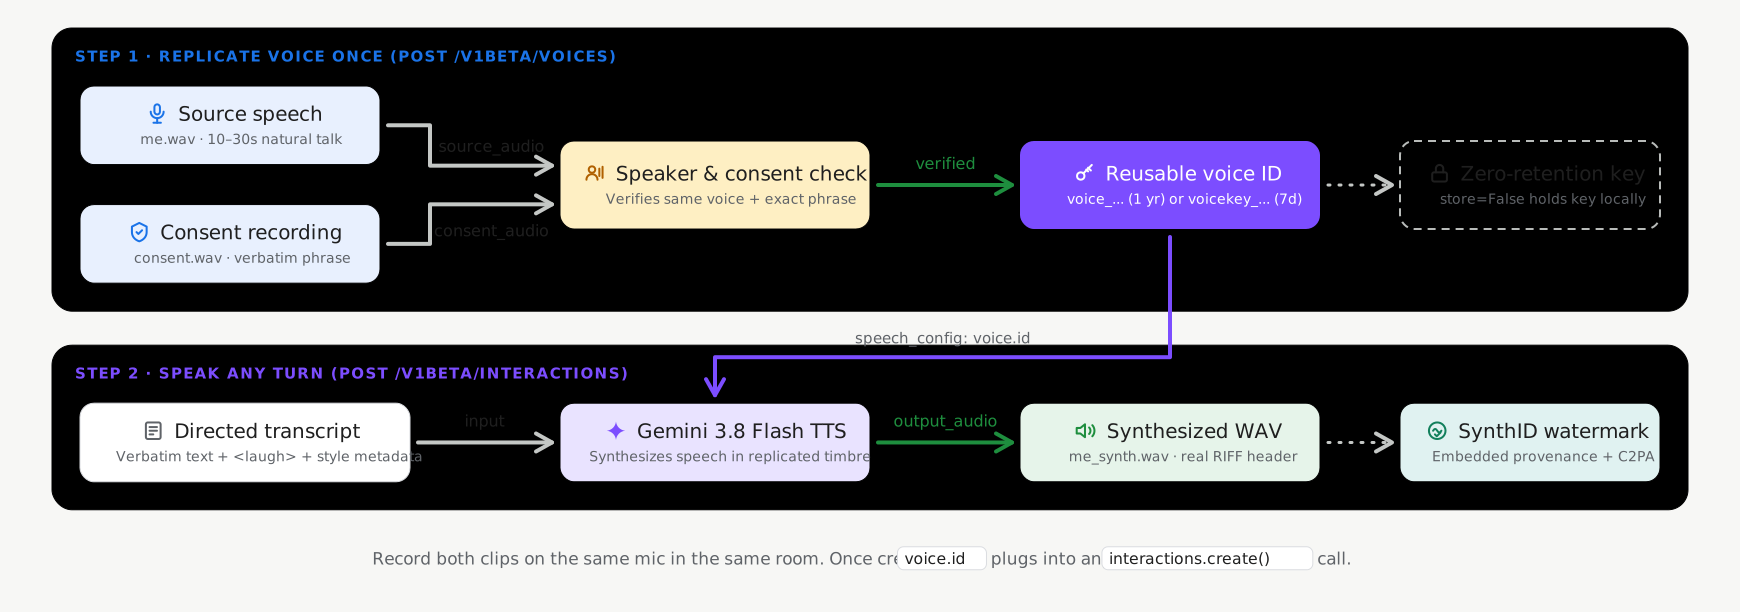
רפליקציה של קולות מאפשרת לשכפל את המאפיינים הקוליים של דובר מדגימת אודיו קצרה באמצעות נקודת הקצה Voices של Gemini API (POST /v1beta/voices). רפליקציה של קולות נתמכת גם ב-Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) וגם ב-Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts).
הדרך הכי מהירה לשכפל קול, לאמת את ההסכמה ולבדוק את הקול המשוכפל היא באמצעות חוויית שכפול הקול האינטראקטיבית ב-Google AI Studio. אתם יכולים להקליט או להעלות קטעי אודיו של הפניה והסכמה ישירות בדפדפן, לראות תצוגה מקדימה של הקול ולהעתיק את מזהה הקול שנוצר voice_... ישירות לקוד האפליקציה.
מצבי אחסון עם שמירת מצב לעומת מצבי אחסון ללא שמירת מצב
רפליקציה של קולות תומכת בשני מצבי אחסון כשמתקשרים אל voices.create (POST /v1beta/voices), ואחסון עם שמירת מצב מופעל כברירת מחדל:
- אחסון עם שמירת מצב (
store=True, מומלץ כברירת מחדל): Google מאחסנת את פרופיל הקול המאומת בפרויקט ומחזירהvoice_idקל משקל ומתמשך (replicated_voice.id, כמוvoice_abc123...). אפשר להעביר את הvoice_idהזה בין בקשות ולנהל אותו באמצעותvoices.list(),voices.get()ו-voices.delete(). - מפתחות ללא שמירת מצב שמנוהלים על ידי הלקוח (
store=False, אופציונלי): כדי להגדיר עומסי עבודה שבהם לא נדרשת התמדה בצד השרת של פרופילים ביומטריים של קול, מגדירים אתstore=False. ה-API מחזירvoice_keyמוצפן (replicated_voice.key, החל מ-voicekey_...) שהאפליקציה שלכם מאחסנת באופן מקומי ומעבירה ישירות בבקשות סינתזה.
| מצב אחסון | מזהה | מגבלת הפרויקטים | שמירה (TTL) |
|---|---|---|---|
קולות עם מצב (store=True) |
voice_... |
200 קולות לכל פרויקט (משותפים בין קולות שנוצרו מהנחיות וקולות ששוכפלו) | שנה אחת |
מקשי קול ללא מצב (store=False) |
voicekey_... |
בניהול של לקוח | 7 ימים |
דרישות לגבי אודיו והדרישות לקבלת הסכמה
כל בקשת שכפולCreateVoice צריכה לכלול שתי הקלטות אודיו של בני אדם אמיתיים
מאותו דובר בוגר (מומלץ להשתמש ב-WAV במונו 24kHz 16-bit):
- אודיו להשוואה (
source_audio): קליפ באורך 10-30 שניות של דיבור טבעי ונקי של הדובר שאת הקול שלו רוצים לשכפל. - אודיו להסכמה (
consent_audio): הקלטה של אותו דובר שאומר בבירור את הצהרת ההסכמה הנדרשת באחת מהשפות הנתמכות (לדוגמה, בעברית): > "אני הבעלים של הקול הזה ואני מסכים ש-Google תשתמש בקול הזה כדי ליצור מודל קול סינתטי".
יצירת קול משוכפל (ברירת מחדל עם שמירת מצב)
משתמשים ב-Google GenAI SDK (google-genai 2.25.0+ / @google/genai 2.24.0+) או ב-API בארכיטקטורת REST עם store=True כדי ליצור ולשמור פרופיל קולי משוכפל בפרויקט:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
סינתזת דיבור באמצעות העתק של הקול שלכם
מעבירים את הערך id (voice_...) שמוחזר בבקשת הסינתזה:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
REST
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
ניהול קולות משוכפלים מאוחסנים
כשיוצרים קולות משוכפלים באמצעות store=True, אפשר לראות אותם, לסנן אותם, לבדוק אותם ולמחוק אותם דרך Voices API (למידע על כל פרמטרי הסינון, אפשר לעיין במאמר Extended Voice Library and filtering).
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
REST
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
אפשרות: מפתחות קוליים בניהול הלקוח ללא שמירת מצב (store=False)
אם האפליקציה שלכם לא יכולה לשמור פרופילים קוליים בצד השרת, צריך להגדיר את הערך store=False כשיוצרים את הקול המשוכפל. ה-API מחזיר מחרוזת מוצפנת של voice_key (replicated_voice.key, שמתחילה ב-voicekey_...) שאתם מאחסנים בצד הלקוח ומעבירים ישירות לכל מקום שבו מתקבל מזהה voice:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
REST
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
ביטויי הסכמה נתמכים לפי שפה
האודיו להבעת הסכמה צריך לכלול הקראה ברורה של ההצהרה המדויקת באחד מ-30 הלוקאלים של השפות הנתמכות:
| שפה | לוקאל (lang_id) |
הצהרת הסכמה מילולית |
|---|---|---|
| ערבית | ar-XA |
أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| בנגאלית | bn-IN |
আমি এই ভয়েসের মালিক এবং আমি একটি সিন্থেটিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহার করে Google-এর সাথে সম্মতি দিচ্ছি। |
| סינית (פשוטה) | zh-CN |
我拥有此声音并授权谷歌使用此声音创建语音合成模型 |
| הולנדית | nl-NL |
Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| אנגלית (ארה"ב) | en-US |
אני הבעלים של הקול הזה ואני מסכים ש-Google תשתמש בקול הזה כדי ליצור תבנית קול סינתטית. |
| אנגלית (בריטניה) | en-GB |
אני הבעלים של הקול הזה ואני מסכים/ה ש-Google תשתמש בקול הזה כדי ליצור מודל קול סינתטי. |
| אנגלית (הודו) | en-IN |
אני הבעלים של הקול הזה ואני מסכים/ה ש-Google תשתמש בקול הזה כדי ליצור מודל קול סינתטי. |
| אנגלית (אוסטרליה) | en-AU |
אני הבעלים של הקול הזה ואני מסכים ש-Google תשתמש בקול הזה כדי ליצור תבנית קול סינתטית. |
| צרפתית (צרפת) | fr-FR |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| צרפתית (קנדה) | fr-CA |
Je suis le propriétaire de cette voix et j'autorise Google à utiliser cette voix pour créer un modèle de voix synthétique. |
| גרמנית | de-DE |
Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| גוג'ארטי | gu-IN |
હું આ વોઈસનો માલિક છું અને સિન્થેટિક વોઈસ મોડલ બનાવવા માટે આ વોઈસનો ઉપયોગ કરીને google ને હું સંમતિ આપું છું |
| הינדית | hi-IN |
मैं इस आवाज का मालिक हूं और मैं सिंथेटिक आवाज मॉडल बनाने के लिए Google को इस आवाज का उपयोग करने की सहमति देता हूं |
| אינדונזית | id-ID |
Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| איטלקית | it-IT |
Sono il proprietario di questa voce e acconsento che Google la utilizzi per creare un modello di voce sintetica. |
| יפנית | ja-JP |
私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| קנאדה | kn-IN |
ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿತ ಧ್ವನಿ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| קוריאנית | ko-KR |
나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 합성 모델을 생성할 것을 허용합니다. |
| מלאיאלאם | ml-IN |
ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്തറ്റിക് വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| מראטהית | mr-IN |
मी या आवाजाचा मालक आहे आणि सिंथेटिक व्हॉइस मॉडेल तयार करण्यासाठी हा आवाज वापरण्यासाठी मी Google ला संमती देतो |
| פולנית | pl-PL |
Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| פורטוגזית (ברזיל) | pt-BR |
Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| רוסית | ru-RU |
Я являюсь владельцем этого голоса и даю согласие Google на использование этого голоса для создания модели синтетического голоса. |
| ספרדית (ספרד) | es-ES |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| ספרדית (ארה"ב) | es-US |
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética. |
| טמילית | ta-IN |
நான் இந்த குரலின் உரிமையாளர் மற்றும் செயற்கை குரல் மாதிரியை உருவாக்க இந்த குரலை பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| טלוגו | te-IN |
I am the owner of this voice and I consent to Google using this voice to create a synthetic voice model. |
| תאית | th-TH |
אני הבעלים של הקול הזה ואני מסכים ש-Google תשתמש בו כדי ליצור מודל של קול סינתטי. |
| טורקית | tr-TR |
Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| וייטנאמית | vi-VN |
Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hình giọng nói tổng hợp. |
שיטות מומלצות להקלטת אודיו להשוואה
- הקלטה בסביבה שקטה: חשוב להפחית את ההד בחדר, רעשי הרקע, המוזיקה והקולות החופפים.
- התאמה של תנאי ההקלטה: מקליטים את
source_audioואתconsent_audioבאותו מיקרופון ובאותה סביבה אקוסטית, כדי שאימות הדובר יצליח באופן מהימן. - המרת קובץ ל-WAV מונו 24kHz: כדי לקבל את התוצאות הטובות ביותר, מומלץ לבצע דגימה מחדש של קובץ האודיו לקובץ WAV מונו 24kHz PCM 16-bit לפני הקידוד.
המאמרים הבאים
- כך יוצרים פרסונות בהתאמה אישית מתיאורי טקסט.
- במדריך להמרת טקסט לדיבור אפשר לקרוא על עיצוב ברמת הפנייה, תגים מוטבעים ודיאלוג עם כמה דוברים.