

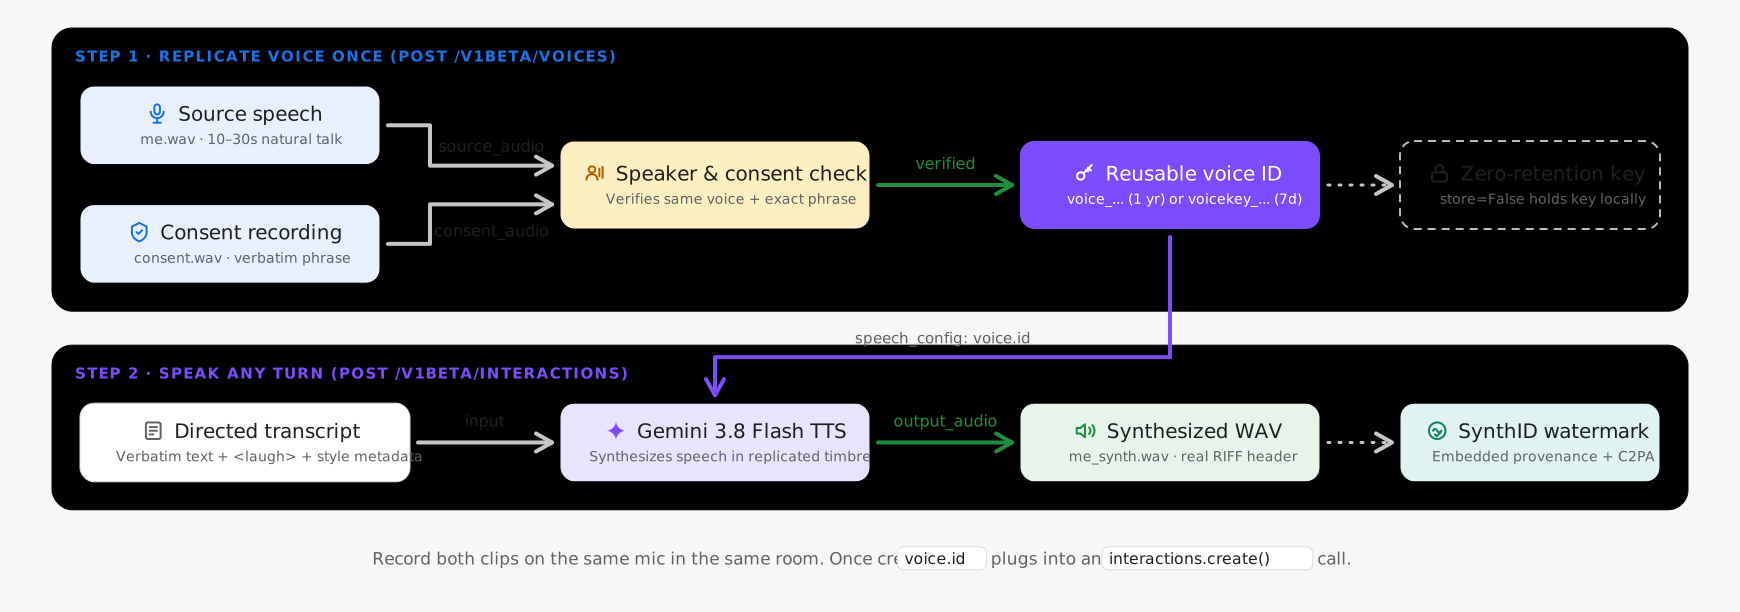
Replikimi i zërit ju lejon të replikoni karakteristikat vokale të një folësi nga një mostër e shkurtër audio duke përdorur pikën fundore të Gemini API Voices ( POST /v1beta/voices ). Si Gemini 3.8 Flash TTS ( gemini-3.8-flash-tts ) ashtu edhe Gemini 3.8 Flash-Lite TTS ( gemini-3.8-flash-lite-tts ) mbështesin replikimin e zërit.
Mënyra më e shpejtë për të replikuar, verifikuar pëlqimin dhe për të dëgjuar një zë të replikuar është me përvojën interaktive të Replikimit të Zërit në Google AI Studio . Ju mund të regjistroni ose ngarkoni klipe referimi dhe pëlqimi direkt në shfletues, të shikoni paraprakisht zërin dhe të kopjoni ID-në voice_... që rezulton direkt në kodin e aplikacionit tuaj.
Modalitetet e ruajtjes me gjendje kundrejt atyre pa gjendje
Replikimi i zërit mbështet dy mënyra ruajtjeje kur thirret voices.create ( POST /v1beta/voices ), me ruajtjen stateful të aktivizuar si parazgjedhje:
- Ruajtje me gjendje të plotë (
store=True, parazgjedhja e rekomanduar): Google ruan profilin tuaj të verifikuar të zërit në projektin tuaj dhe kthen njëvoice_idtë lehtë dhe të qëndrueshëm (replicated_voice.id, siç ështëvoice_abc123...). Mund ta kaloni këtëvoice_idnëpër kërkesa dhe ta menaxhoni atë mevoices.list(),voices.get()dhevoices.delete(). - Çelësa pa gjendje të menaxhuar nga klienti (
store=False, opsional): Për ngarkesat e punës që kërkojnë zero qëndrueshmëri nga ana e serverit të profileve biometrike të zërit, vendosnistore=False. API kthen njëvoice_keytë enkriptuar dhe të pavarur (replicated_voice.key, duke filluar mevoicekey_...) që aplikacioni juaj e ruan lokalisht dhe e kalon direkt në kërkesat e sintezës.
| Modaliteti i ruajtjes | Identifikues | Limiti i projektit | Mbajtja (TTL) |
|---|---|---|---|
Zëra shtetërorë ( store=True ) | voice_... | 200 zëra për projekt (të ndarë midis zërave të nxitur dhe të replikuar) | 1 vit |
Taste zanore pa shtetësi ( store=False ) | voicekey_... | Menaxhuar nga klienti | 7 ditë |
Kërkesat për audio dhe pëlqim
Çdo kërkesë për replikim të CreateVoice kërkon dy regjistrime audio të vërteta njerëzore nga i njëjti folës i rritur (rekomandohet WAV mono 16-bit 24kHz):
- Audio referuese (
source_audio): Një klip 10-30 sekondash me të folur të pastër dhe natyrale nga folësi, zërin e të cilit dëshironi ta replikoni. - Audio e pëlqimit (
consent_audio): Një regjistrim i të njëjtit folës që reciton qartë deklaratën e detyrueshme të pëlqimit në njërën nga gjuhët e mbështetura (për shembull, në anglisht): > "Unë jam pronari i këtij zëri dhe jap pëlqimin që Google ta përdorë këtë zë për të > krijuar një model sintetik zëri."
Krijo një zë të replikuar (parazgjedhje me gjendje statike)
Përdorni SDK-në Google GenAI ( google-genai 2.25.0+ / @google/genai 2.24.0+) ose REST API me store=True për të krijuar dhe ruajtur një profil zëri të replikuar në projektin tuaj:
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "display_name": "Custom Replicated Speaker",
        "replicated": {
            "source_audio": {
                "mime_type": "audio/wav",
                "data": source_b64,
            },
            "consent_audio": {
                "mime_type": "audio/wav",
                "data": consent_b64,
            },
        },
    },
)

print(f"Created voice ID: {replicated_voice.id}")
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
  store: true,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    display_name: "Custom Replicated Speaker",
    replicated: {
      source_audio: {
        mime_type: "audio/wav",
        data: sourceB64,
      },
      consent_audio: {
        mime_type: "audio/wav",
        data: consentB64,
      },
    },
  },
});

console.log(`Created voice ID: ${replicatedVoice.id}`);
PUSHTIM
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": true,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"display_name\": \"Custom Replicated Speaker\",
      \"replicated\": {
        \"source_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$SOURCE_B64\"
        },
        \"consent_audio\": {
          \"mime_type\": \"audio/wav\",
          \"data\": \"$CONSENT_B64\"
        }
      }
    }
  }"
Sintetizoni fjalimin me zërin tuaj të replikuar
Kaloni id në e kthyer ( voice_... ) në kërkesën tuaj të sintezës:
Python
import base64
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": (
                "Hello! This audio was synthesized using a replicated"
                " speaker voice."
            ),
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.id},
        ]
    },
)

with open("replicated_speech.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio was synthesized using a replicated speaker voice.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.id },
    ],
  },
});

fs.writeFileSync("replicated_speech.wav", Buffer.from(interaction.output_audio.data, "base64"));
PUSHTIM
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "model": "gemini-3.8-flash-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Hello! This audio was synthesized using a replicated speaker voice.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": {"type": "audio"},
    "generation_config": {
      "speech_config": [
        {"voice": "voice_YOUR_REPLICATED_VOICE_ID"}
      ]
    }
  }'
Menaxho zërat e ruajtur të replikuar
Kur krijohet me store=True , zërat tuaj të replikuar mund të listohen, filtrohen, inspektohen dhe fshihen përmes Voices API (shihni Biblioteka e Zërit e Zgjeruar dhe filtrimi për të gjithë parametrat e filtrit):
Python
from google import genai

client = genai.Client()

# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.type)

# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)

# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
JavaScript
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
  console.log(voice.id, voice.display_name, voice.type);
}

// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);

// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
PUSHTIM
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  --data-urlencode "type=replicated"

# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"

# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Opsioni: Çelësa zanorë pa shtetësi të menaxhuar nga klienti ( store=False )
Nëse aplikacioni juaj nuk kërkon qëndrueshmëri zero të profileve të zërit në anën e serverit, vendosni store=False kur krijoni zërin e replikuar. API kthen një voice_key të enkriptuar ( replicated_voice.key , duke filluar me voicekey_... ) që e ruani në anën e klientit dhe e kaloni direkt kudo që pranohet një ID voice :
Python
import base64
from google import genai

client = genai.Client()

with open("reference_speaker.wav", "rb") as f:
    source_b64 = base64.b64encode(f.read()).decode("utf-8")

with open("speaker_consent.wav", "rb") as f:
    consent_b64 = base64.b64encode(f.read()).decode("utf-8")

# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
    store=False,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "replicated",
        "replicated": {
            "source_audio": {"mime_type": "audio/wav", "data": source_b64},
            "consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
        },
    },
)

# Pass replicated_voice.key ("voicekey_...") directly as the speaker voice
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Hello! This audio uses a stateless client-managed voice key.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": replicated_voice.key},
        ]
    },
)
JavaScript
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";

const ai = new GoogleGenAI();

const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");

// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
  store: false,
  voice: {
    model: "gemini-3.8-flash-tts",
    type: "replicated",
    replicated: {
      source_audio: { mime_type: "audio/wav", data: sourceB64 },
      consent_audio: { mime_type: "audio/wav", data: consentB64 },
    },
  },
});

// Pass replicatedVoice.key ("voicekey_...") directly as the speaker voice
const interaction = await ai.interactions.create({
  model: "gemini-3.8-flash-tts",
  input: [{
    type: "user_input",
    content: [{
      type: "text",
      text: "Hello! This audio uses a stateless client-managed voice key.",
      annotations: [{
        type: "speech_metadata",
        style: "warm and conversational",
      }],
    }],
  }],
  response_format: { type: "audio" },
  generation_config: {
    speech_config: [
      { voice: replicatedVoice.key },
    ],
  },
});
PUSHTIM
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)

curl "https://generativelanguage.googleapis.com/v1beta/voices" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d "{
    \"store\": false,
    \"voice\": {
      \"model\": \"gemini-3.8-flash-tts\",
      \"type\": \"replicated\",
      \"replicated\": {
        \"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
        \"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
      }
    }
  }"
Frazat e pëlqimit të mbështetura sipas gjuhës
Audioja e pëlqimit duhet ta recitojë qartë deklaratën e saktë në njërën nga 30 gjuhët e mbështetura:
| Gjuha | Lokalizimi ( lang_id ) | Deklaratë Pëlqimi Fjalë për Fjalë |
|---|---|---|
| Arabisht | ar-XA | أنا مالك هذا الصوت وأوافق على أن تستخدم Google هذا الصوت لإنشاء نموذج صوتي اصطناعي. |
| Bengalisht | bn-IN | আমি এই ভয়েসের মালিক এবং আমি একটি সিিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্যবহা সাথে সম্মতি দিচ্ছি। |
| Kinezisht (e thjeshtuar) | zh-CN | 我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| holandez | nl-NL | Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| Anglisht (SHBA) | en-US | Unë jam pronari i këtij zëri dhe jap pëlqimin që Google ta përdorë këtë zë për të krijuar një model sintetik zëri. |
| Anglisht (MB) | en-GB | Unë jam pronari i këtij zëri dhe jap pëlqimin që Google ta përdorë këtë zë për të krijuar një model sintetik zëri. |
| Anglisht (India) | en-IN | Unë jam pronari i këtij zëri dhe jap pëlqimin që Google ta përdorë këtë zë për të krijuar një model sintetik zëri. |
| Anglisht (Australi) | en-AU | Unë jam pronari i këtij zëri dhe jap pëlqimin që Google ta përdorë këtë zë për të krijuar një model sintetik zëri. |
| Frëngjisht (Francë) | fr-FR | Je suis le propriétaire de cette voix dhe j'autorise Google à shfrytëzues cette voix pour créer un modèle de voix synthetique. |
| Frëngjisht (Kanada) | fr-CA | Je suis le propriétaire de cette voix dhe j'autorise Google à shfrytëzues cette voix pour créer un modèle de voix synthetique. |
| gjermanisht | de-DE | Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| Guxharatisht | gu-IN | હું આ વોઈસનો માલિક છું અને સિન્થેટિિ મોડલ બનાવવા માટે આ વોઈસનો ઉપનોન કરીપ હું સંમતિ Ju jeni këtu |
| Hindisht | hi-IN | मैं इस आवाज का मालिक हूं और मैं सिंथिे आवाज मॉडल बनाने के लिए को इस आवाज कोा लिए करने की सहमति देता हूं |
| Indonezisht | id-ID | Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model suara sintetis. |
| italiane | it-IT | Sono il proprietario di quest voce dhe acconsento che Google la utilizzi për krijimin e modelit të voce sintetica. |
| Japonez | ja-JP | 私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| Kannada | kn-IN | ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿಕ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| Koreane | ko-KR | 나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 구글이 이 음성을 사용하여 음성 합성 모델 허용합니다. |
| Malajalamisht | ml-IN | ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്, ഒരു സിന്്त വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം നൽകുന്നു. |
| Marathi | mr-IN | मी या आवाजाचा मालक आहे आणि सिंथेटि्कक मॉडेल तयार करण्यासाठी हा आवाज वापरण मी Google ला संमती देतो |
| polak | pl-PL | Jestem właścicielem tego głosu dhe wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| Portugalisht (Brazil) | pt-BR | Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| ruse | ru-RU | Я являюсь владельцем этого голоса и даю согласие Google për përdorimin e etogo golosa для создания модели синтетического голоса. |
| Spanjisht (Spanja) | es-ES | Soy el propietario de esta voz y doy mi consentimiento para que Google la Utilice për krijimin e modelit të voz sintética. |
| Spanjisht (SHBA) | es-US | Soy el propietario de esta voz y doy mi consentimiento para que Google la Utilice për krijimin e modelit të voz sintética. |
| Tamil | ta-IN | நான் இந்த குரலின் உரிமையாளர் மற்றுு செயற்கை குரல் மாதிரியை உருவா்க இनக இல் பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| Teluguisht | te-IN | నేను ఈ వాయిస్ యజమానిని మరియు సింతటి వాయిస్ మోడల్ ని రూపొందించడానకి ిికి ావะ ఉపయోగించడానికి googleకి నేను సమ్మతిస్తిస్తుి. |
| Tajlandeze | th-TH | në Google ใช้เสียงนี้เพื่อสร้างแ บบจำลองเสียงสังเคราะห์ |
| turk | tr-TR | Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| Vietnamez | vi-VN | Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hìhnh gi. |
Praktikat më të mira për regjistrimin e audios referuese
- Regjistro në një mjedis të qetë: Minimizo jehonën e dhomës, zhurmën në sfond, muzikën dhe zërat që mbivendosen.
- Kushtet e regjistrimit të përputhjes: Regjistroni si
source_audioashtu edheconsent_audionë të njëjtin mikrofon dhe në të njëjtin cilësim akustik në mënyrë që kontrolli i verifikimit të altoparlantit të ketë sukses të besueshëm. - Konvertoni në WAV mono 24kHz: Për rezultate më të mira, rimodeloni audion hyrëse në WAV PCM mono 16-bit 24kHz para kodimit.
Çfarë vjen më pas
- Mësoni si të krijoni personazhe të personalizuara nga përshkrimet e tekstit në Dizajnin e Zërit .
- Eksploroni stilimin sipas radhës, etiketat e integruara dhe dialogun me shumë folës në udhëzuesin Tekst-në-fjalë .